印度自研模型社死!照搬千问,仅塞提示词硬充印度造
印度自研模型社死!照搬千问,仅塞提示词硬充印度造印度AI机构169Pi宣称自研Alpie Seed 9B,但Hugging Face配置显示其基于阿里Qwen3.5-9B量化微调,仅通过提示词强塞印度身份,且引用跑分未在相同环境复测。
来自主题: AI资讯
10588 点击 2026-11-09 18:47

 搜索
印度AI机构169Pi宣称自研Alpie Seed 9B,但Hugging Face配置显示其基于阿里Qwen3.5-9B量化微调,仅通过提示词强塞印度身份,且引用跑分未在相同环境复测。
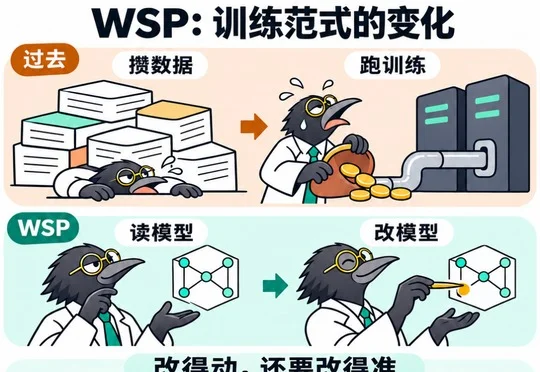
无涯智远(Norizon AI)的对照实验显示,GPT-6 Astra改动Qwen3.5-0.8B约0.016%权重虽将MATH-500得分从7.9%提至48.1%,但关闭思考模式已有48.95%,且未能稳定内化新知识、风格和技能,改权重不等于变聪明。
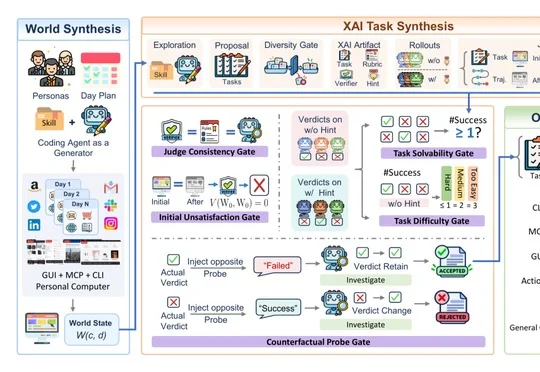
微软研究院等团队提出全开源的WildAWM,合成个人电脑环境、跨GUI/MCP/CLI任务及验证器,并训练Qwen3.6-35b-a3b和Qwen3.5-4b,两款模型在8个分布外基准上均获提升,相关环境、任务、模型与数据均已开源。
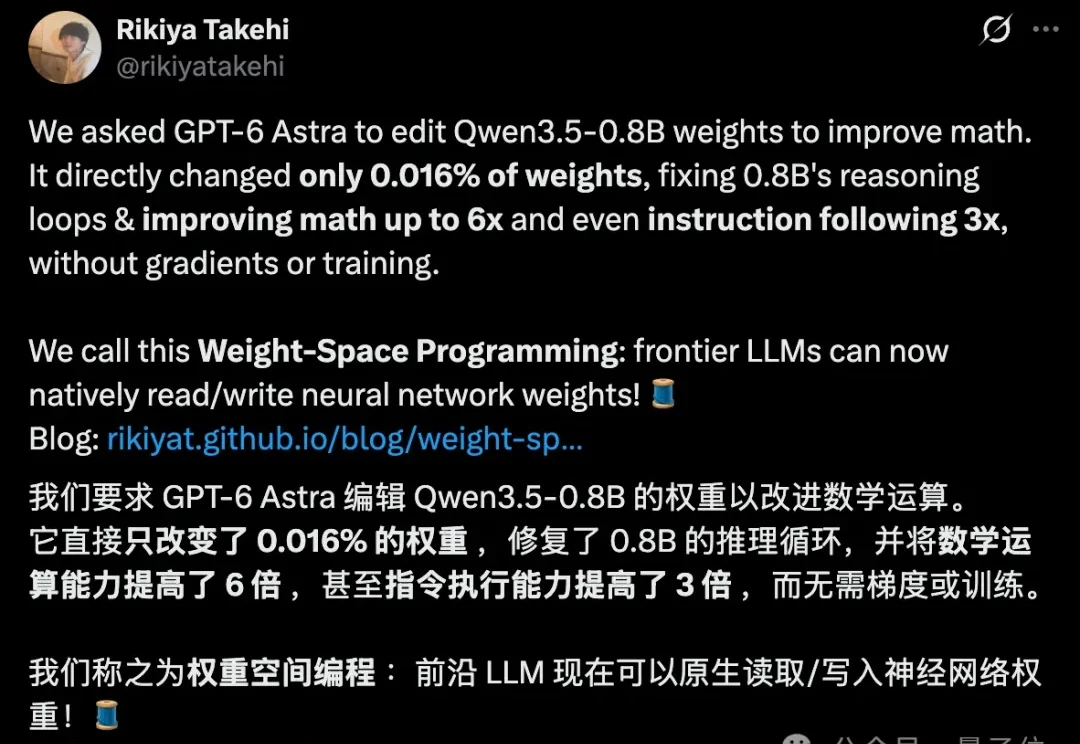
GPT-6 Astra能直接读取编辑小模型权重了。
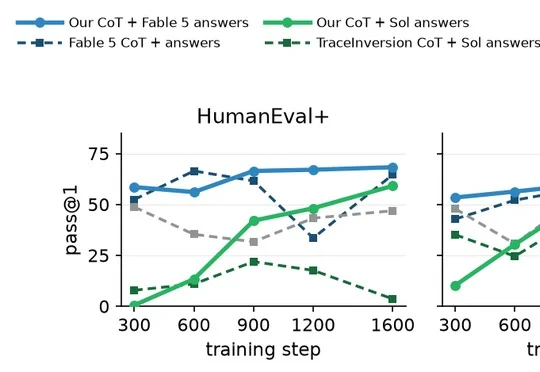
王琰在 TraceForge 技术报告中提出用同族模型合成原生思维链,在 Qwen3.5-9B-Base 实验中超过直接蒸馏 Claude Fable 5 思维链的方案,动摇闭源模型以隐藏思维链构筑的能力护城河。
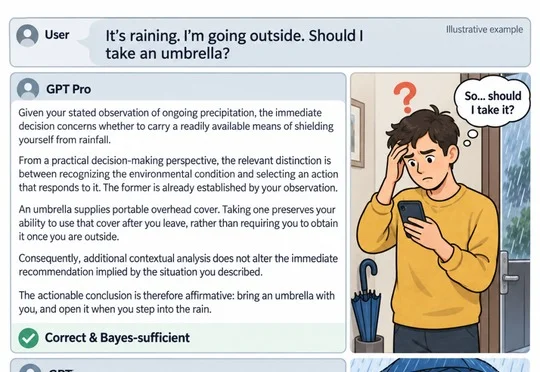
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
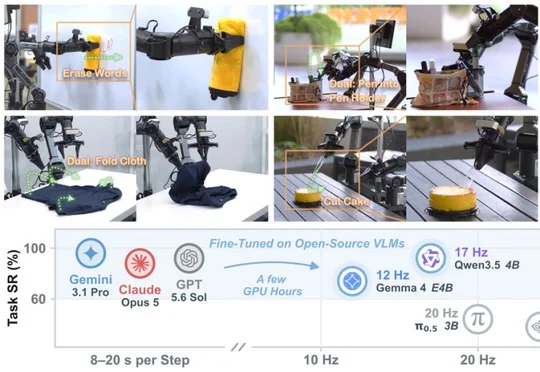
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
APUS(麒麟合盛)旗下AI实验室公开全球最早一批Jev独立开源复现成果fast-browser-use,基于Qwen3.5等开源模型在RTX PRO 6000上将单次决策压缩至79毫秒,并以9B小模型对标Jev性能。
Insilico Medicine、Liquid AI、巴克衰老研究所等机构在Cell发表论文,推出面向衰老研究的AI工具链LongevityBench、Longevity-LLMs和Longevity Claw,其中参数量仅9B的专用模型L-Qwen3.5-9B在综合排名中超越Gemini 3.1 Pro和Claude Opus 4.6。
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。