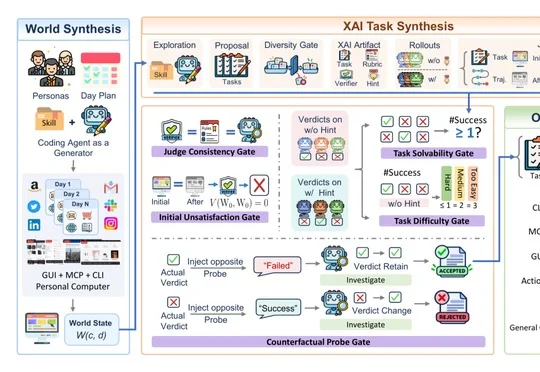
「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对
「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对微软研究院等团队提出全开源的WildAWM,合成个人电脑环境、跨GUI/MCP/CLI任务及验证器,并训练Qwen3.6-35b-a3b和Qwen3.5-4b,两款模型在8个分布外基准上均获提升,相关环境、任务、模型与数据均已开源。
来自主题: AI技术研报
7665 点击 2026-11-07 14:47

 搜索
微软研究院等团队提出全开源的WildAWM,合成个人电脑环境、跨GUI/MCP/CLI任务及验证器,并训练Qwen3.6-35b-a3b和Qwen3.5-4b,两款模型在8个分布外基准上均获提升,相关环境、任务、模型与数据均已开源。
前DeepMind AI Scientist团队创立的Inherent获5000万美元种子融资,其基于Qwen3.6-27B后训练的科研判断系统Faraday在AI for Science预留测试集上以0.791的平均得分超越Claude Opus 4.8与GPT-5.5 Codex。
近日,由清华大学深圳国际研究生院智能机器人实验室刘厚德教授领衔、王立博博士后担任 AI 首席研究员的大模型团队,正式发布了 VeriLoop Coder-E1—— 一款基于 Qwen3.6-27B 构建、面向仓库级代码修复与智能体式软件工程任务的开源垂类代码模型。
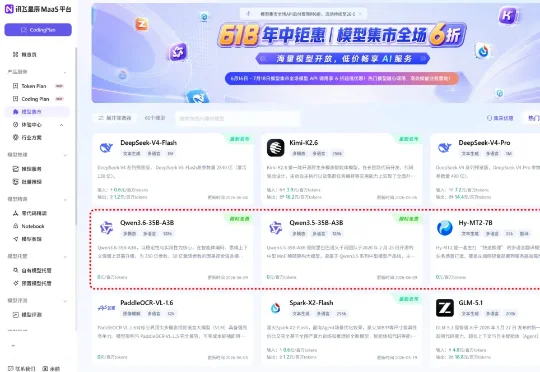
前几天听说讯飞星辰 MaaS 平台在做活动,一些模型可以限时免费调用,我第一反应就是先领了再说。这次活动限时开放了 Qwen3.6-35B-A3B 和 Qwen3.5-35B-A3B 两个模型的免费调用权益,新老用户都可以参与。
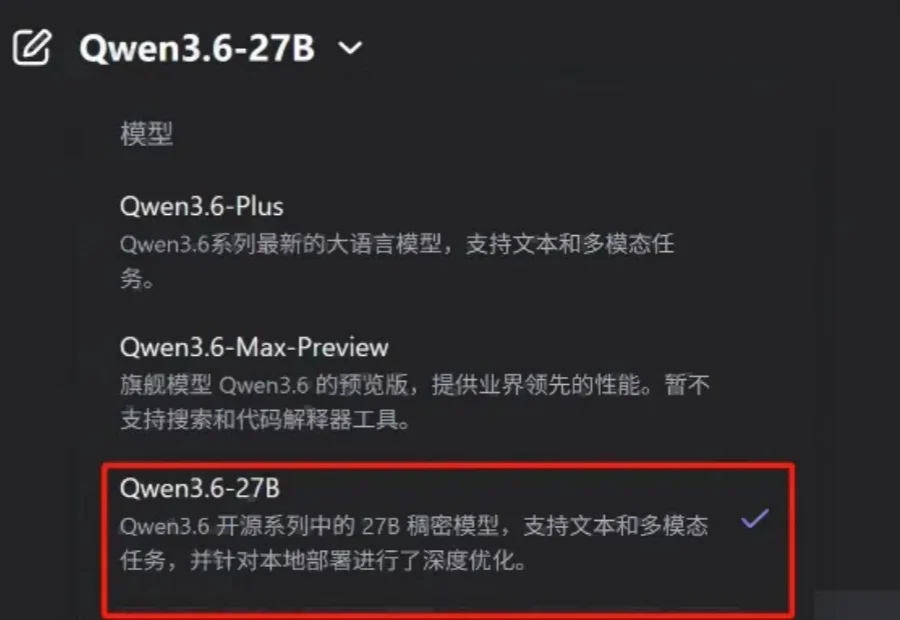
Qwen3.6系列全员集结完毕。
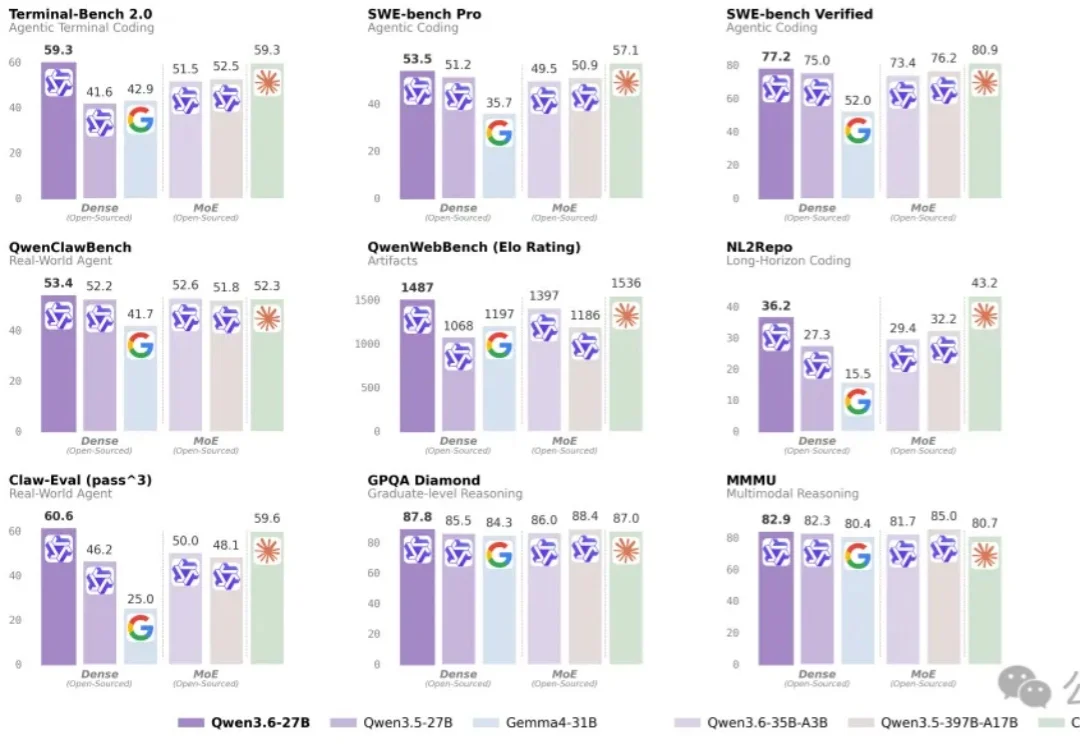
我秒了我自己??
阿里前几天开源的Qwen3.6-35B-A3B,让这次讨论不再只是一次普通的新旧模型对比。它一边要面对谷歌Gemma4-26B-A4B的外部竞争,一边又必须回答一个更麻烦的问题:相较于 Qwen3.5-35B-A3B,它到底是升级,还是修补?更现实的是,很多人现在真正跑着的,其实是Qwen3.5-27B,那么这条新的35B-A3B路线,到底值不值得迁过去。
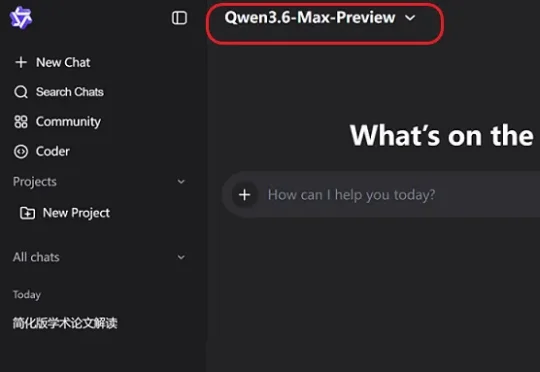
今天,阿里发布了其下一代旗舰模型的早期预览版:Qwen3.6-Max-Preview。在第三方评测榜单Artificial Analysis的智能指数排名中,Qwen3.6-Max-Preview的得分为52分,小幅超过GLM-5.1、MiniMax-M2.7,成为这一榜单上得分最高的国产模型。
3B激活参数,视觉能力直逼Claude Sonnet 4.5。
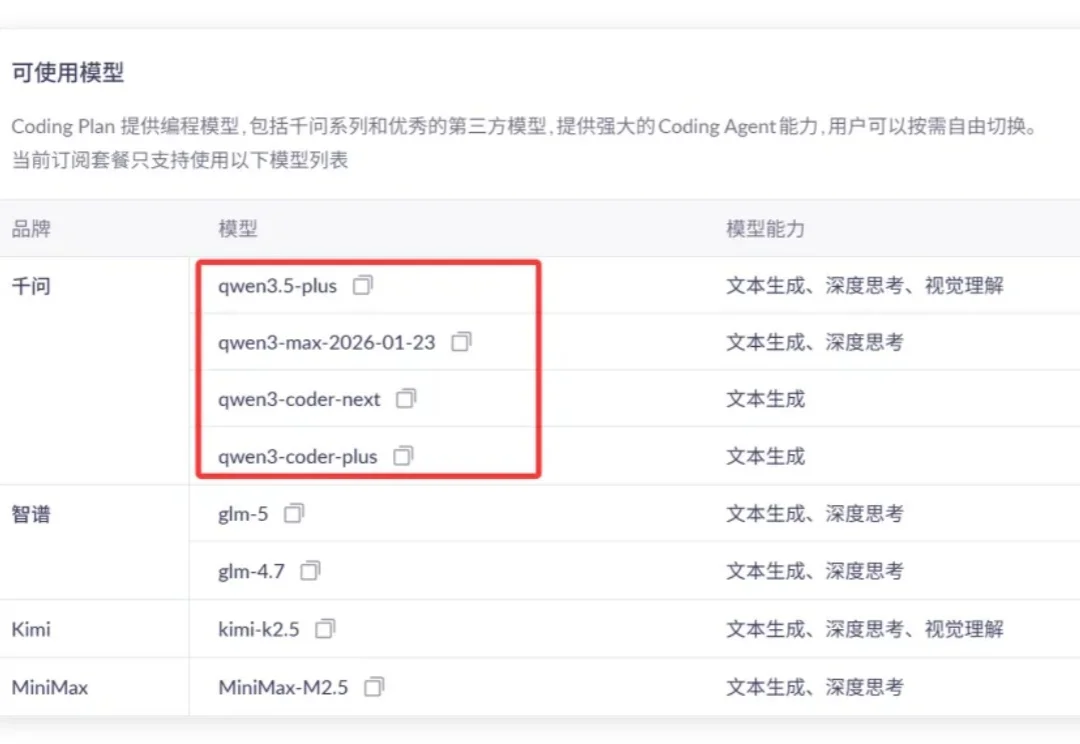
昨天我发现 Qwen3.6“倒反天罡”。