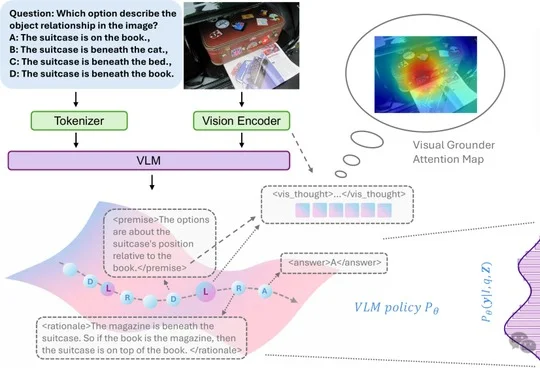
面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26
面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
来自主题: AI技术研报
7754 点击 2026-09-28 16:22

 搜索
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
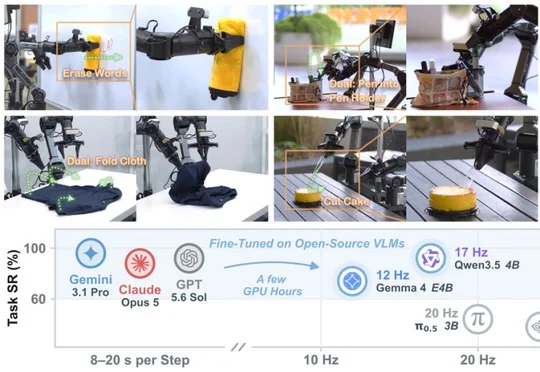
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
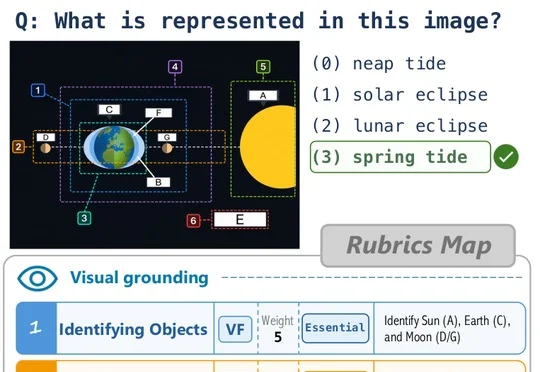
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
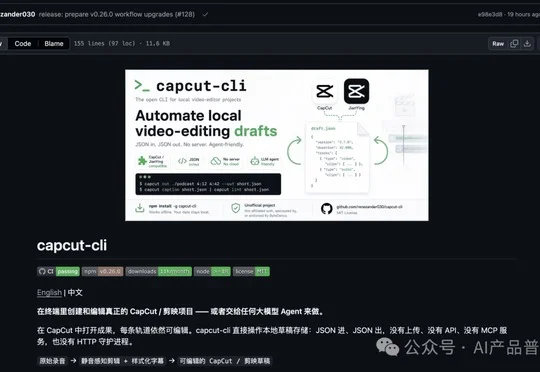
作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。
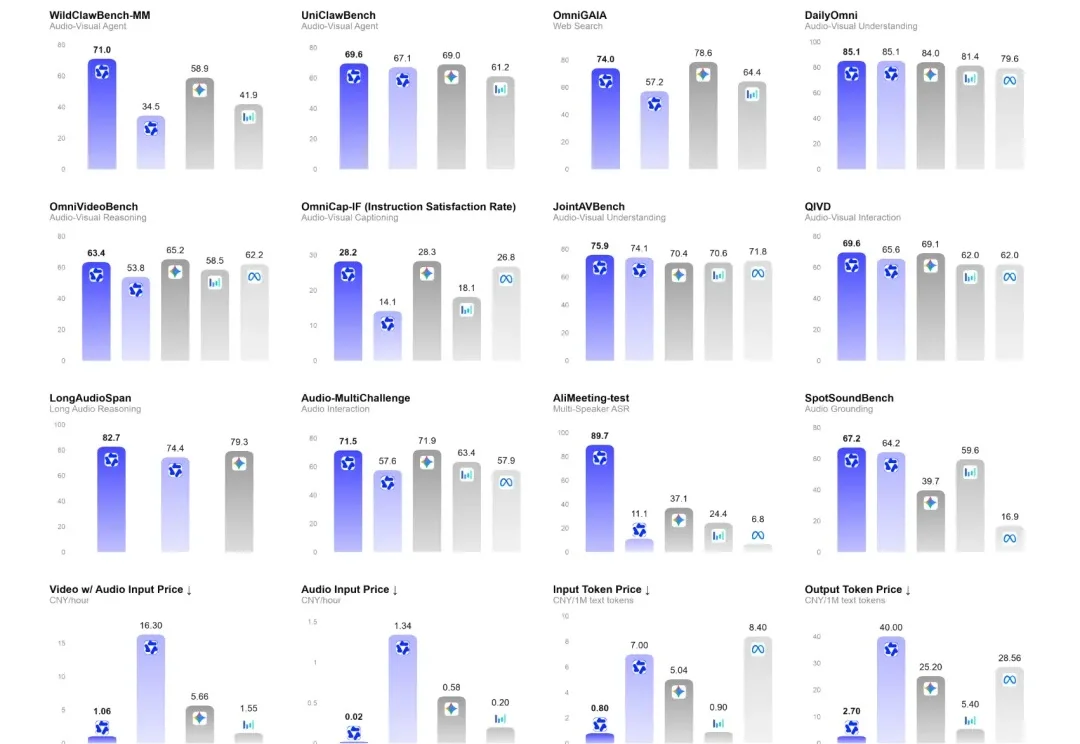
千问把全模态Agent的使用成本,直接砍掉了90%!
APUS(麒麟合盛)旗下AI实验室公开全球最早一批Jev独立开源复现成果fast-browser-use,基于Qwen3.5等开源模型在RTX PRO 6000上将单次决策压缩至79毫秒,并以9B小模型对标Jev性能。
Insilico Medicine、Liquid AI、巴克衰老研究所等机构在Cell发表论文,推出面向衰老研究的AI工具链LongevityBench、Longevity-LLMs和Longevity Claw,其中参数量仅9B的专用模型L-Qwen3.5-9B在综合排名中超越Gemini 3.1 Pro和Claude Opus 4.6。
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
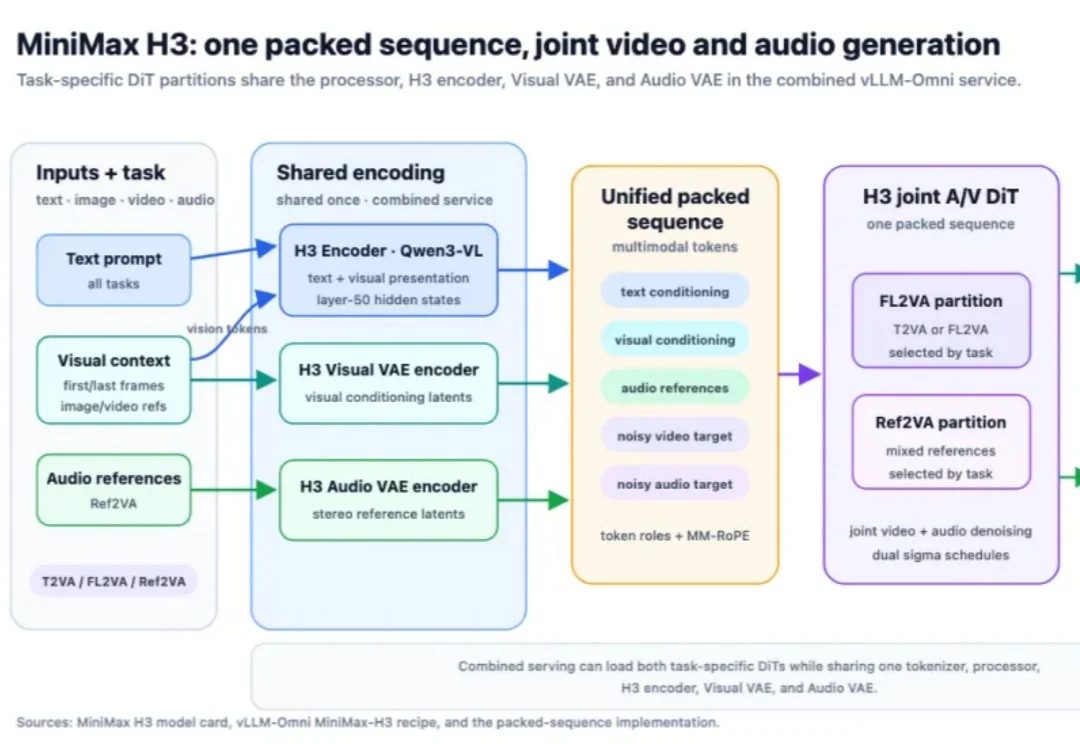
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
杭州自9月20日起向35家市级大学生创业园每人发放一张含1万积分的千问办公token卡,这是千问办公接入Qwen3.8-Max一个月后杭州首次将算力帮扶平铺到个人,标志着其AI产业思路从支持做模型的企业转变为支持用模型的人。