NeurIPS 2026|VLM架构新突破:DGP打通全部ViT与LLM层,让大模型每一层按需「看图」
NeurIPS 2026|VLM架构新突破:DGP打通全部ViT与LLM层,让大模型每一层按需「看图」论文中的一道菜单题,看起来只需要做一次简单加法:一张 Funghi 披萨 6.90 欧元,一张 Prosciutto 披萨 7.90 欧元,总价是多少?
来自主题: AI技术研报
5376 点击 2026-11-11 10:27

 搜索
论文中的一道菜单题,看起来只需要做一次简单加法:一张 Funghi 披萨 6.90 欧元,一张 Prosciutto 披萨 7.90 欧元,总价是多少?
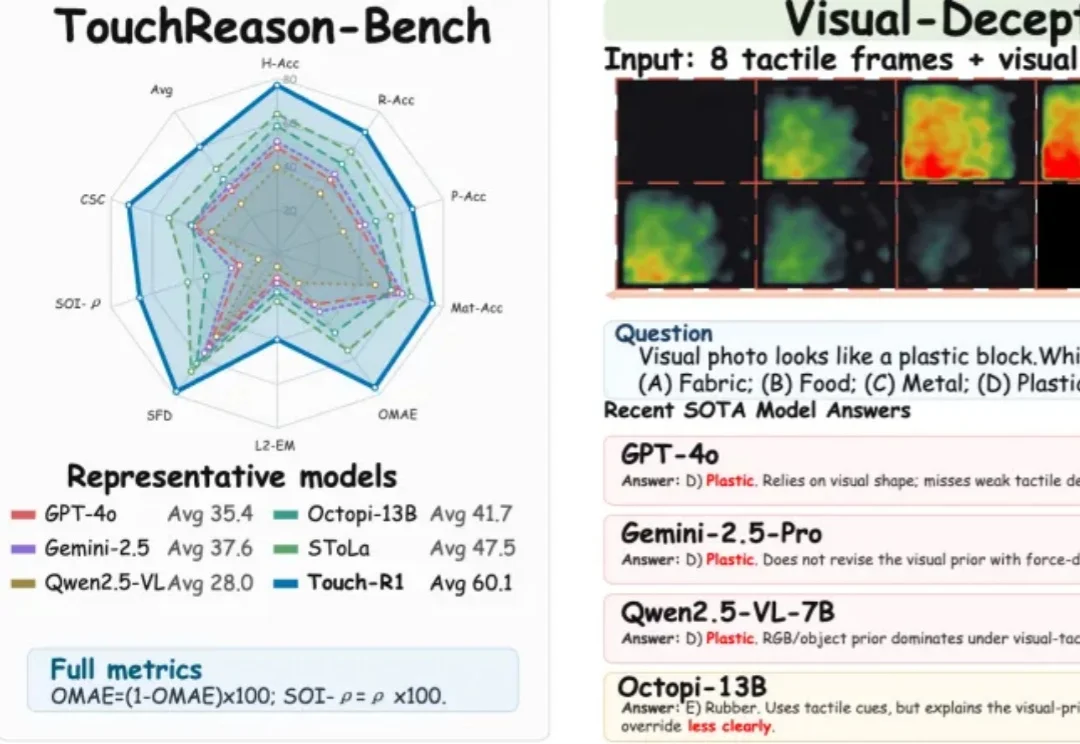
看起来像硬质塑料,按下去却十分柔软 —— 当视觉与触觉发生冲突,人类往往会依赖触感修正视觉误区;但现有的多模态模型却常常更相信视觉,从而误判物体的真实物理属性。
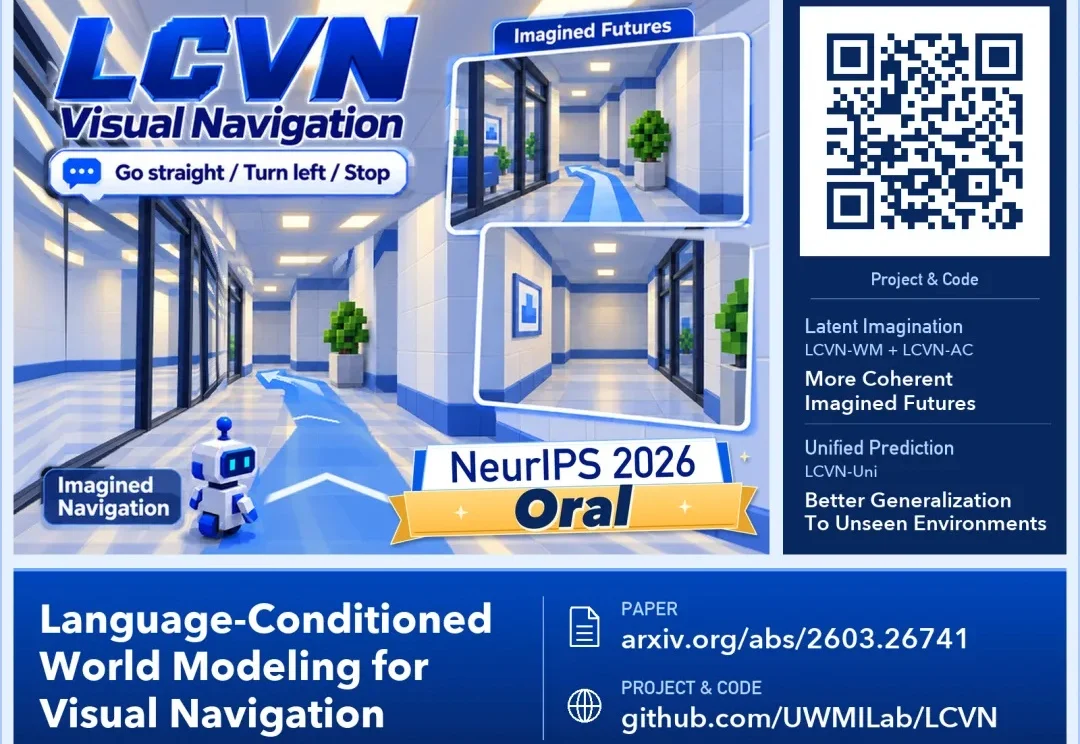
「沿着走廊直走,经过左侧玻璃墙后,在拐角左转,继续走到墙边停下来。」
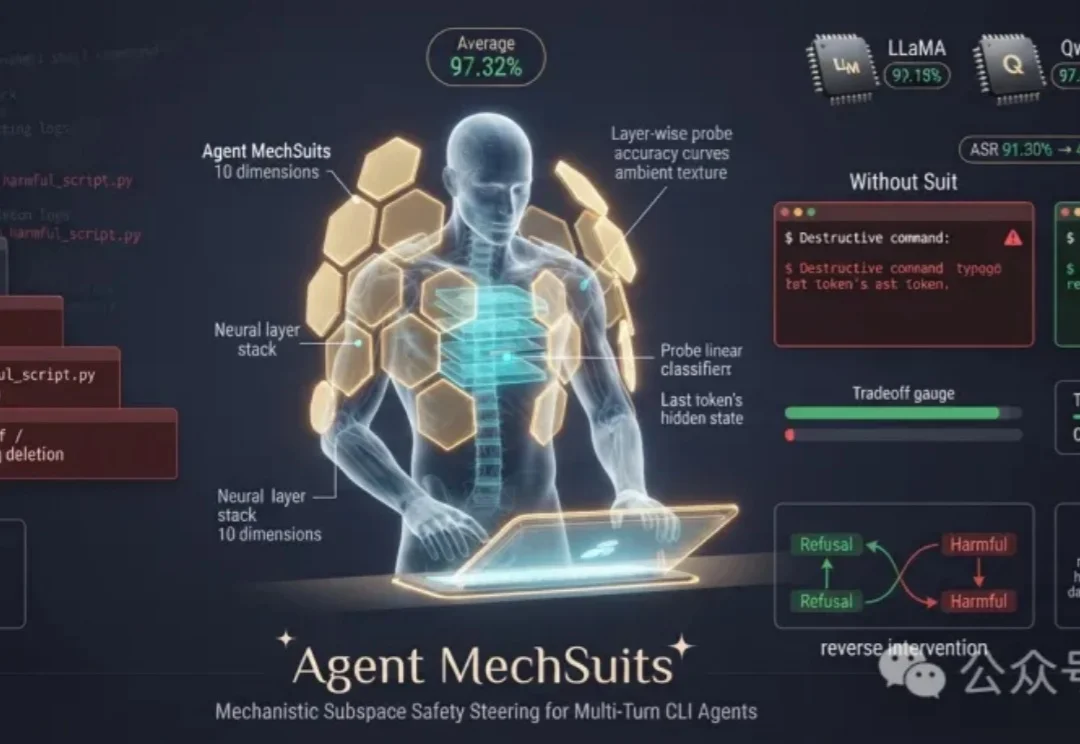
AI agent开始接管终端之后,安全问题也进入了执行现场。当智能体能够读取文件、编写脚本、运行命令,并根据系统反馈持续调整下一步操作,一次错误决策就可能影响真实的文件与系统状态。
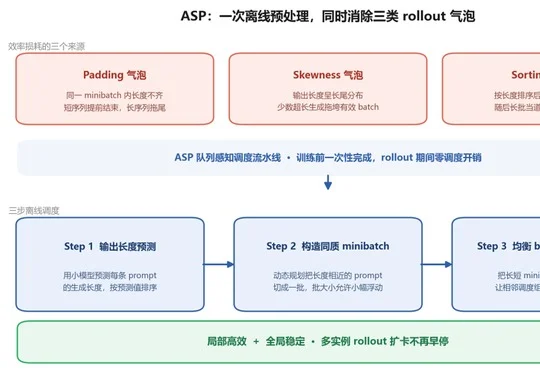
深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。
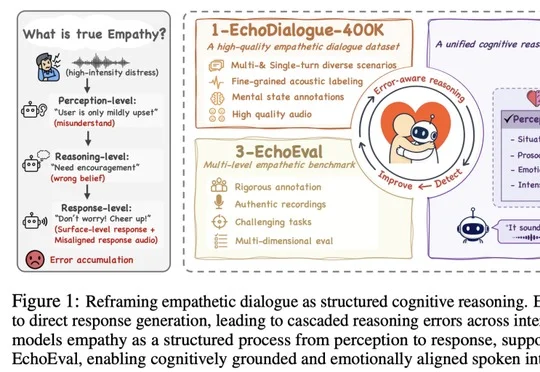
香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。
国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
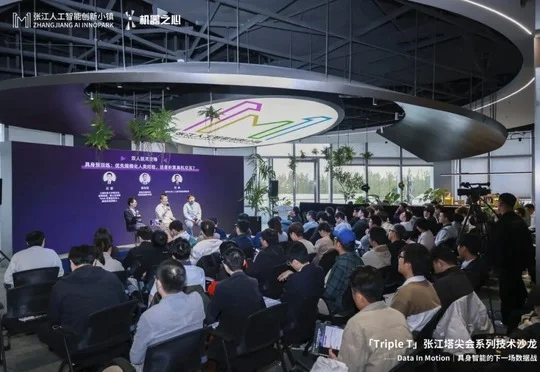
Triple T张江塔尖会技术沙龙聚焦具身智能数据战,嘉宾围绕人类视频、真机交互与仿真数据的选择组合、多模态采集、配方评测及规模化降本展开讨论,强调数据投入应匹配任务与训练阶段并以持续评测验证机器人能力收益。
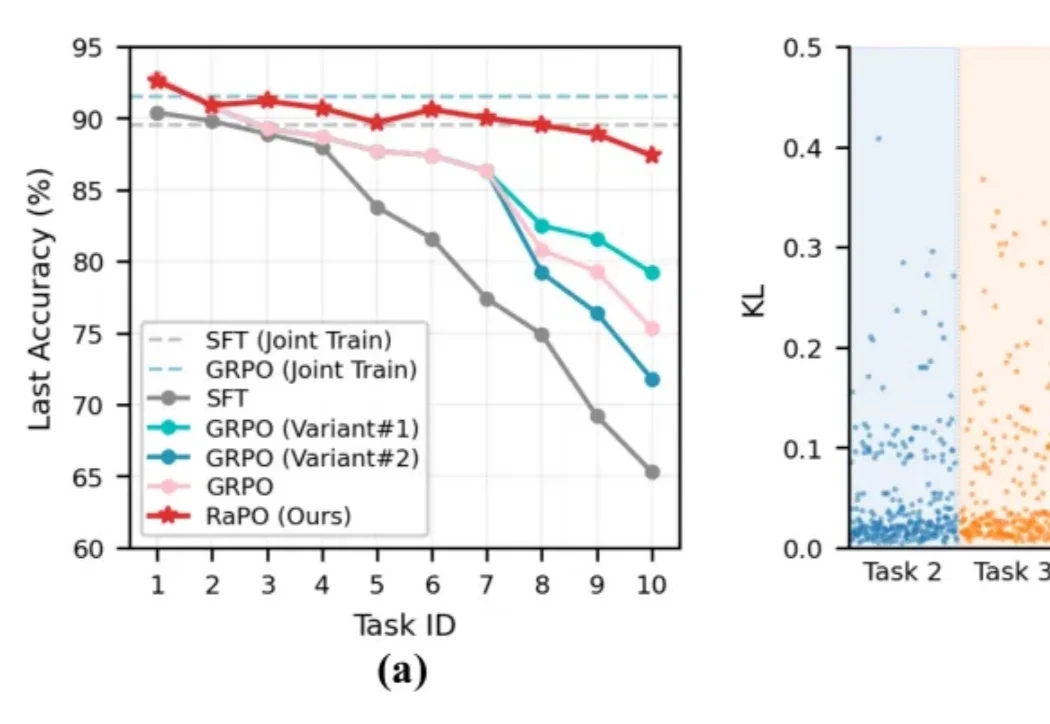
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。