独家|撬开Jev黑箱,对话全球首批复现者:9B小模型跑通79毫秒“快决策”
独家|撬开Jev黑箱,对话全球首批复现者:9B小模型跑通79毫秒“快决策”APUS(麒麟合盛)旗下AI实验室公开全球最早一批Jev独立开源复现成果fast-browser-use,基于Qwen3.5等开源模型在RTX PRO 6000上将单次决策压缩至79毫秒,并以9B小模型对标Jev性能。
来自主题: AI资讯
8989 点击 2026-09-21 22:08

 搜索
APUS(麒麟合盛)旗下AI实验室公开全球最早一批Jev独立开源复现成果fast-browser-use,基于Qwen3.5等开源模型在RTX PRO 6000上将单次决策压缩至79毫秒,并以9B小模型对标Jev性能。
千问把7B生图模型的权重开放了,RTX 3090就能跑!

蚂蚁灵波开源的流式3D重建模型LingBot-Map凭借几何上下文注意力机制在GitHub获16.9K Stars后,其论文入选ECCV 2026 Oral,全球开发者围绕该项目完成Apple Silicon桌面前端、RTX 4060低显存适配及Ray-Ban Meta智能眼镜采集等多种二次开发。
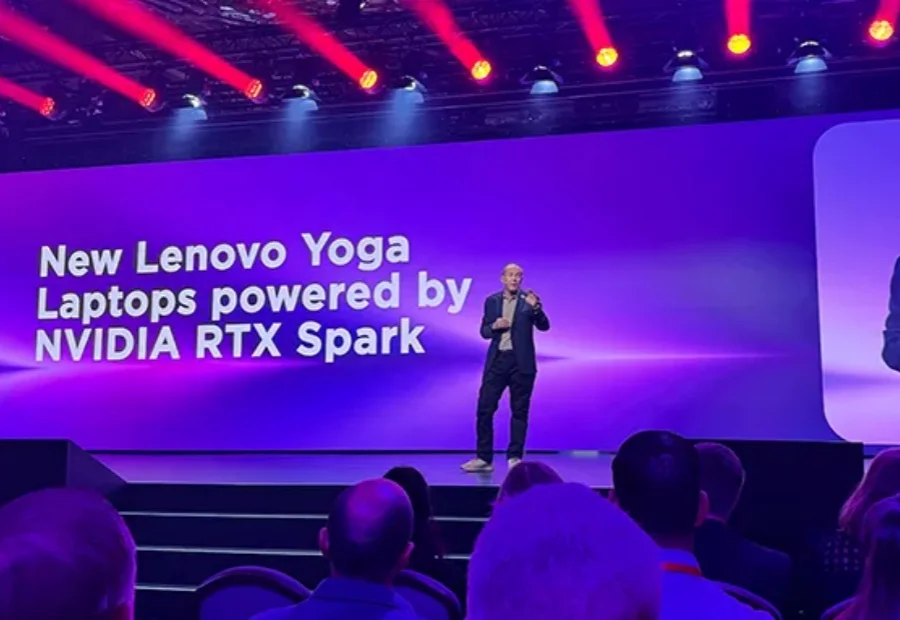
联想AI PC新物种炸场IFA:横向卷轴屏、360°翻转屏、英伟达RTX Spark。
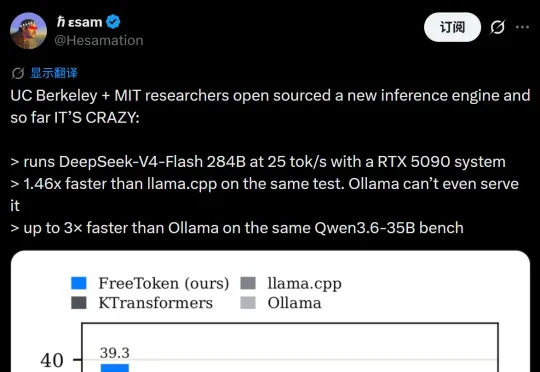
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
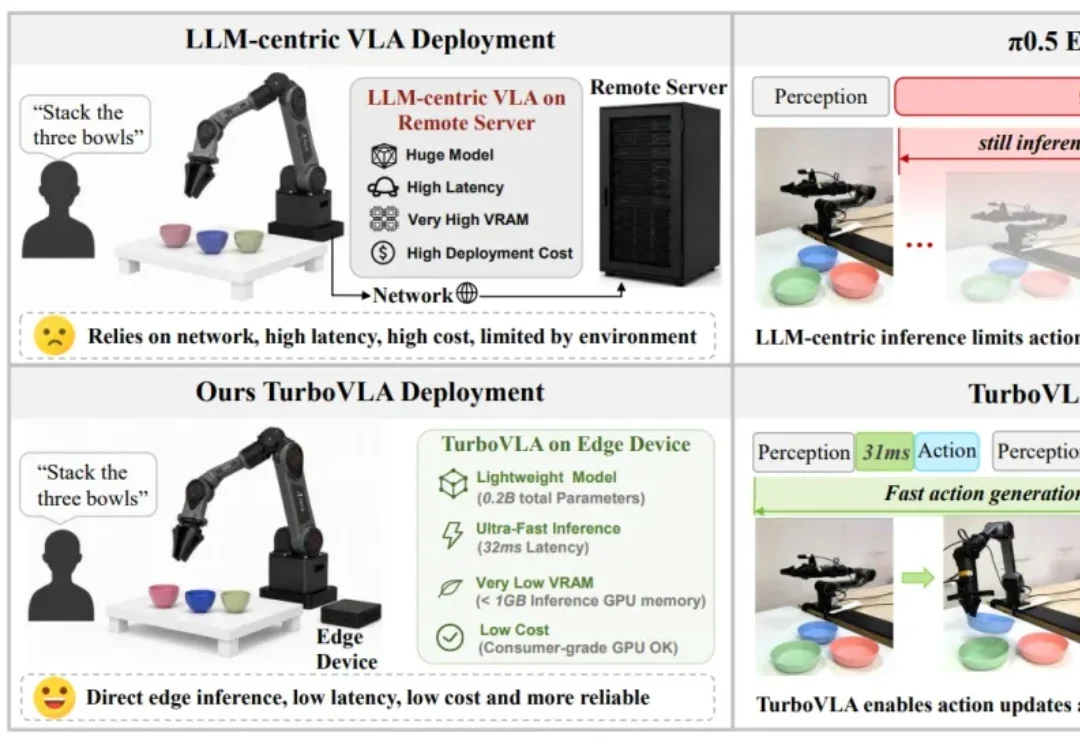
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
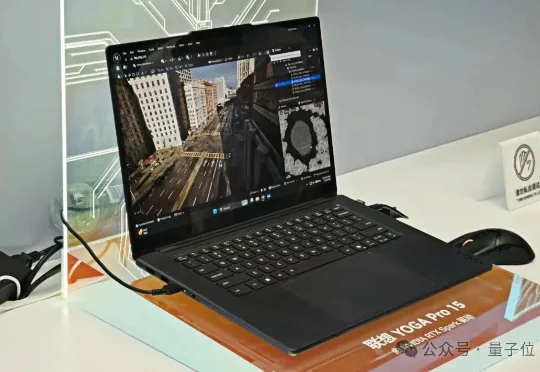
就在这届Bilibili World上,英伟达首次面向大众玩家展示了搭载RTX Spark超级芯片的笔记本电脑。这款芯片专为个人智能体打造,不仅搭载了Blackwell RTX GPU,连CPU也是出自英伟达的Grace CPU。
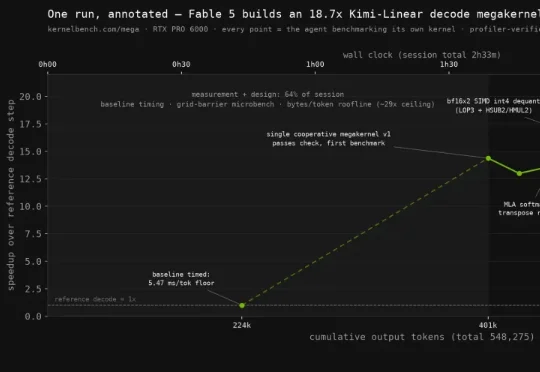
AI竟写出了,史上最快内核!在全新一轮GPU算子基准测试KernelBench-Mega中,Fable 5表现一骑绝尘。它在RTX PRO 6000,全程「纯手搓」CUDA,速度狂飙18.7倍。相比之下,强如Claude Opus 4.8也只跑出14.4倍,而GPT-5.5只有4.34倍。
在上午 11 点开始的英伟达 GTC Taibei 2026 大会现场,黄仁勋拿出了英伟达与微软联手打造的 PC 产品。在细数了将近 1 个小时已有成果之后,黄仁勋终于开讲今天的重头戏:一款迄今为止全球性能最强、能效最高的轻薄型 Windows PC。
你有没有想过,不用联网、仅用一张消费级显卡,就能在个人电脑上拥有一个「边看、边听、边说、还能主动提醒」的类人 AI 助手?这就是 MiniCPM-o 4.5 所能做到的。在技术创新下,它仅凭 9B 参数,实现了业界首个端到端全双工全模态大模型,让端侧 AI 普惠成为现实。其自 2026 年 2 月模型发布以来,在 Hugging Face 上的下载量已突破 25 万+。