
刚刚,阿里悄悄上线了他们最新视频模型:Wan3.0【附10种神仙玩法】
刚刚,阿里悄悄上线了他们最新视频模型:Wan3.0【附10种神仙玩法】昨天躺床上刷手机,突然看到阿里计划发布他们目前最新的生视频模型:Wan3.0。在千问创作PC端(c.qianwen.com)公测,逐步开放。并且,全能参考,相比sd的视频、文本、图片、音乐4个基础模态,Wan3.0还支持了网页链接、word等文档。
来自主题: AI资讯
10056 点击 2026-08-06 22:19

 搜索
昨天躺床上刷手机,突然看到阿里计划发布他们目前最新的生视频模型:Wan3.0。在千问创作PC端(c.qianwen.com)公测,逐步开放。并且,全能参考,相比sd的视频、文本、图片、音乐4个基础模态,Wan3.0还支持了网页链接、word等文档。
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……
近期,SemiAnalysis 创始人 Dylan Patel 先后做客红杉资本的《Training Data[1]》和 WisdomTree 的《The Next Big Thing[2]》。两期访谈从模型和芯片,一路延伸至内存、能源、数据中心与 AI 商业模式,并指向同一个变化:AI 竞赛的焦点,正从单纯比较模型能力,扩展到谁能以更低成本、更大规模,把模型能力稳定地交付出来。
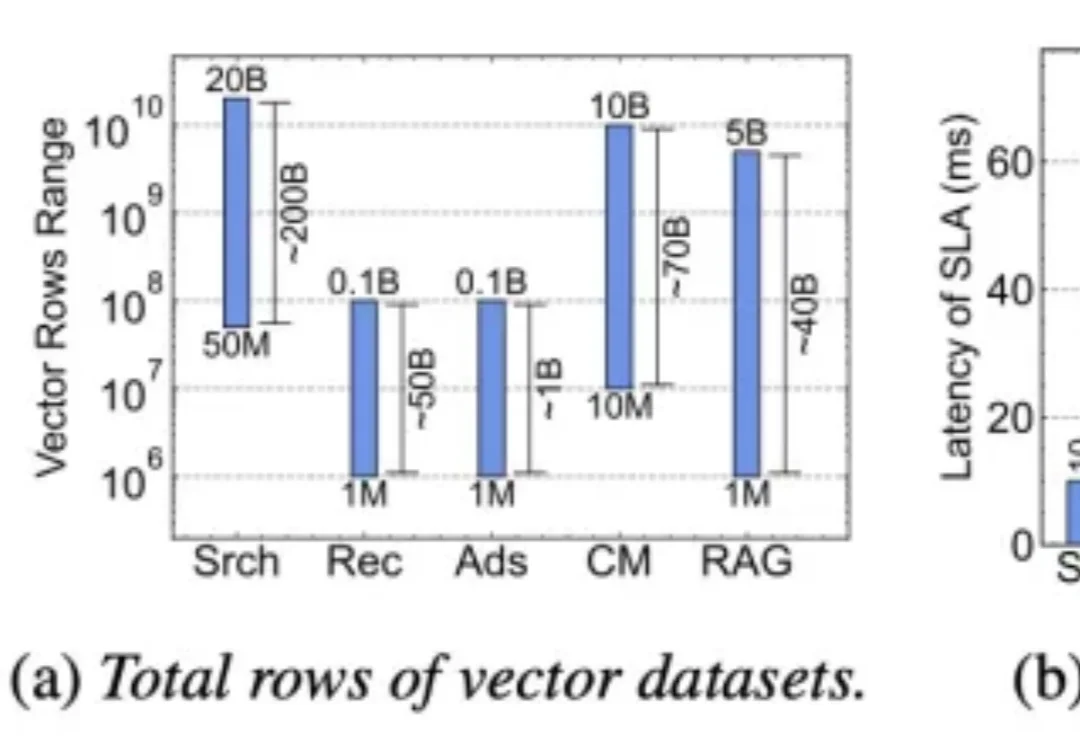
近日,围绕搜索、推荐、广告等核心业务中的大规模向量检索成本与性能问题,小红书引擎架构团队在 OSDI 2026 会议上发表了论文《The Clustering Strikes Back: Building Cost-Effective and High-Performance ANNS at Scale with HELMSMAN》。
在计算历史的绝大部分时间里,编程的本质是一项翻译工作:开发者需要在人类理解的维度上剖析问题,设计抽象方案,随后将其转译为机器能够执行的语法。当前的软件工程领域正在经历自高级编程语言问世以来最为显著的变化。
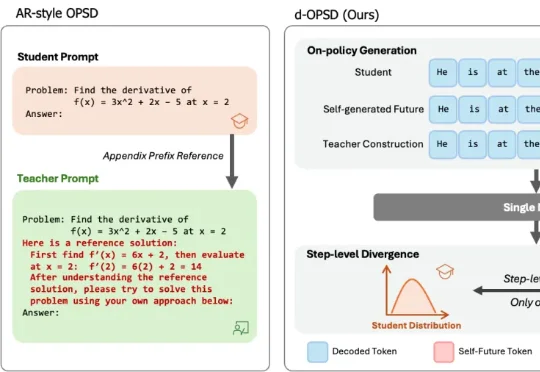
有没有一种更为合适的 OPSD 范式?近期,清华大学和马普所等机构的研究者们联合推出的 d-OPSD,给这一问题提供了完美的答案。这是第一个针对扩散大语言模型的 OPSD 范式,无需参考解,无需额外的教师模型,只需要 RL 十分之一的训练步数,便可以达到或超出 RL 的后训练效果。
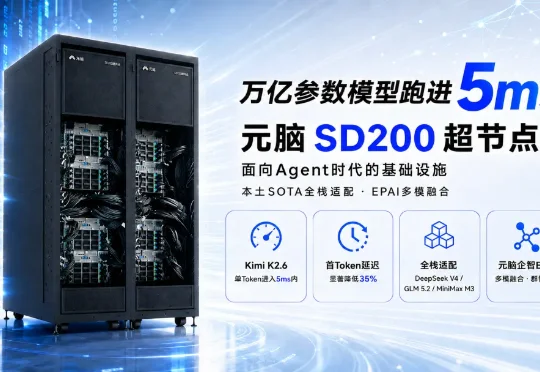
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
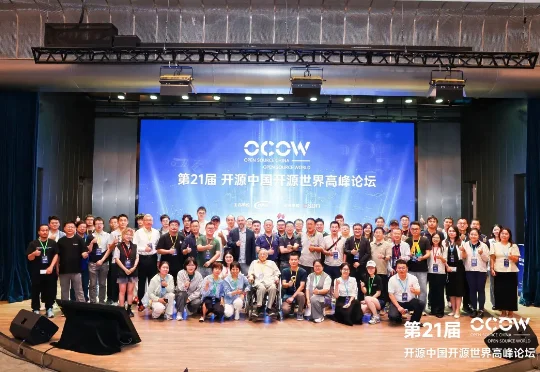
6 月 25 日至 26 日,第 21 届开源中国·开源世界高峰论坛在北京中关村展示中心举行。本届大会由开源软件推进联盟(COPU)名誉主席、国际开源领袖奖获得者陆首群发起,本届大会由开源软件推进联盟(COPU)名誉主席、国际开源领袖奖获得者陆首群发起,由 COPU 主办、CSDN 承办,来自国际顶尖基金会、
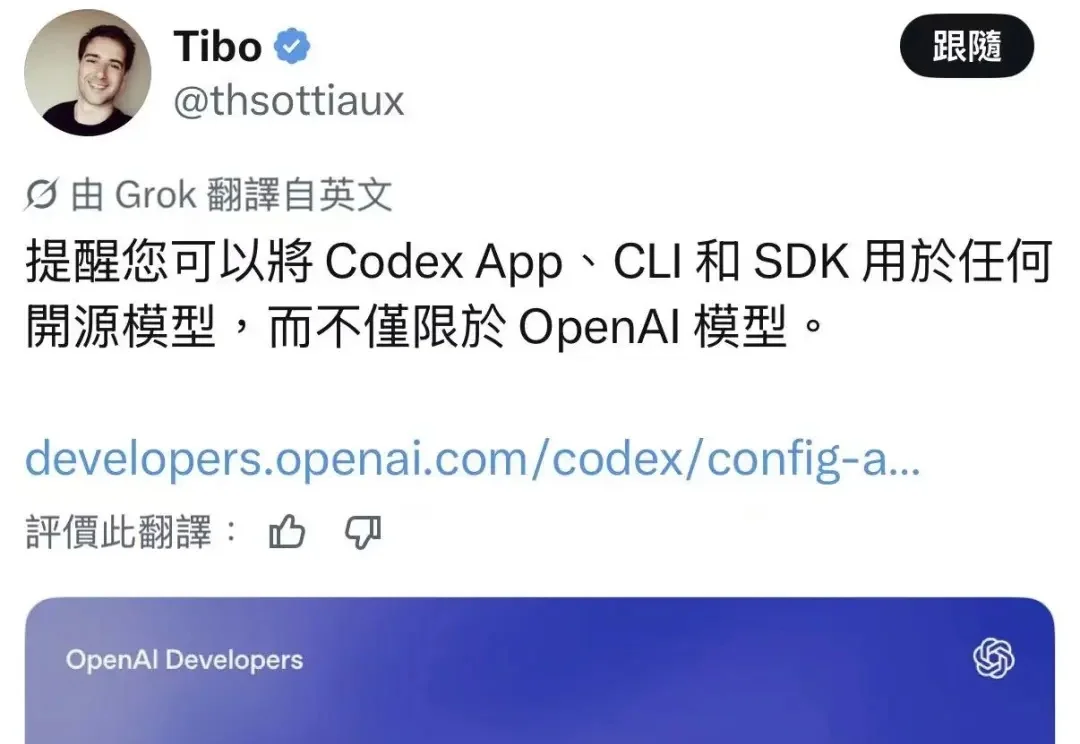
6月17日,X 上 OpenAI Codex 团队负责人 Tibo(@thsottiaux)发了一条推文,提醒大家 Codex App、CLI 和 SDK 现在可以接任何开源模型,不只限于 OpenAI 自己的模型。
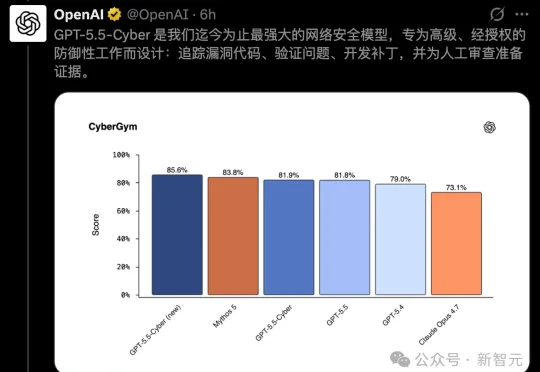
今天,OpenAI祭出满血GPT-5.5-Cyber,要给全世界的开源代码修漏洞。结果话音刚落,Codex被扒出史诗级bug:一年狂写640TB,能把SSD直接写废。