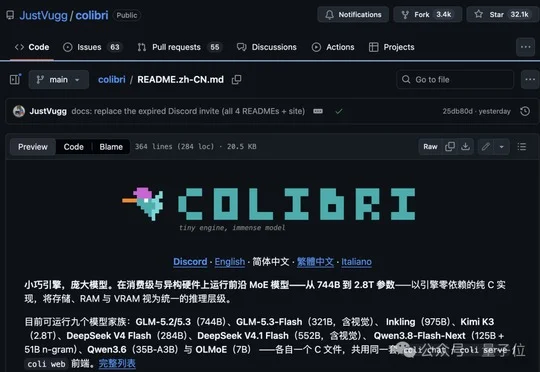
笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHub
笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHubGitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
来自主题: AI资讯
9711 点击 2026-09-26 15:01

 搜索
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
OpenAI Codex负责人Tibo Sottiaux在访谈中详述了Codex从内部Python智能体演进为顶级编程助手的历程,并解释了选择Rust构建核心智能体、从一开始就开源CLI和SDK、不绑定自家模型等关键工程决策背后的考量,指出Codex的终极目标是打造易用的个人AGI。
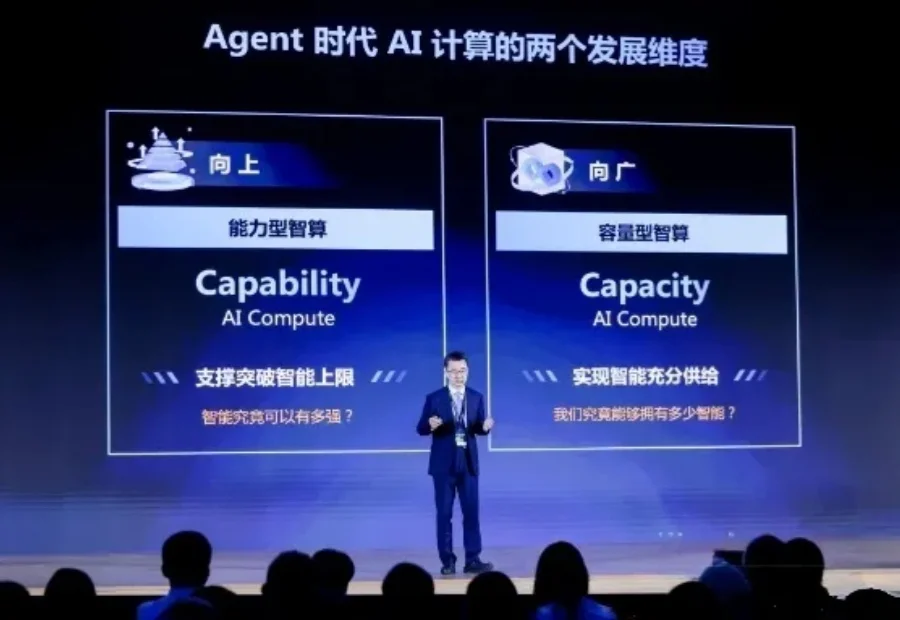
AI产业的两道坎,浪潮信息怎么翻?
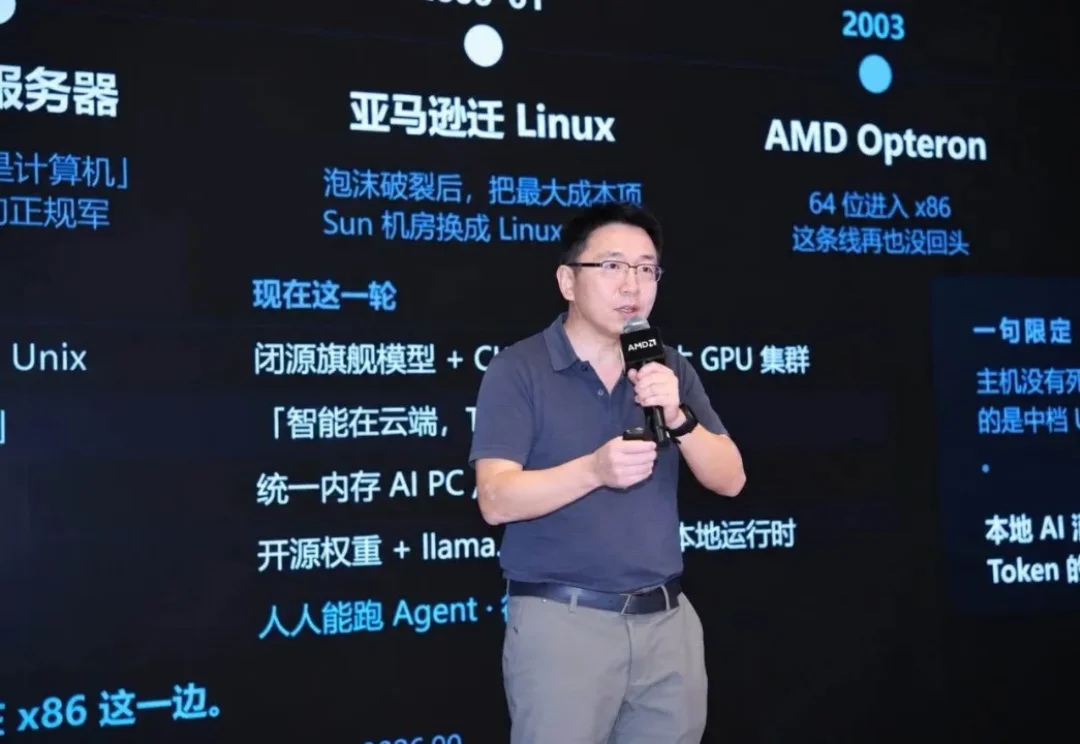
9月10日,AMD 在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,面向中国市场发布锐龙 AI Max PRO 400系列处理器,把客户端设备统一内存上限推升至192GB,实现本地运行3000亿参数级大模型的能力。CSDN 创始人蒋涛受邀发表题为《大模型的 PC 服务器时代》主题演讲。
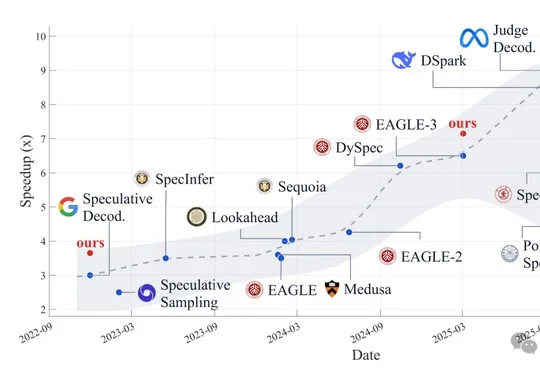
北航、清华、港大、北大联合团队提出近似投机解码(ASD),作为即插即用的验证器模块,在严格预算内接受极少数低遗憾分歧字并复用大模型已算好的后缀,免训练地挂载于DSpark、EAGLE3、Medusa等主流投机解码算法,吞吐最高提升15.26%。
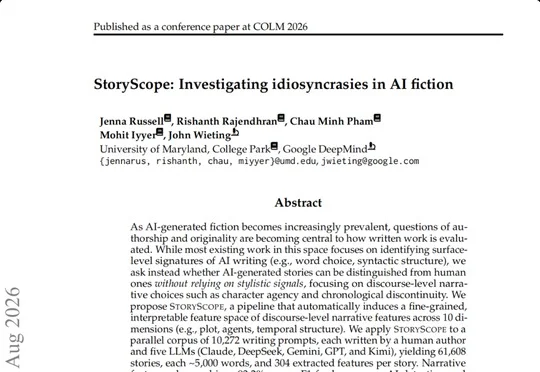
相信很多人现在见到「不是……而是」,已经会下意识 PTSD 了:这是不是 AI 写的?还有各种破折号,冒号,以及经典版本「稳稳地接住你」「我用最直白的话,不绕弯子地告诉你」…… 当然,这些不断被总结出
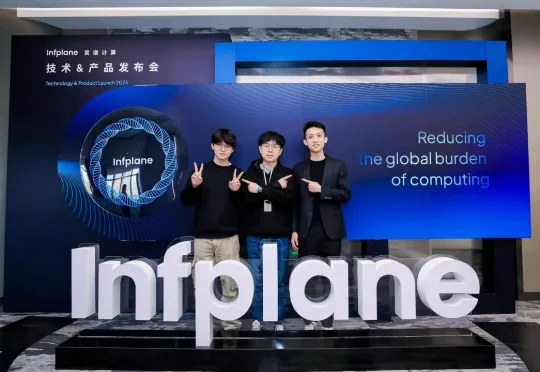
寅谱试图用一种“以存换算”的思路破题:不是让硬盘SSD替代GPU计算,而是用更低成本的SSD承接温冷(指访问频率极低和中等)的AI大模型数据、复用已经完成的中间结果,减少显存及内存压力、GPU等待和重复Prefill(预填充)。
本文编译自 Anthropic 官方博客《The AI-Native SDLC Playbook》,2026 年 8 月 21 日发布,作者 Louis Claxton。全文约八千字,保留了原文全部代码示例和配置样板,对部分章节做了适合中文读者的表述调整
Anthropic 最近发布了一篇博客文章《The AI Native SDLC playbook》,讨论AI进入软件开发之后,整个软件开发生命周期(Software Development Life Cycle,简称 SDLC)应该怎么重做。

功能型SSD在这条数据链中的合理角色,不是自行判断一段经历是否值得记住,而是在Runtime已经给出对象和策略后,靠近数据执行确定性工作。例如按租户选择密钥,按生命周期放置数据,压缩与去重可缩减的对象,维护索引页与元数据,优先完成即将被推理使用的回载,并把尾延迟、写放大和介质健康反馈给上层。语义决策留在Agent和Runtime,数据执行尽量靠近介质。