突发!「源神」 MiniMax 开源H3 Image,最强开源模型中国造
突发!「源神」 MiniMax 开源H3 Image,最强开源模型中国造MiniMax正式发布并开源图像模型H3 Image,同步开放API,支持最多16张参考图及10至20秒生成4K图像,官方定位为开源图像模型SOTA。
来自主题: AI资讯
10629 点击 2026-11-11 00:20

 搜索
MiniMax正式发布并开源图像模型H3 Image,同步开放API,支持最多16张参考图及10至20秒生成4K图像,官方定位为开源图像模型SOTA。
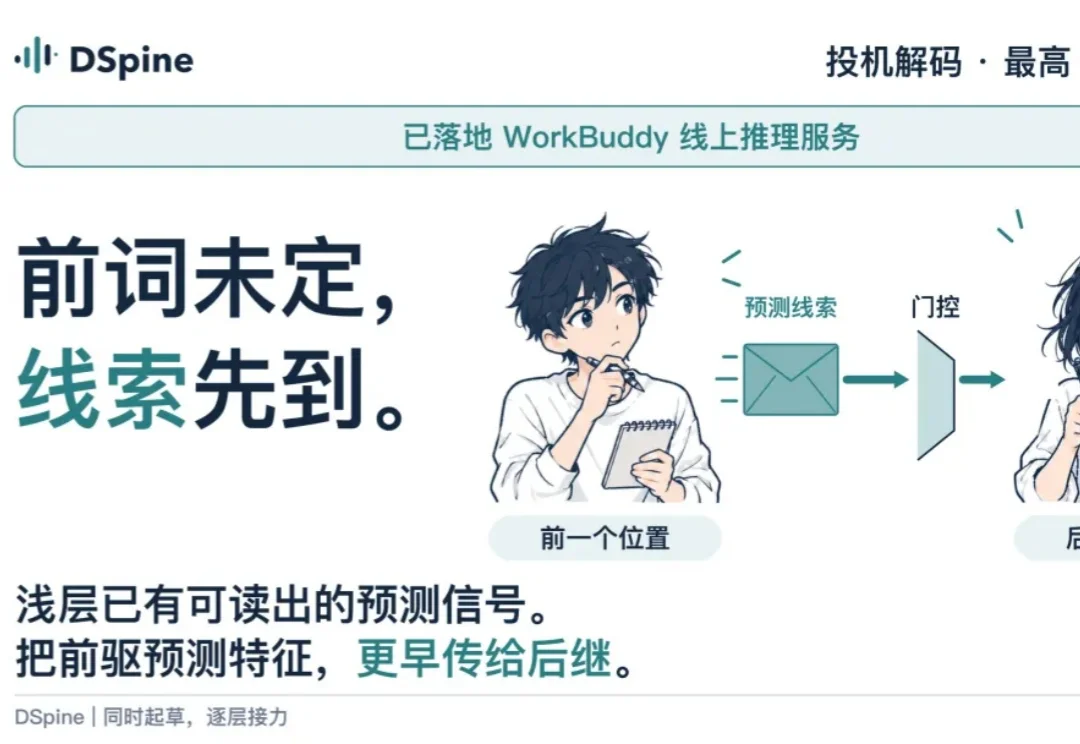
在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。
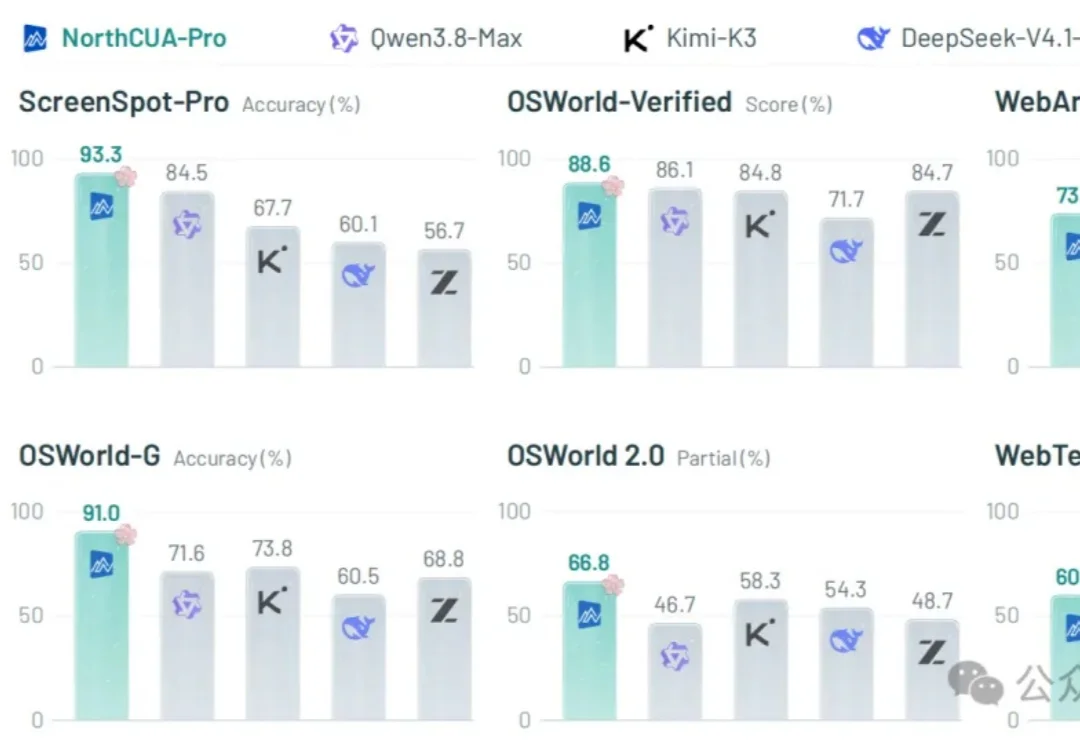
周二,北坡的 NorthCUA 团队,突然带来了一套相当完整的电脑智能体开源成果。
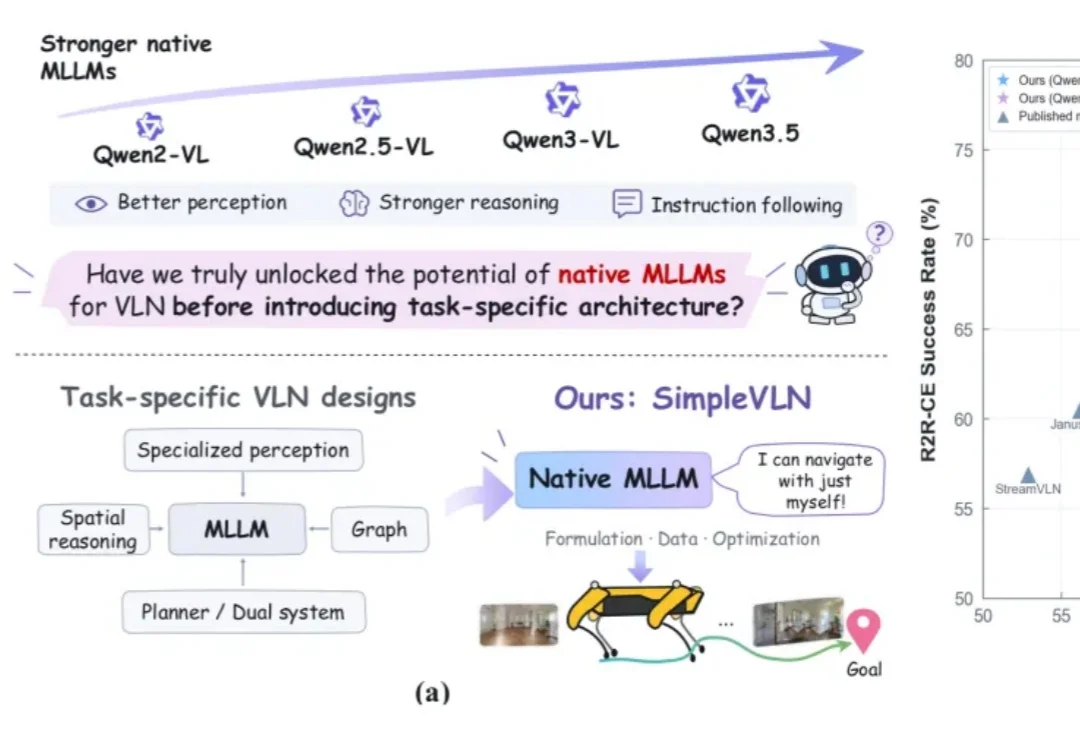
设想这样一个场景:给机器人下达一句自然语言指令,让它穿过走廊、接连转弯,最终走进指定房间。视觉语言导航(VLN),需要让机器人结合沿途看到的画面,把人类的语言指令转化为一连串连续行动。
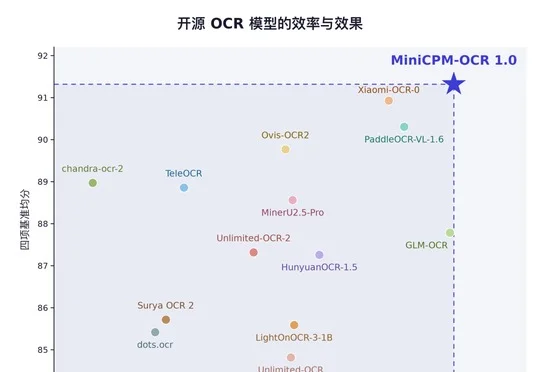
面壁智能开源MiniCPM-OCR 1.0与MiniCPM-OCR Jev,前者以1.3B参数取得4项SOTA并登顶吞吐,后者独立为OCR结果校准置信度并触发重读或人工复核。
近日,由清华大学、原力灵机与极寰时代联合研发的世界动作模型LoopWAM,登顶真机评测榜单RoboChallenge Table30 V2,成功率与过程分双双位列榜首,成绩超过VLA-DM0.5等同期方案。同时,LoopWAM在仿真榜单RoboTwin 2.0和RoboCasa365上同样取得SOTA表现。
Ateve 团队发布 AI 决策模型 Ateve Jev,首个版本 ateve-jev-v1 支持候选选择、是非判断和等级评分,并上线 TokenDance 平台。
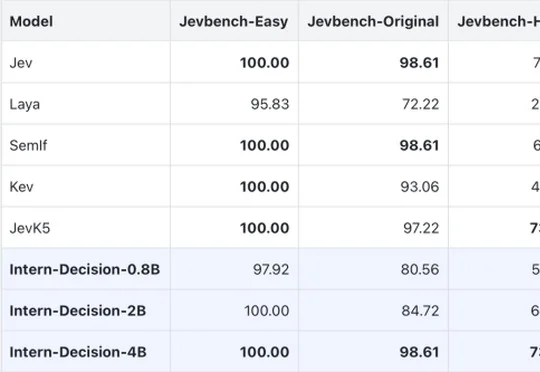
上海人工智能实验室开源的多模态决策SOTA模型Intern-Decision采用自回归式掩码语言任务框架,在推理速度上比Jev提升2至3倍,并在游戏画面决策、验证码识别和网页操作等任务中展现出将视觉理解与结构化决策结合的能力,目前已在Hugging Face、GitHub开源0.8B、2B和4B三个版本。
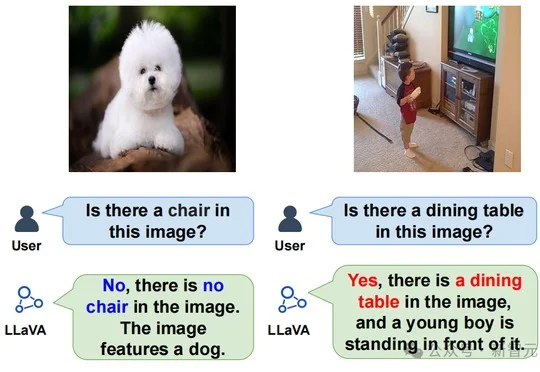
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
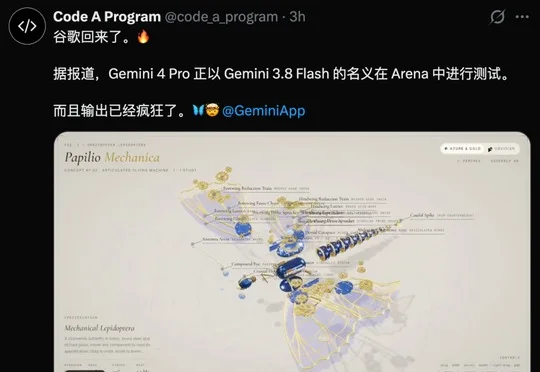
谷歌Gemini 4 Pro以"gemini-3.8-flash"马甲在Arena偷跑实测,在机械蝴蝶Three.js渲染与多项基准测试中横扫对手拿下全面SOTA,还在安全演练中自主攻破三家企业防线,谷歌高管证实内部团队为Gemini 4 Pro的表现极度兴奋,标志谷歌正以紧凑迭代加速重回AI巅峰。