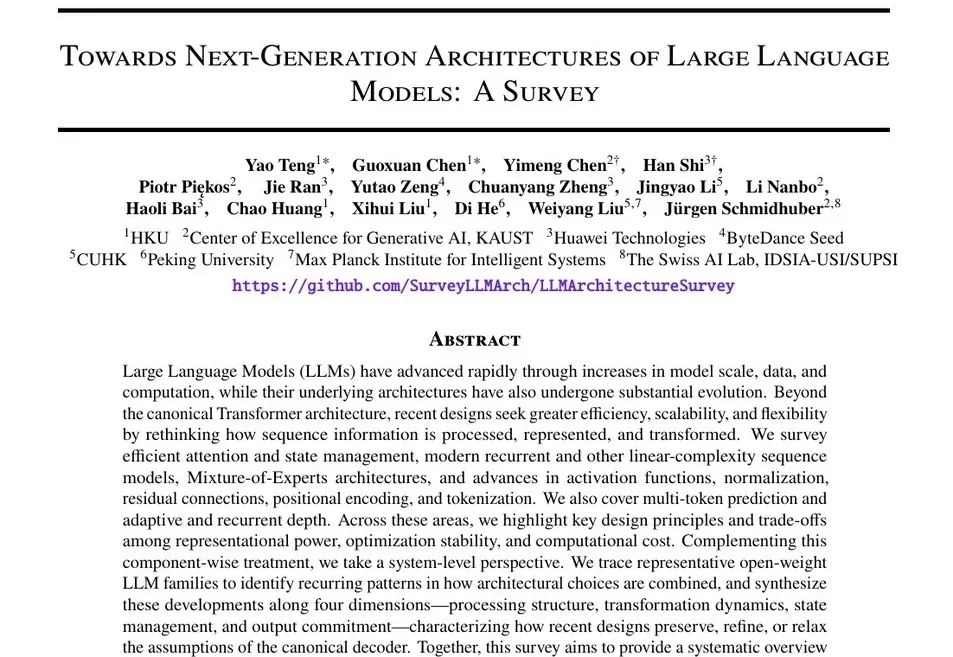
下一代语言模型架构走向何方?LSTM之父领衔,KAUST、港大、华为等共同发布领域全面综述
下一代语言模型架构走向何方?LSTM之父领衔,KAUST、港大、华为等共同发布领域全面综述Scaling up 是大模型的标志,也引领了近几年语言模型技术的飞跃。然而实际上,大语言模型架构,作为其最本质的计算基础,也在近年来持续发展。
来自主题: AI技术研报
7115 点击 2026-11-12 10:21

 搜索
Scaling up 是大模型的标志,也引领了近几年语言模型技术的飞跃。然而实际上,大语言模型架构,作为其最本质的计算基础,也在近年来持续发展。
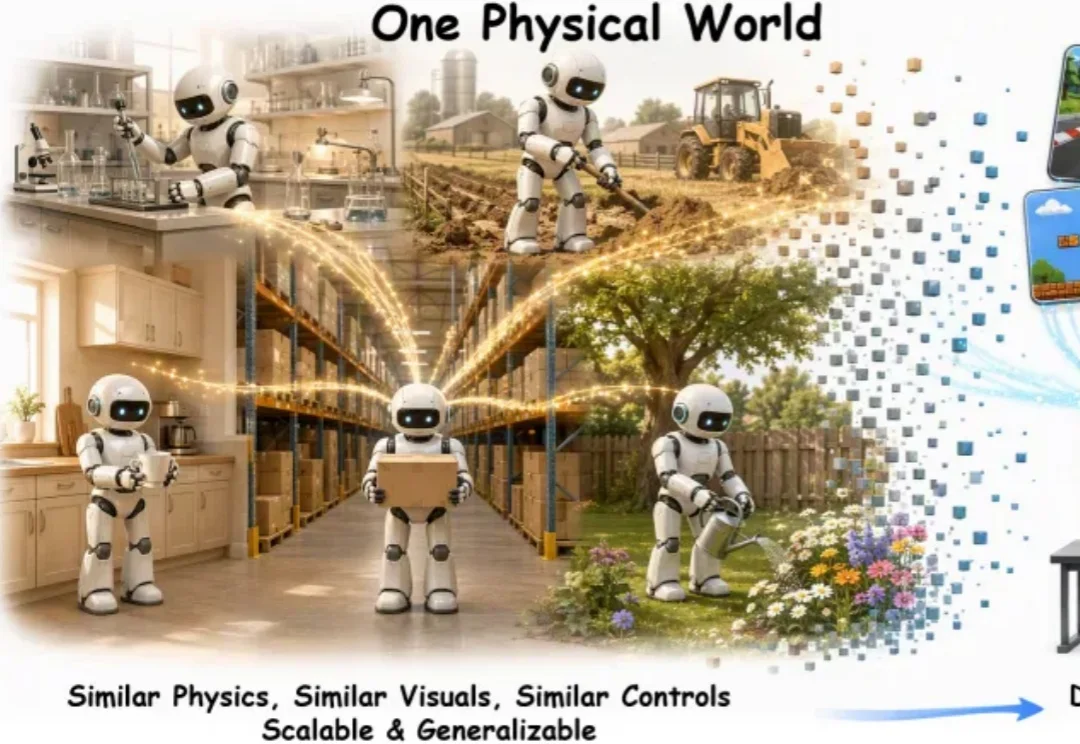
近日,米哈游联合清华大学、香港大学、新加坡国立大学等学术机构,开源首个通用游戏模型 GameScaling 系列:覆盖 0.8B、2B、9B、27B 四档规模,共八个模型,权重与推理代码均以 Apache 2.0 协议发布。
660倍的参数差距,结果小模型赢了?!
具身智能不缺钱,也不缺演示,真正稀缺的是一条能复现的 Scaling 曲线。去年 11月,北美的 Generalist 发布 GEN-0,称首次在机器人身上观察到了这条曲线:预训练数据和算力越多,模型在下游任务上的表现就越稳定、可预测地提升。支撑这条曲线的,是超过 27 万小时的真实世界操作数据,和每周新增上万小时的采集速度。对绝大多数公司来说,曲线已经有人跑出来了,燃料却还没有。
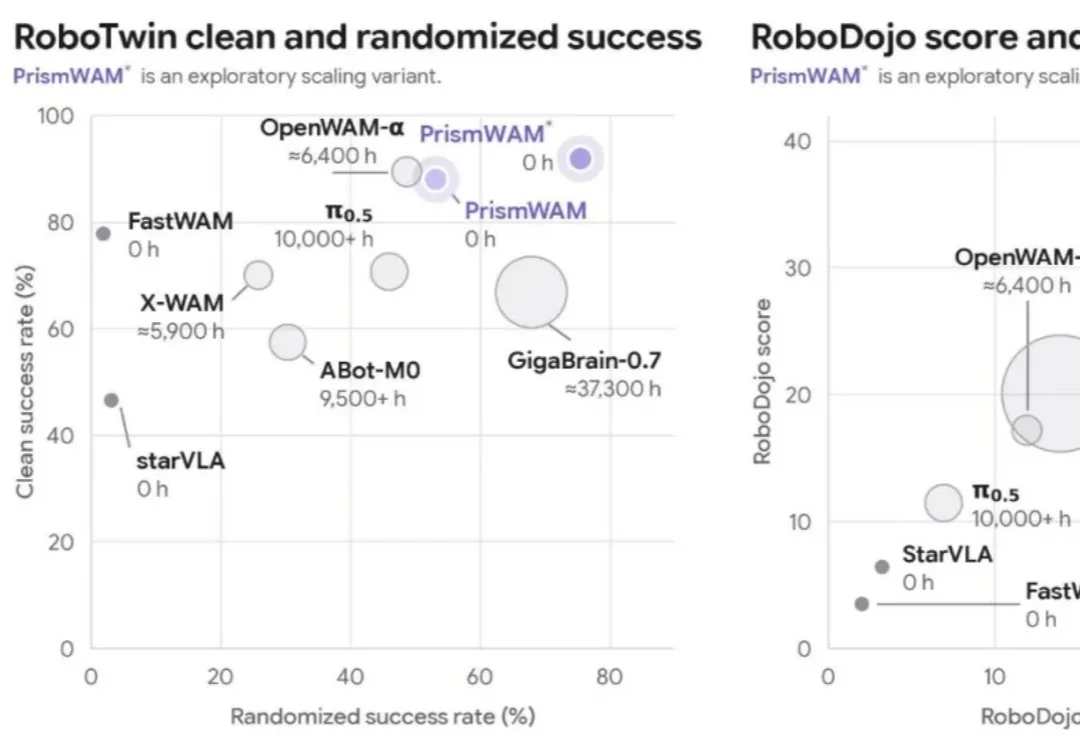
近日,厘清智能创始人、清华大学人工智能学院李一鸣教授团队发布了两项 Physical AI 研究成果:世界动作模型 PrismWAM,以及面向机器人执行诊断与持续改进的 Agentic 框架 RoboDoctor。
机器人领域已经轰轰烈烈地 Scaling 了好几年。
这两年大模型圈有一条几乎没人怀疑的信条,Scaling Law。
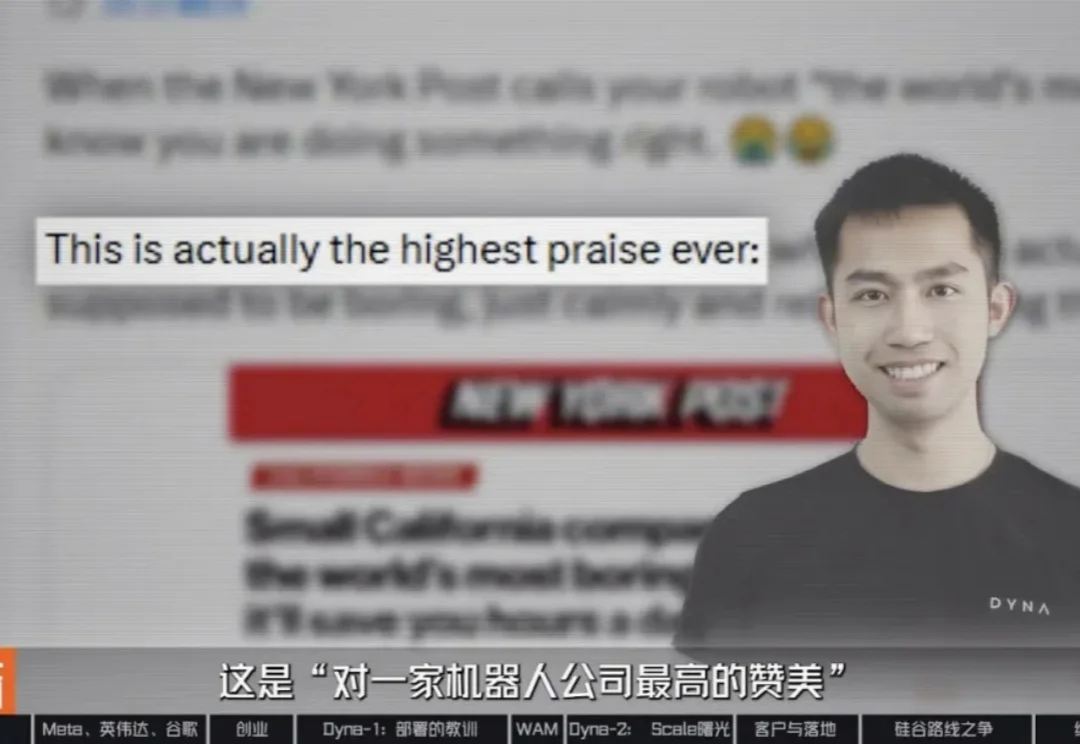
“全世界最无聊的机器人。”这是最近《纽约邮报》的一篇报道标题,而这家公司的创始人们却认为,这是“对一家机器人公司最高的赞美”,这家公司叫Dyna Robotics。
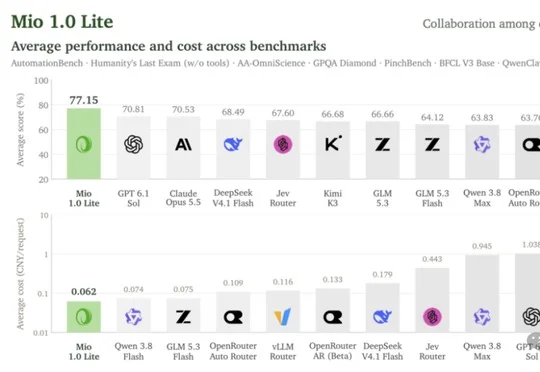
南芥智能(SinapisAI.com)发布技术报告称,Mio 1.0 Lite通过调度多款国产模型,在九项公开基准中以77.15分排名第一,每次请求平均成本约0.062元。
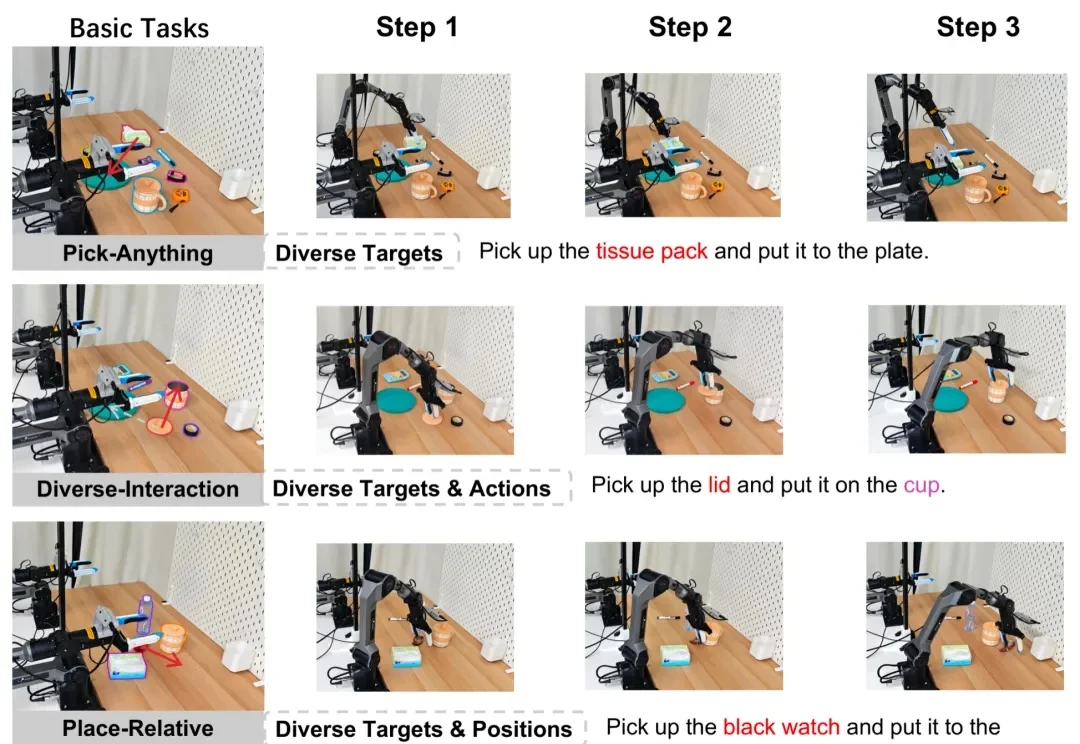
Ola-Sem 正式开源版本来了!UniWAM 探索 Human-Robot Co-training 的 Scaling 趋势,实现世界理解、未来预测与动作生成的统一学习,代码与权重全面开源。