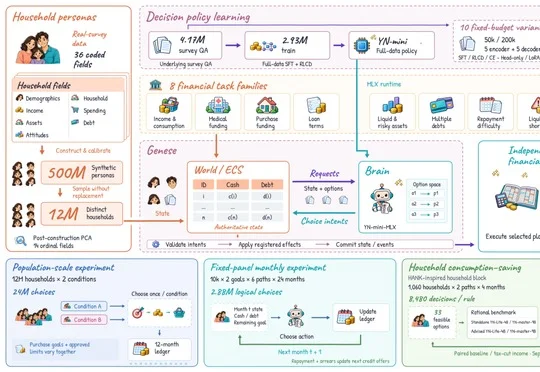
3.7万token/s实现千万级家庭仿真,准确率超越硅谷Jev模型,港大罗晔教授团队发布YN决策模型
3.7万token/s实现千万级家庭仿真,准确率超越硅谷Jev模型,港大罗晔教授团队发布YN决策模型香港大学罗晔教授团队发布S²-MAS框架及YN决策模型,以14张GPU在4小时内完成1200万户家庭仿真,YN-mini单卡吞吐量达3.7万token/s,消费金融基准准确率高于Jev 1.13。
来自主题: AI技术研报
8650 点击 2026-11-07 14:48

 搜索
香港大学罗晔教授团队发布S²-MAS框架及YN决策模型,以14张GPU在4小时内完成1200万户家庭仿真,YN-mini单卡吞吐量达3.7万token/s,消费金融基准准确率高于Jev 1.13。
广州智跃深空(Zleap)开源了自研的SAG2及桌面端SAG Wiki,利用BM25与JEV直接索引和检索本地文件,无需大模型预处理、Embedding或向量数据库,以极快建库、精准多跳检索和低Token消耗提供轻量本地知识库方案。
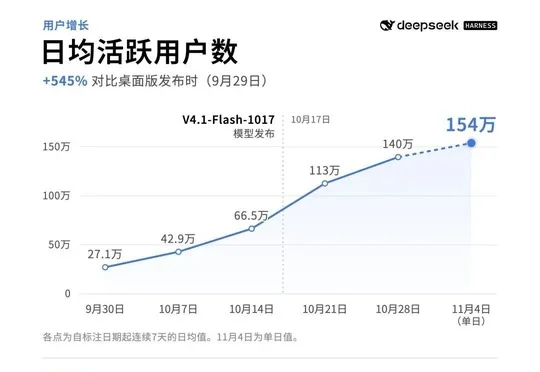
DeepSeek正筹备插件作者支持计划,通过官方插件市场、Token补贴和流量推荐推动生态;DeepSeek Harness发布一个多月已有约3.5万个公开第三方插件,日活超140万、月活548万,日均Token消耗估计超91万亿。
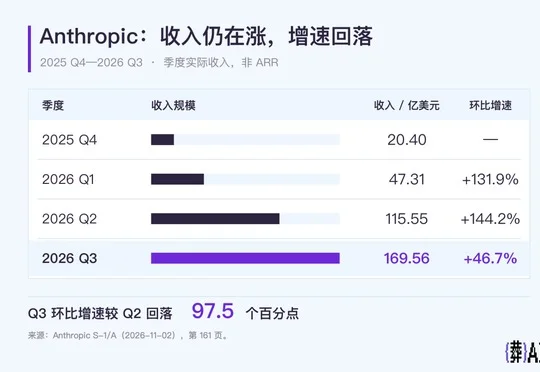
梁圣做空Anthropic,认为Tokenmaxxing与Benchmaxxing支撑的AI估值难以为继,Claude高昂调用成本和跑分热潮无法匹配收入增长及巨额算力承诺,Super agent普及前模型厂增长将承压。
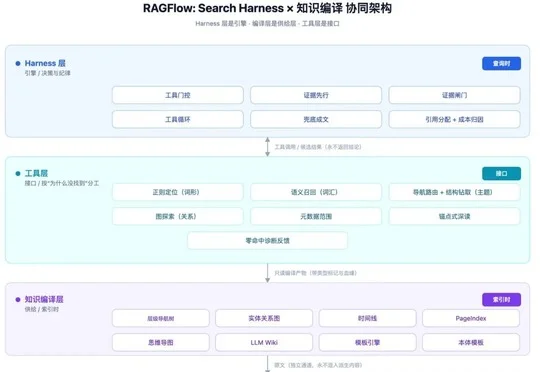
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
主模型参数1250亿,激活参数60亿。
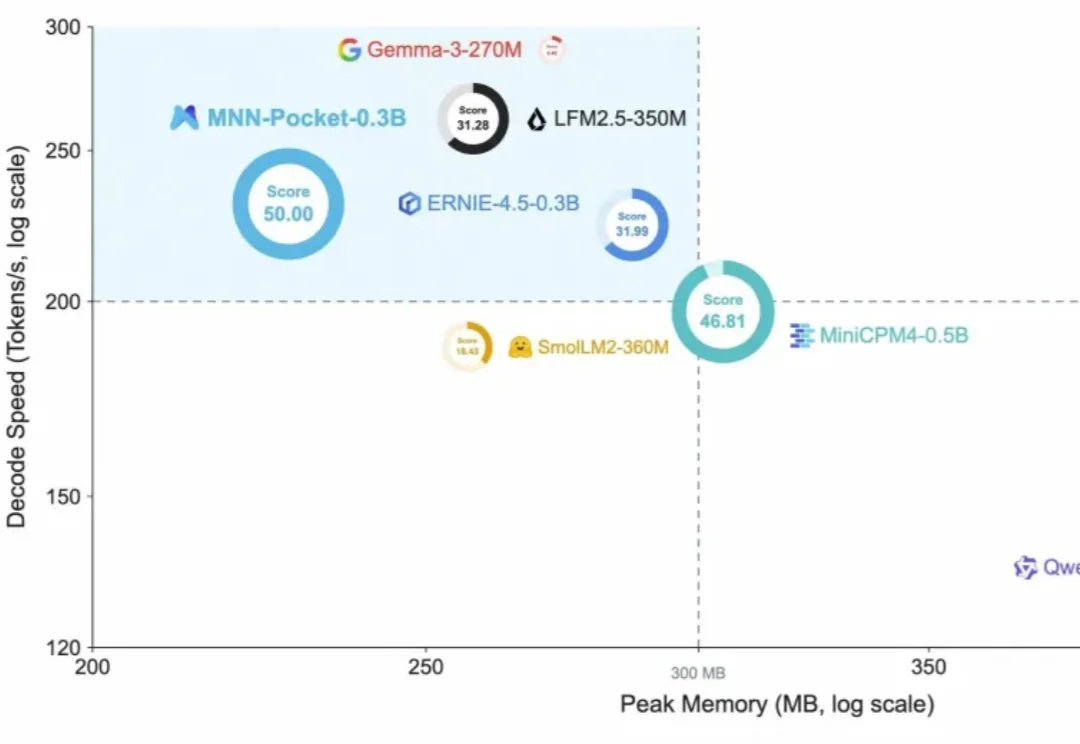
把大模型运行在手机上,已经有了不少探索。
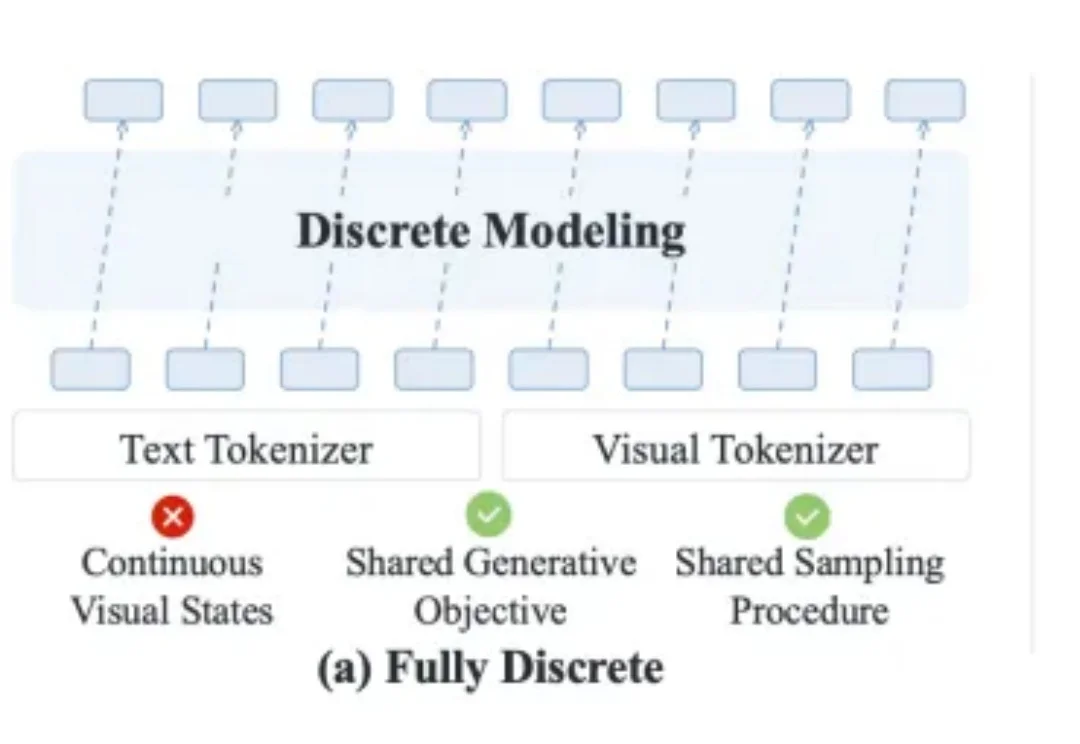
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
2026年,大模型卖Token这门生意,已经卷到让人看不懂了。