答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励
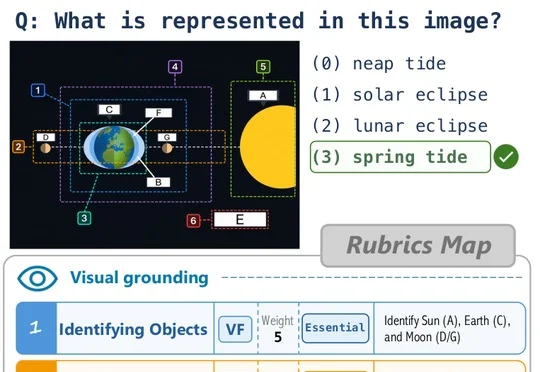
答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
搜索
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
在社会变化的洪流中,LLM 能不能不断修正自己对社会的认知?
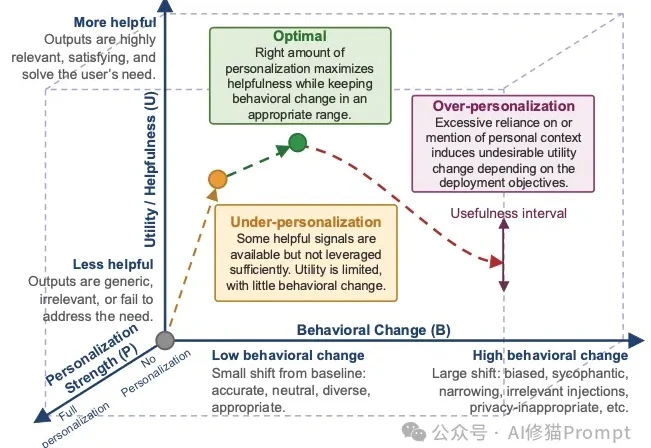
个性化在通用AI产品中一直是个加分项。无论是ChatGPT、Gemini还是Claude,还是今年的Openclaw、Harmes都把记忆和个性化当成核心卖点,理由是它能提高可用性、参与度和用户满意度。学术界对个性化的研究,也几乎全部集中在"如何做得更好、更准、更符合用户口味"上。
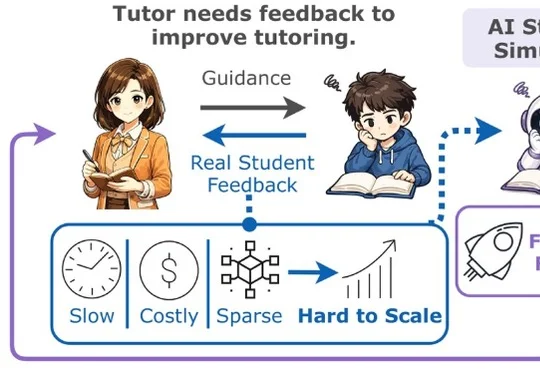
微软与UIUC合作研究StudentSim框架,基于真实学生数据训练个性化学生模拟器,具备behavioral fidelity和guidance responsiveness两项能力,在国际象棋等三个领域验证其优于现有基线,并可作为AI教师强化学习的高通量奖励信号。
Salesforce AI与UIUC研究人员提出Strong-to-Weak Scaffolding方法,让强模型(Builder AI)为弱模型GPT-5.4-mini自动设计外部Harness工作框架,无需修改参数即可将其在心智理论任务上的平均准确率从0.488提升至最佳0.912,揭示AI4AI的核心机制是将认知结构而非知识从强模型迁移至弱模型。
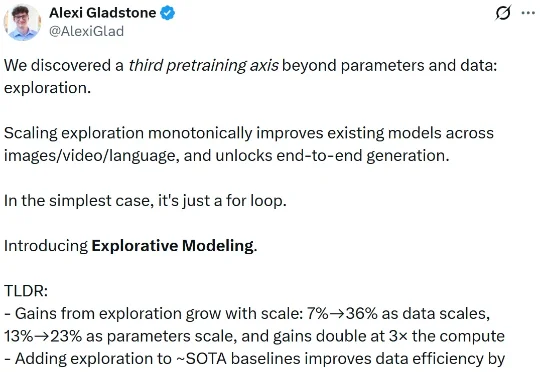
最近,一篇来自 UIUC 与哈佛大学的论文,试图把这块最后的拼图补上。作者给这个新范式起了个名字,叫 Explorative Modeling(探索式建模),模型简称 XM。它的想法简单到近乎朴素,却指向一个大胆的结论:生成模型除了参数和数据,其实还有第三根可以放大的轴。
过去两年,AI智能体(Agent)完成了一次身份转变。
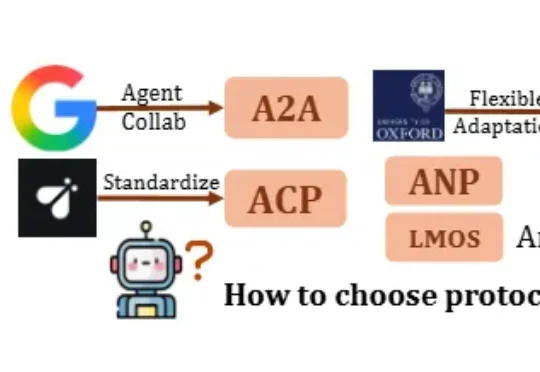
多智能体系统正在从学界走向业界。 在 Coding、Research 等真实场景里,越来越多系统不再只依赖单个 agent,而是由多个 Agent 分工协作:有人负责规划,有人负责检索,有人调用工具,
过去两年,大模型写代码已经不再新鲜。从代码补全到 GitHub issue 修复,从竞赛编程到仓库级软件工程,人们习惯用一个简单标准评估 coding agent:代码能不能写对?测试能不能通过?
说在前面:这又是一篇讲Harness的Survey,你最近可能已经看过了数篇讲Harness的文章、论文,其中还可能包括我上周解读的《Agent Harness Engineering:Agent的底盘工程综述|CMU、耶鲁、Amazon》。