
北大与微软亚研提出 BCP,让模型自己决定何时重规划
北大与微软亚研提出 BCP,让模型自己决定何时重规划在 action chunking 已成为 VLA 标配的今天,「一次执行多少步」几乎被所有工作当作一个固定的超参数。
来自主题: AI技术研报
6539 点击 2026-08-20 14:22

 搜索
在 action chunking 已成为 VLA 标配的今天,「一次执行多少步」几乎被所有工作当作一个固定的超参数。
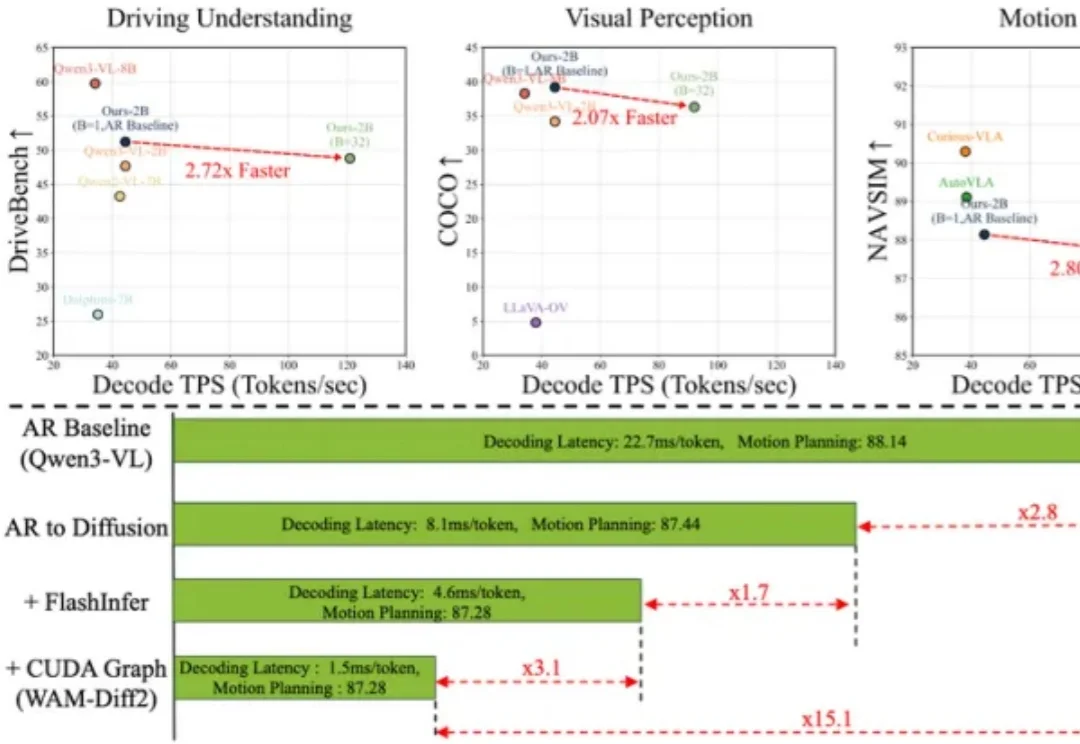
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。

独家获悉,具身智能公司LatentVerse已完成数亿元人民币种子轮融资,第一轮投资方包括高瓴创投、清流资本、智元、星动纪元及英诺天使等基金。LatentVerse选择的是第三条路线:不做VLA也不做如今大热的WAM,而是把VLM和世界模型统一在同一个架构里。

本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。

天使轮由一线美元基金,智能制造与大模型产业方共同领投;数据集 Xperience-10M 位列全平台数据集榜第 2 名,具身赛道第一名,目前已被多款具身基础模型 Qwen-VLA、MolmoMotion 等采用;多模态采集系统 HOMIE 进入规模化量产交付,新一代系统将于 2026 年 8 月发布。
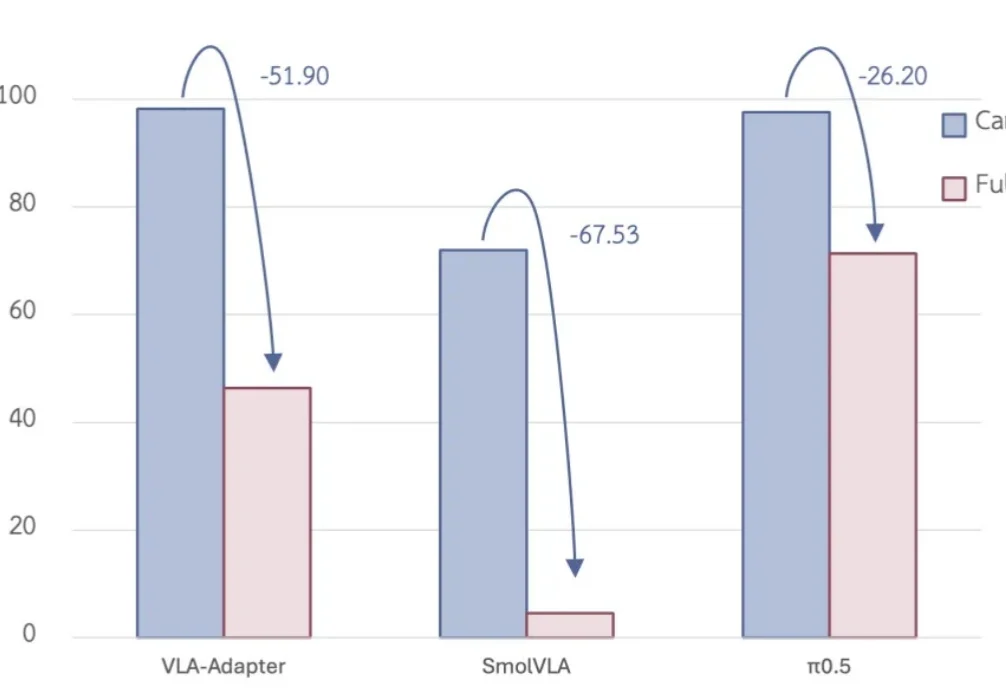
作为具身智能最主流的路线之一,VLA 快速发展的同时也因为其各种问题被诟病。其中最主要的痛点之一便是指令泛化能力。
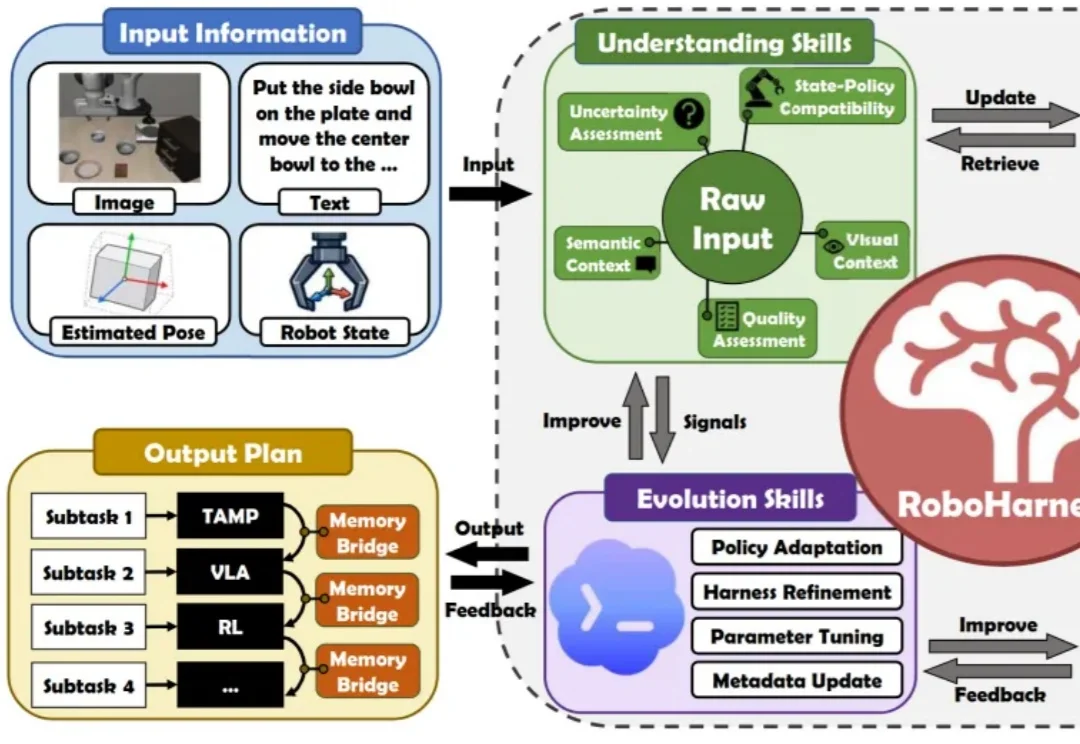
当 VLA、WAM、RL、TAMP、MPC 等机器人控制策略在各自擅长的任务中大放异彩,如何刻画其能力边界,并在正确的时机为不同子任务匹配最合适的策略,正逐渐成为机器人完成复杂长时序任务的关键。
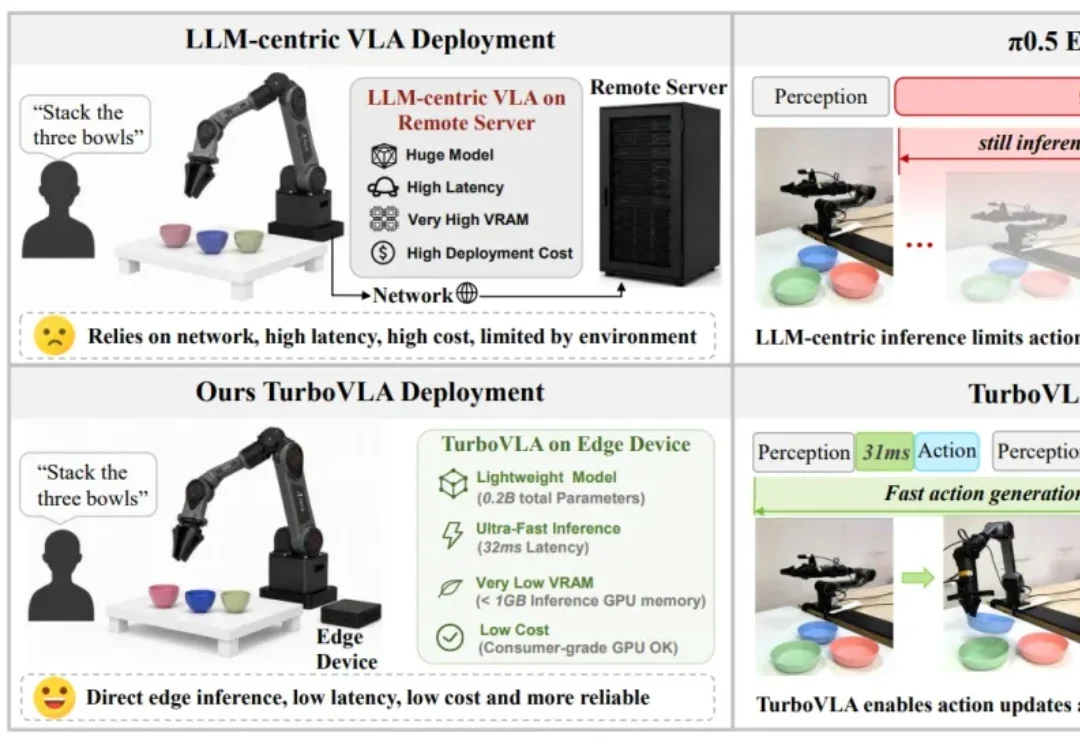
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
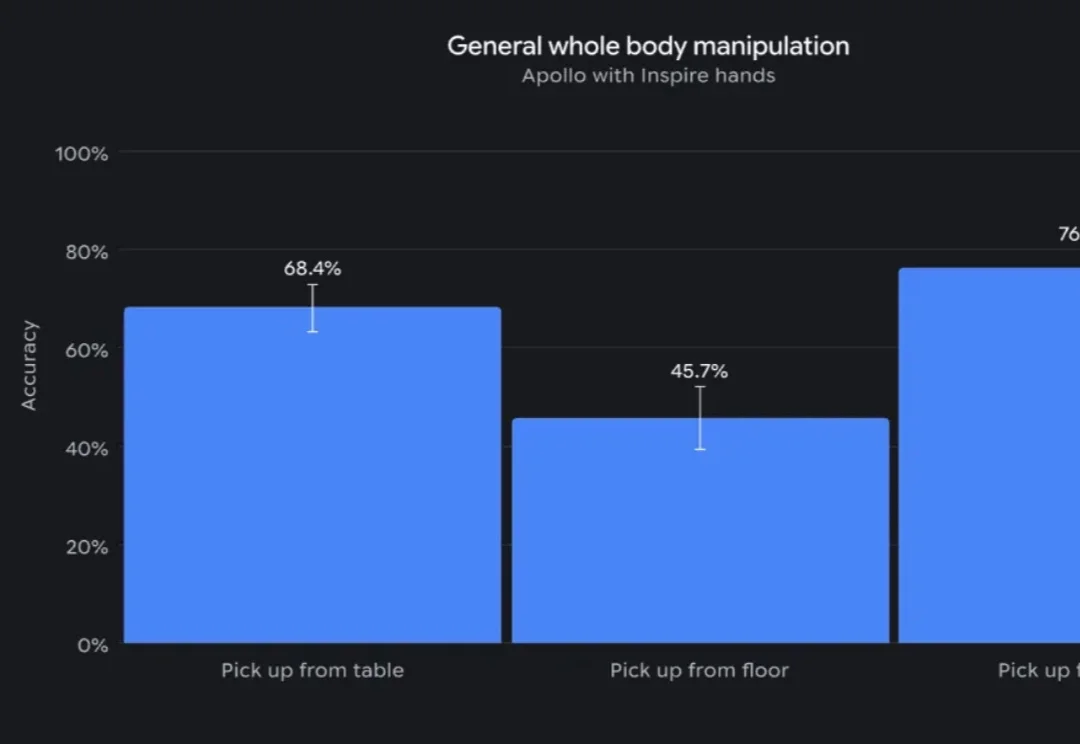
谷歌:在LLM圈里我唯唯诺诺,在机器人圈里我直接大打出手!
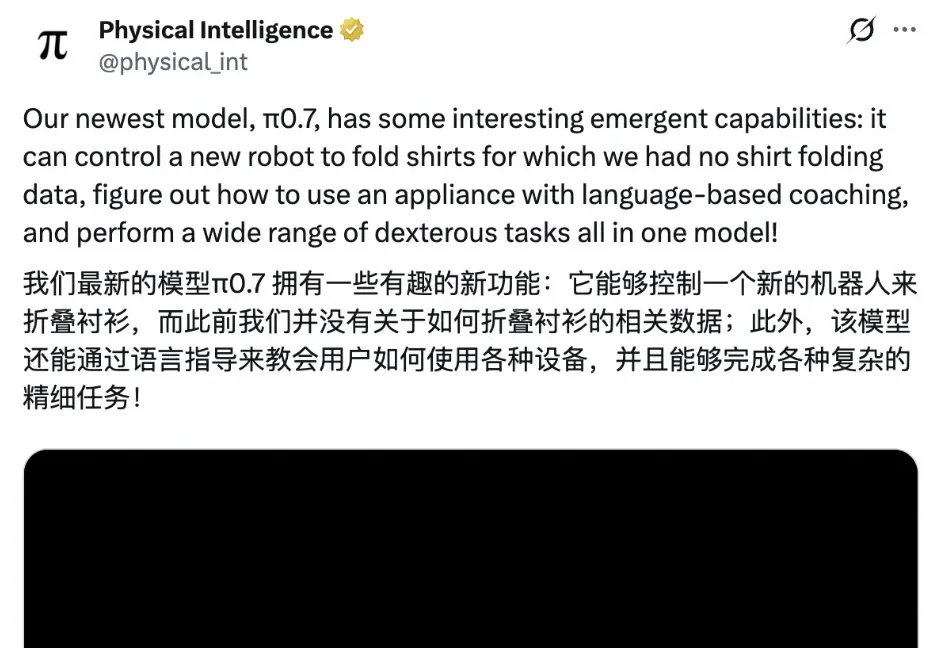
2026 WAIC 刚刚落幕,具身智能无疑是最受关注的技术方向之一。