NeurIPS 2026|VLM架构新突破:DGP打通全部ViT与LLM层,让大模型每一层按需「看图」
NeurIPS 2026|VLM架构新突破:DGP打通全部ViT与LLM层,让大模型每一层按需「看图」论文中的一道菜单题,看起来只需要做一次简单加法:一张 Funghi 披萨 6.90 欧元,一张 Prosciutto 披萨 7.90 欧元,总价是多少?
来自主题: AI技术研报
5352 点击 2026-11-11 10:27

 搜索
论文中的一道菜单题,看起来只需要做一次简单加法:一张 Funghi 披萨 6.90 欧元,一张 Prosciutto 披萨 7.90 欧元,总价是多少?
据Z Finance报道,周畅已离开字节Seed、转向Physical AI创业并获头部美元基金投资,但接近字节的人士否认离职;Seed将VLM并入LLM体系,折射出多模态统一路线调整。
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
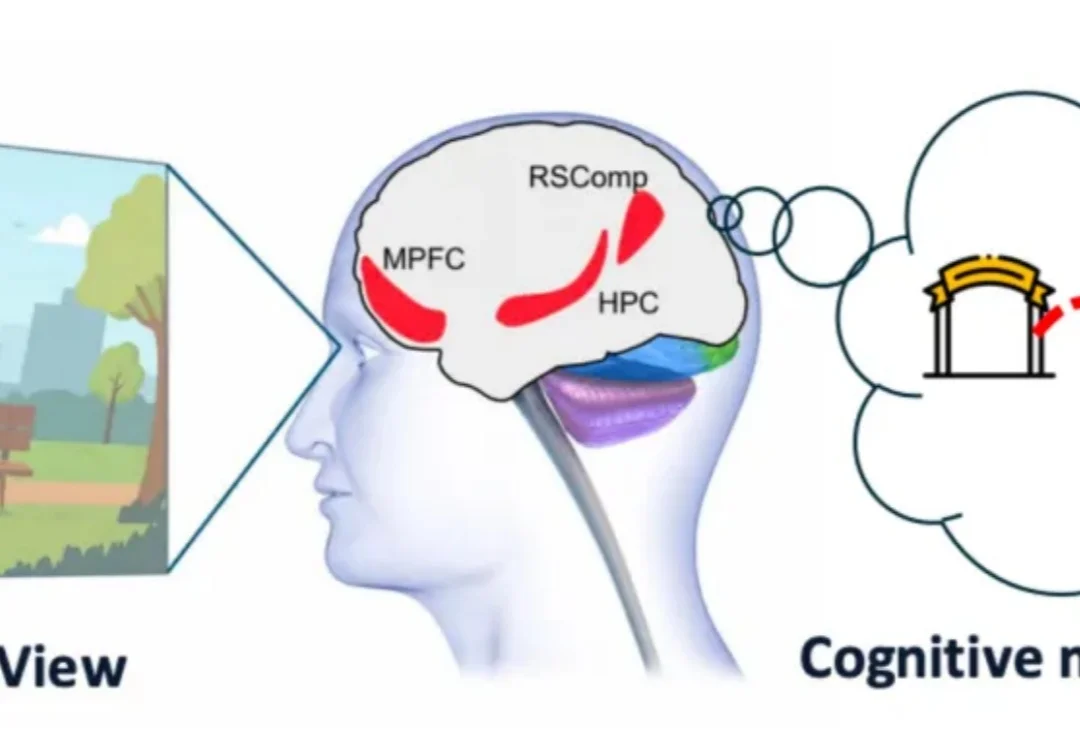
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
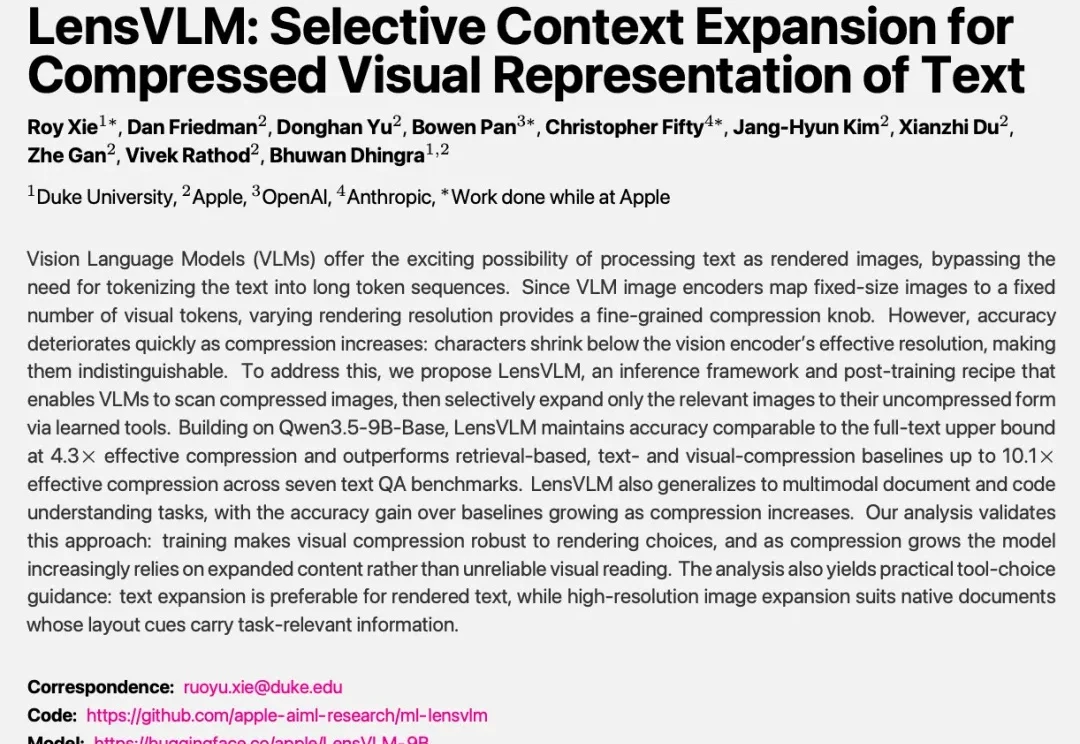
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。
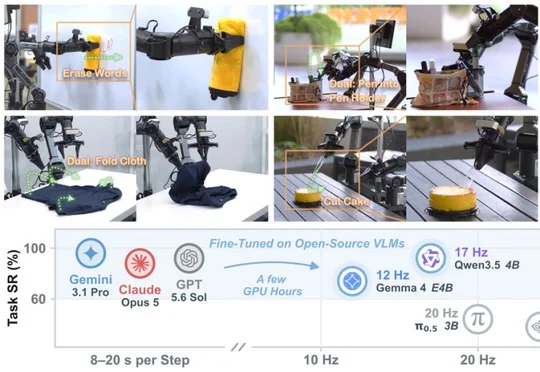
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。

字节Seed团队推出Seed-Evolving第五版更新,通过统一Model ID实现周级自动迭代,在Coding Agent长程任务完成度和VLM视觉理解能力上均有显著提升,用户一次接入即可享受模型持续进化。
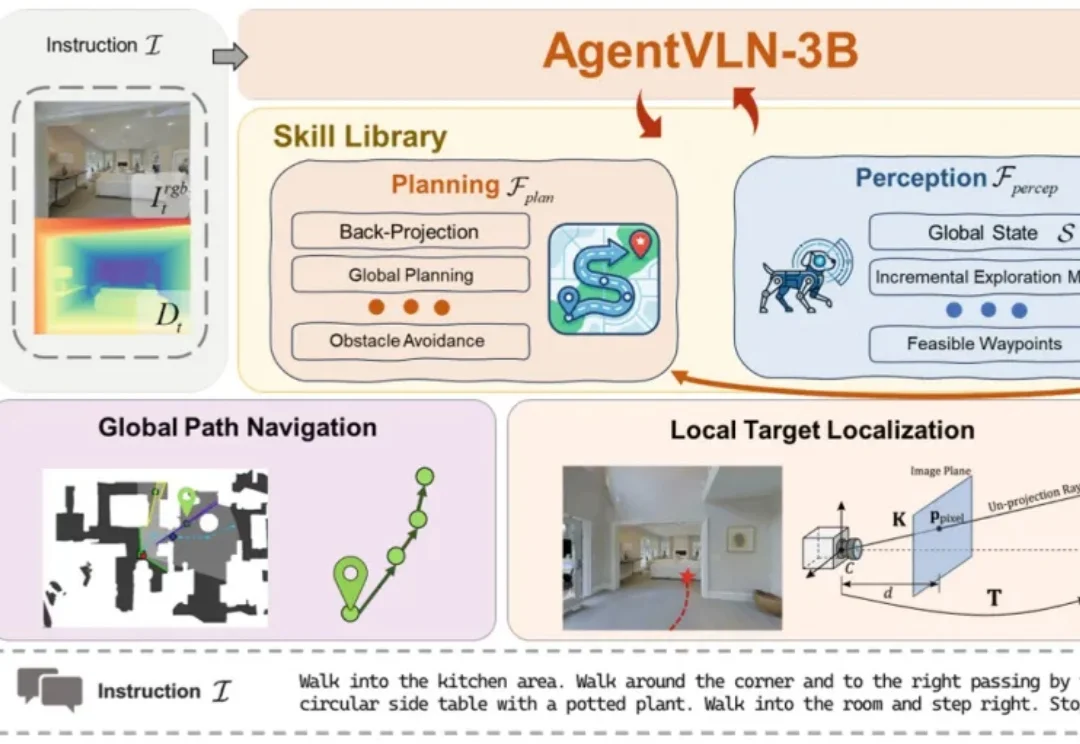
近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
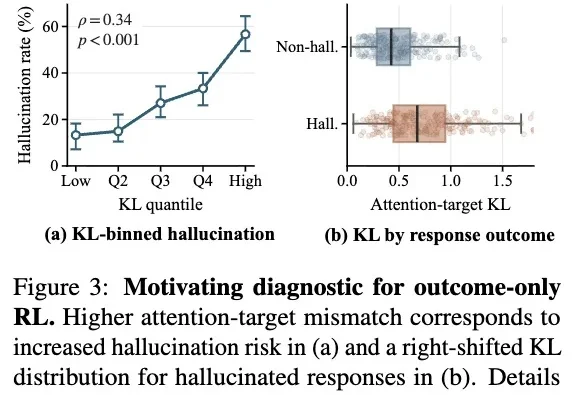
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。