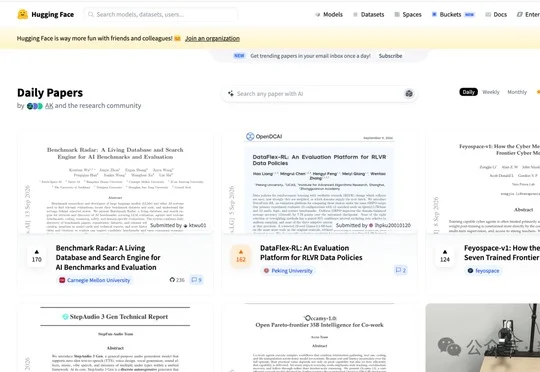
日榜第二!北大开源,强化学习数据策略接入更简单、对比更公平
日榜第二!北大开源,强化学习数据策略接入更简单、对比更公平这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
来自主题: AI技术研报
8025 点击 2026-09-25 10:07

 搜索
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。

由上海交大人工智能学院、深势科技、上海算法创新研究院组成的无尽前沿团队发布BigBang-V1——这是首个基于recursive self-improving原生方式训练出的基座模型。
给大模型加上第三种记忆格式,把宝贵的参数从死记硬背知识中解放出来!