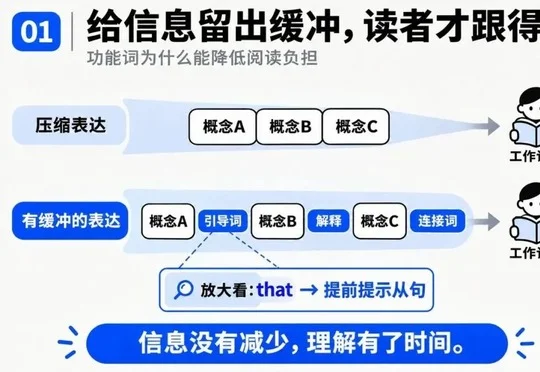
AI 写的东西越来越难懂,Gemini 是怎么做到「说人话」的?
AI 写的东西越来越难懂,Gemini 是怎么做到「说人话」的?文章分析前沿模型文字难懂的原因,指出 Google 通过 LearnLM 将易读性、命题保真度、认知负荷管理和强化学习后训练融入 Gemini 2.5 Pro 与 Flash,并介绍 UIDPO 和修辞结构对齐两种认知对齐路径。
来自主题: AI技术研报
7734 点击 2026-11-07 14:46

 搜索
文章分析前沿模型文字难懂的原因,指出 Google 通过 LearnLM 将易读性、命题保真度、认知负荷管理和强化学习后训练融入 Gemini 2.5 Pro 与 Flash,并介绍 UIDPO 和修辞结构对齐两种认知对齐路径。
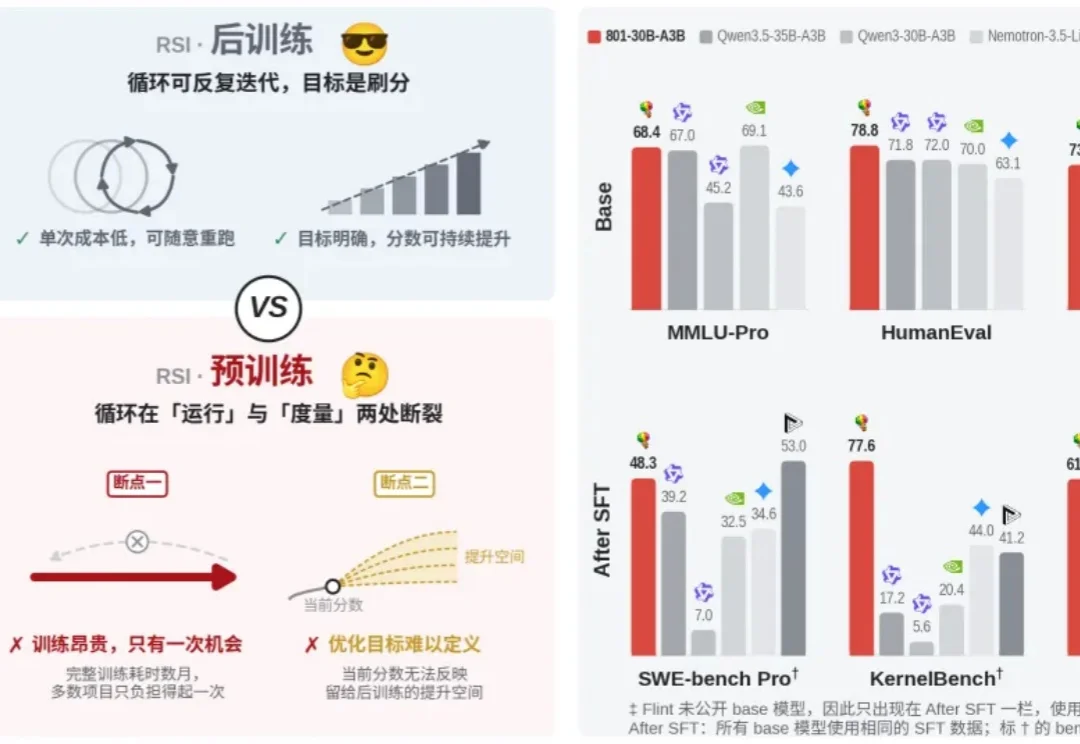
超智能这场竞赛的胜负手不在后训练,而在谁先跑通 RSI 预训练。
深度原理 DeepPrinciple 将 GLM-5.3 后训练为科学模型 Hydrogen-1.0,开放权重并纳入失败实验等实验室记录,使模型可完成实验设计、流程纠错和多步科研推理。
AI模型后训练公司Trajectory宣布完成4500万美元A轮融资,由红杉资本领投,英伟达、Bessemer Venture Partners和Bain Capital Ventures参投,估值达3亿美元,其基于持续学习的后训练平台已正式向公众开放。
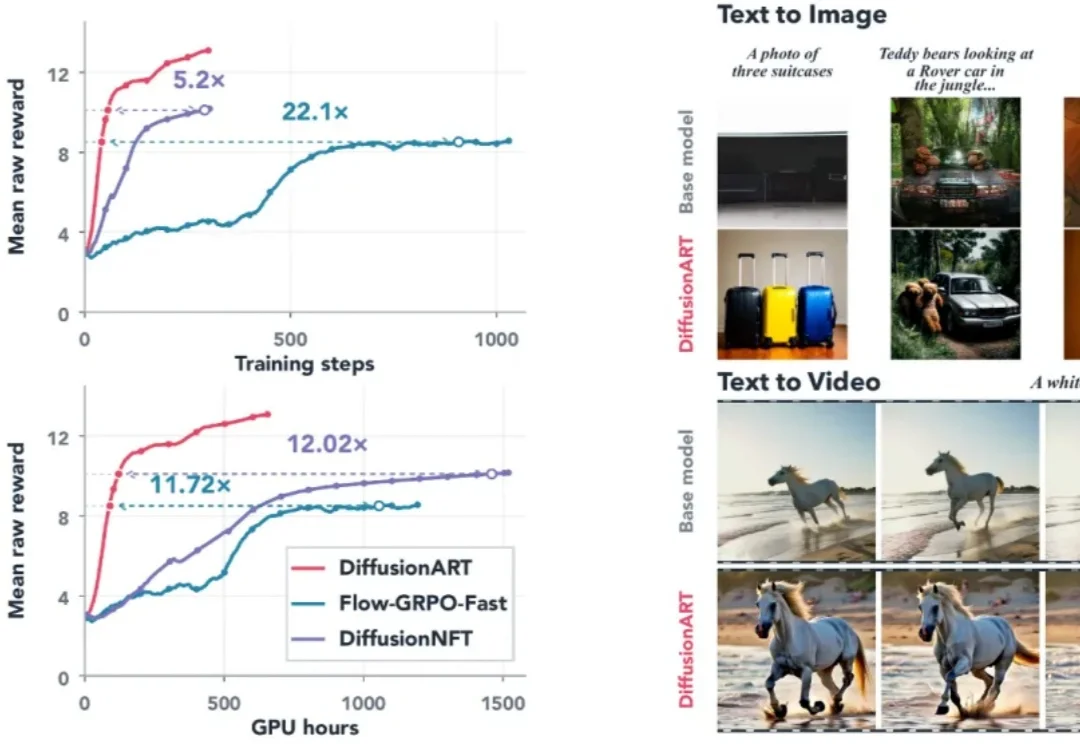
来自新加坡国立大学、可灵 AI 和香港科技大学的研究团队提出了 DiffusionART,一种面向图像和视频生成的在线 Diffusion RL 算法。该方法支持采用 ODE 采样,不要求奖励模型可微,也无需额外调参,可自然适配标量奖励、二值偏好奖励等多种奖励形式,具有极高的样本效率。
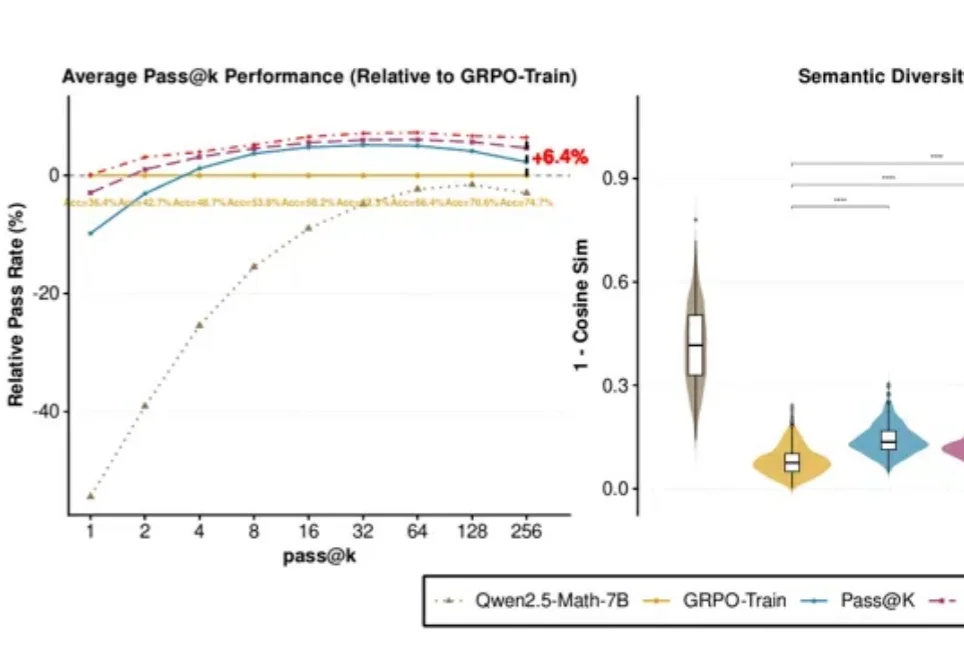
DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。
本周「十字路口」的嘉宾是李磊,小米 MiMo 大模型后训练研究员、香港大学在读博士。一边参与大模型训练,一边读 PhD,他和许多同学一样,面对着 AI 带来的巨大机会,也置身于飞速变化的节奏中:既兴奋,也焦虑。
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
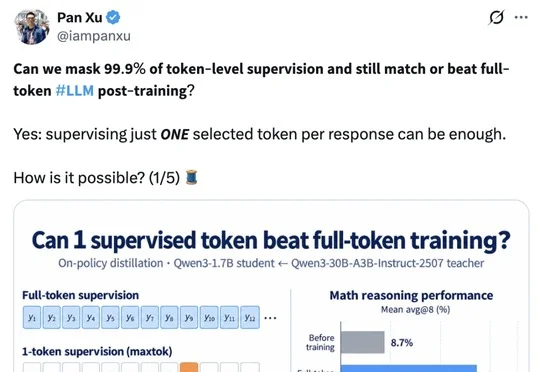
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
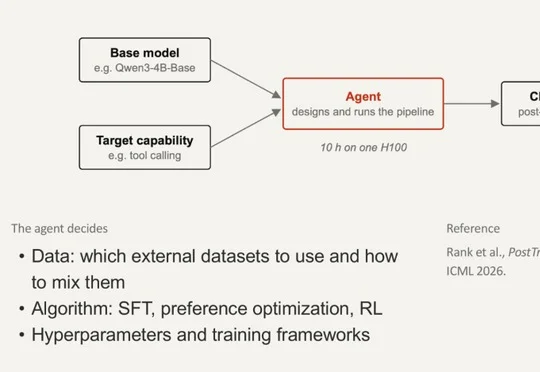
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain