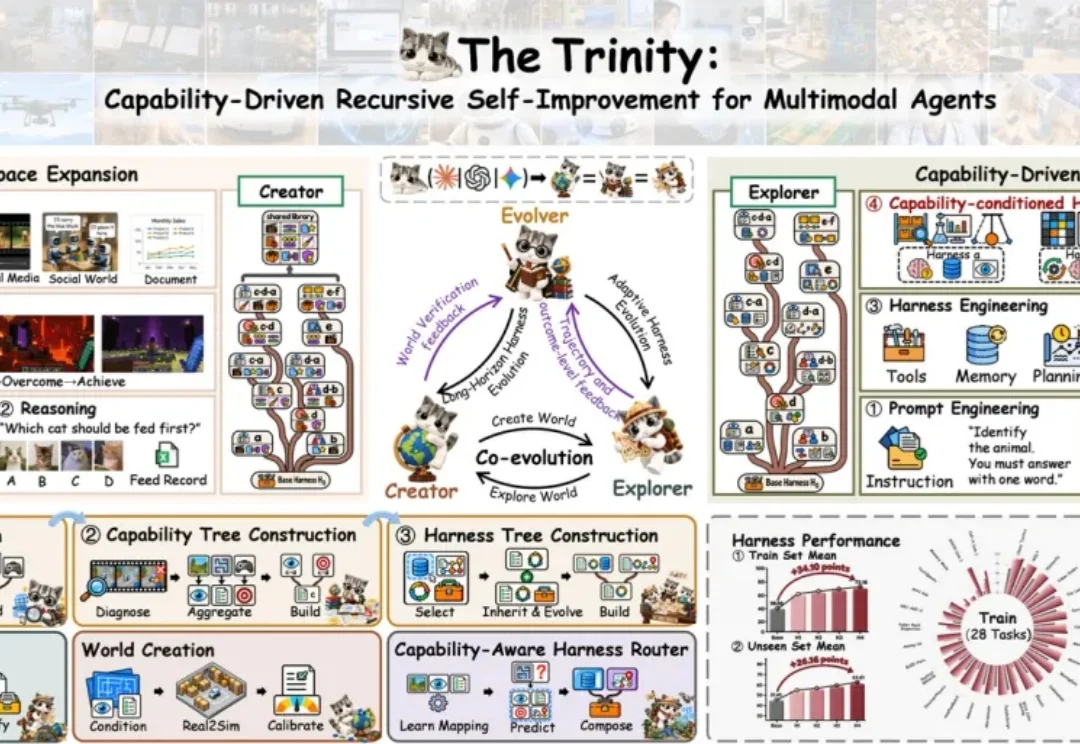
不再围绕任务进化!The Trinity提出能力驱动的多模态RSI新范式
不再围绕任务进化!The Trinity提出能力驱动的多模态RSI新范式改变 RSI 的基本演化单位,从任务转变为能力,有望从针对具体任务的局部优化,走向跨任务、跨模态的持续演化。
来自主题: AI技术研报
8067 点击 2026-11-12 10:21

 搜索
改变 RSI 的基本演化单位,从任务转变为能力,有望从针对具体任务的局部优化,走向跨任务、跨模态的持续演化。
多模态Agent交付亮眼,连“画地为牢”梗都接住了。
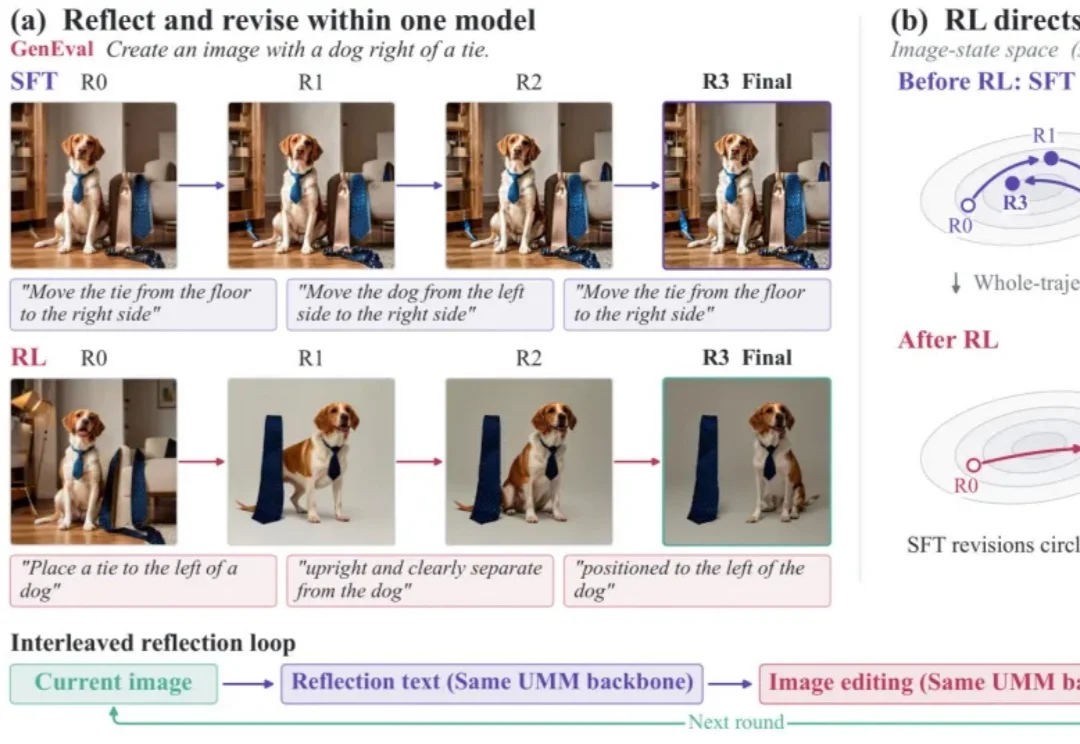
统一多模态模型既能看图,也能画图,那么它能不能像人一样,画完之后自己检查、发现问题、再动手改?
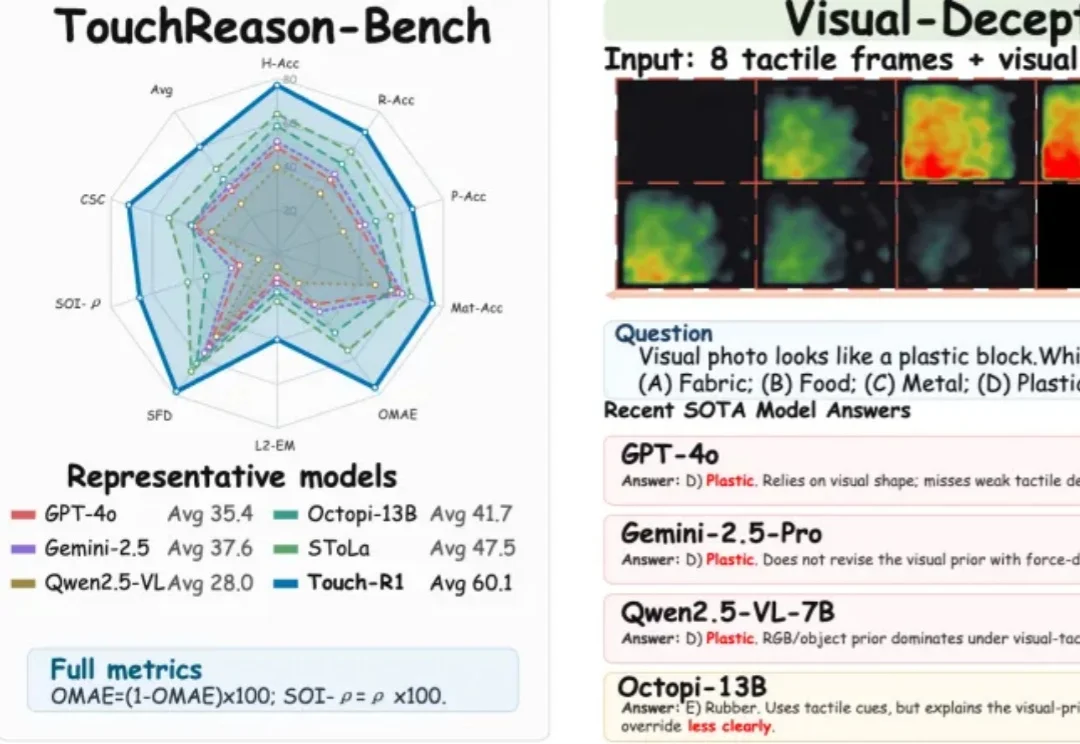
看起来像硬质塑料,按下去却十分柔软 —— 当视觉与触觉发生冲突,人类往往会依赖触感修正视觉误区;但现有的多模态模型却常常更相信视觉,从而误判物体的真实物理属性。
Triple T张江塔尖会技术沙龙聚焦具身智能数据战,嘉宾围绕人类视频、真机交互与仿真数据的选择组合、多模态采集、配方评测及规模化降本展开讨论,强调数据投入应匹配任务与训练阶段并以持续评测验证机器人能力收益。
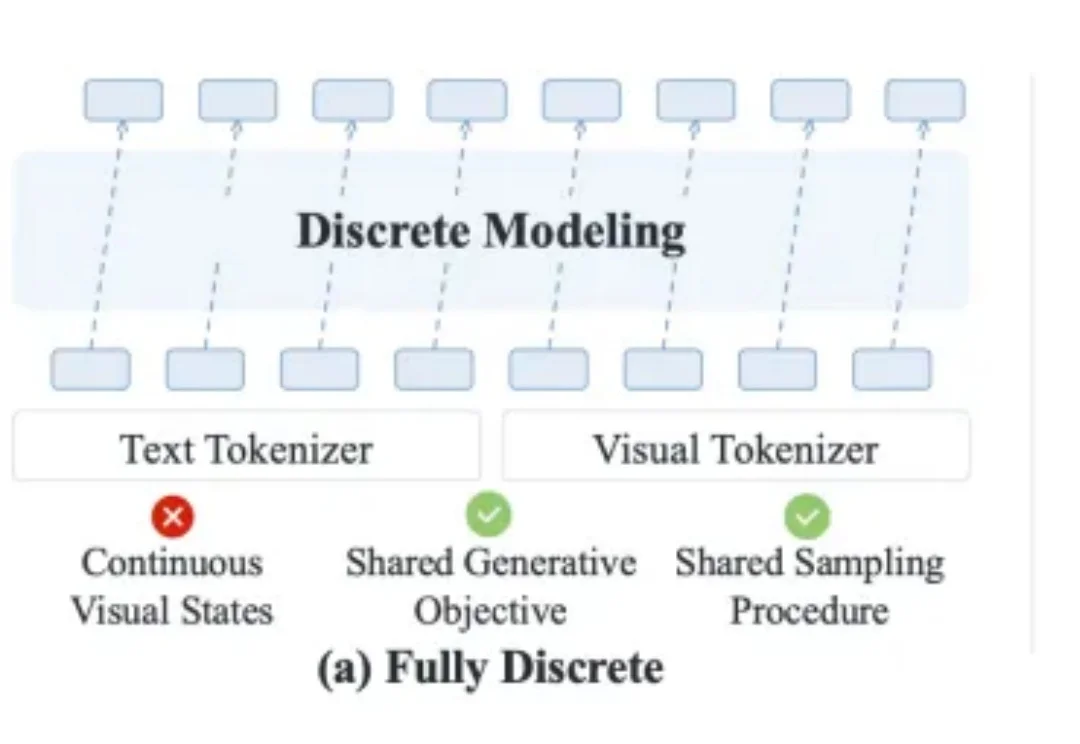
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
据Z Finance报道,周畅已离开字节Seed、转向Physical AI创业并获头部美元基金投资,但接近字节的人士否认离职;Seed将VLM并入LLM体系,折射出多模态统一路线调整。
商汤发布多模态智能体模型SenseNova 6.8 Flash,实测其用8分21秒读完582页招股书并生成可交互看板,制作8页PPT却耗时64分钟,同时支持动态海报、Agentic 3D设计与Figma工作流。
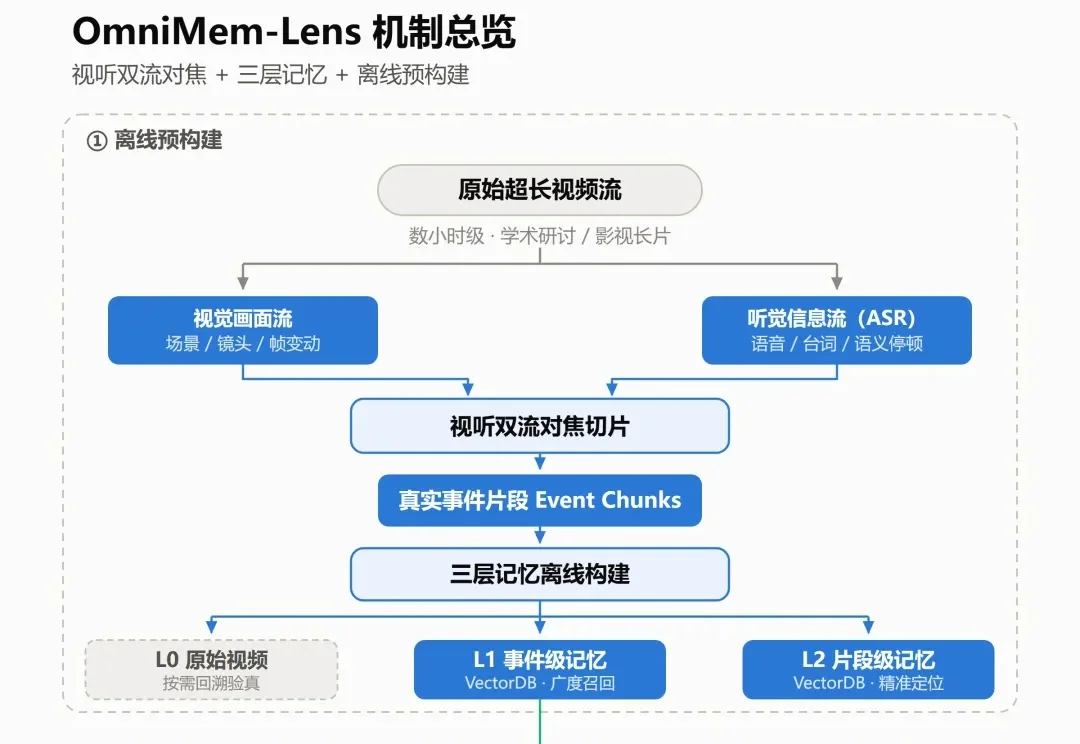
openJiuwen AgentMemory正式上线了多模态记忆能力OmniMem-Lens:按秒盲切是记忆碎片化的元凶,按真实事件记忆才是正解——召回精度最高提升45.7%,在线问答时延最高降低97%。
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。