肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA
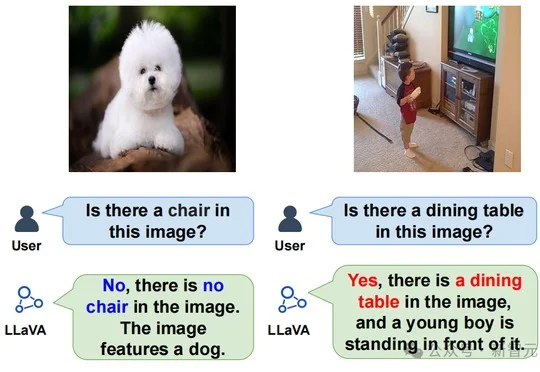
肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
来自主题: AI技术研报
9209 点击 2026-09-20 15:07

 搜索
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
豆包爱学2.0依托豆包多模态大模型与Seedance系列模型,将AI嵌入语数英等学科的问答、板书讲解、定制课程、听写和错题整理等学习全流程,同一对话入口即可围绕知识点不断生成完整学习内容,展现字节在AI教育场景的工程化能力。
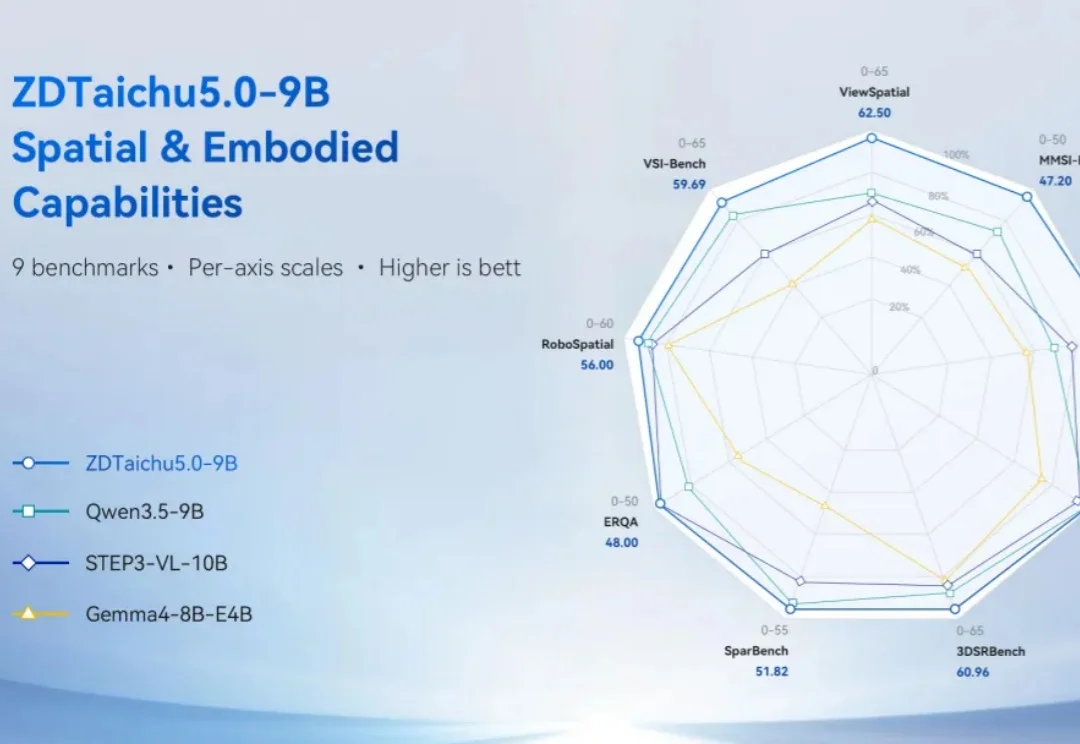
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
10B参数以内,空间具身能力同档第一的通用多模态大模型来了!
今天,我们上线并开源GLM-5.3-Flash (320B-A18B),这是GLM-5系列的首个原生多模态模型。大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash来了:320B总参数,能力超过GLM-5.2,在全球权威的Artificial Analysis Intelligence Index(AA综合智能指数)中取得57分
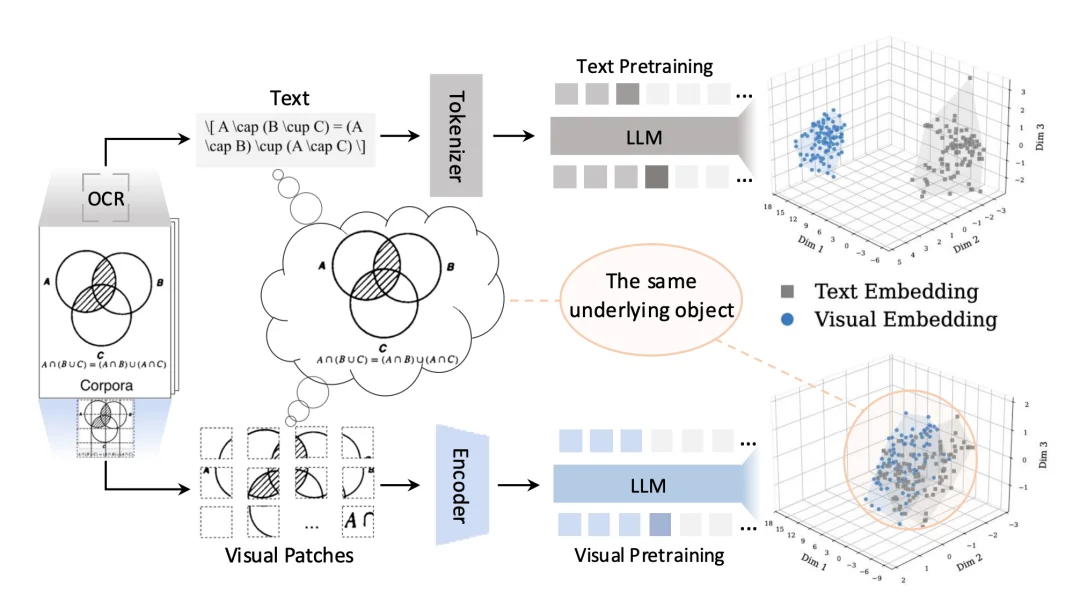
目前,这项技术已成功应用于上海人工智能实验室Intern-S2-Preview 35B/397B系列多模态大模型的预训练中,有效提升了模型的科学推理与多模态理解能力。值得一提的是,相关研发均基于国产昇腾算力平台完成,并成功实现了面向大规模预训练的深度适配与优化。
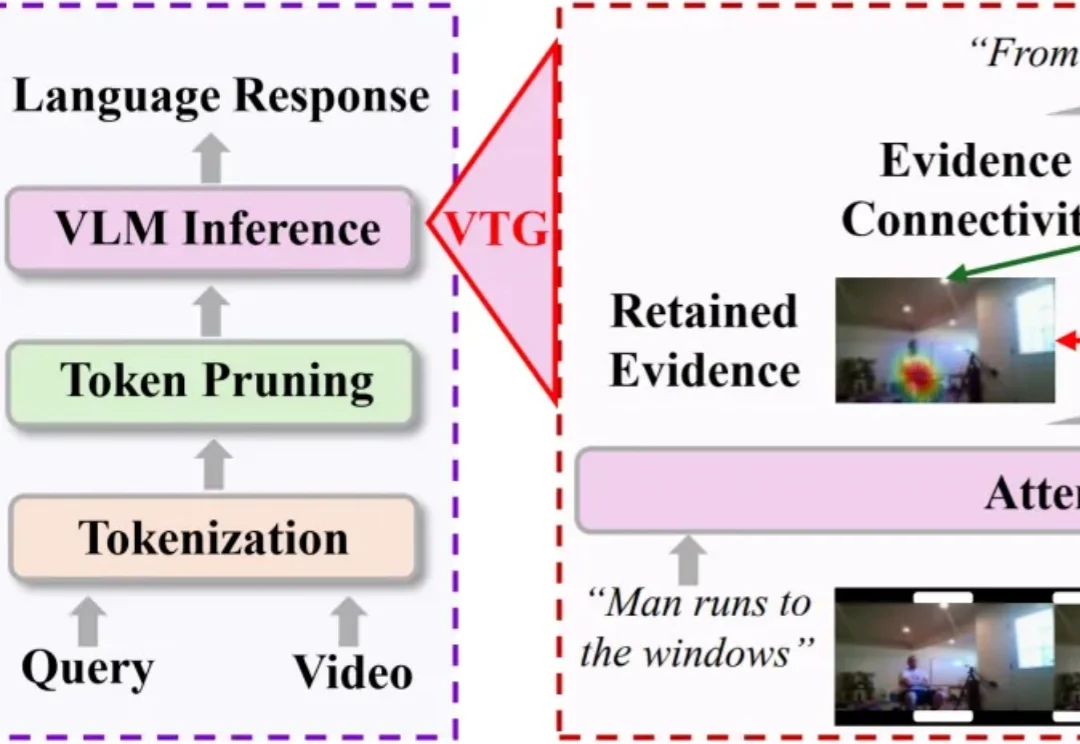
长视频理解,正在成为多模态大模型的重要能力。
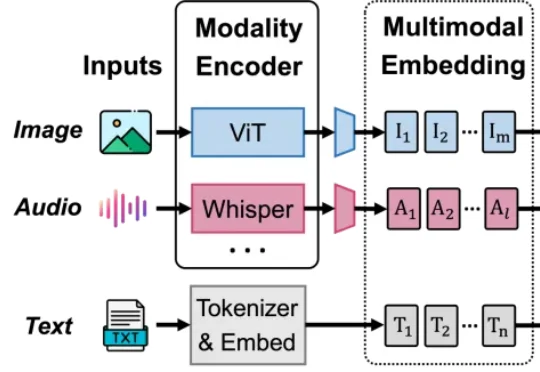
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
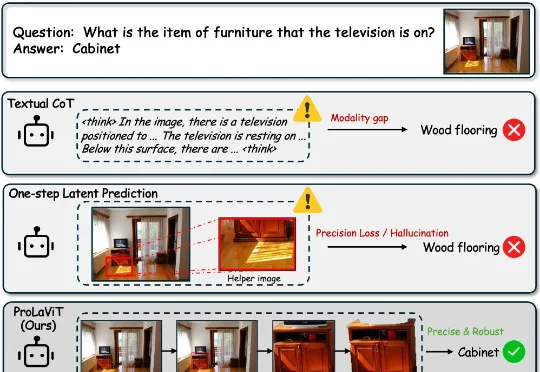
针对这一挑战,腾讯内容服务部 BAC 提出了一个名为 ProLaViT(Progressive Latent Visual Thought) 的全新框架。它的核心思想是:别急着下结论,先在连续隐空间里像人一样「步步推导」。 即让模型遵循 「定位 → 聚焦 → 分离」(Locate → Focus → Isolate) 的因果链,逐步收紧视觉注意力,最终精准锁定目标。
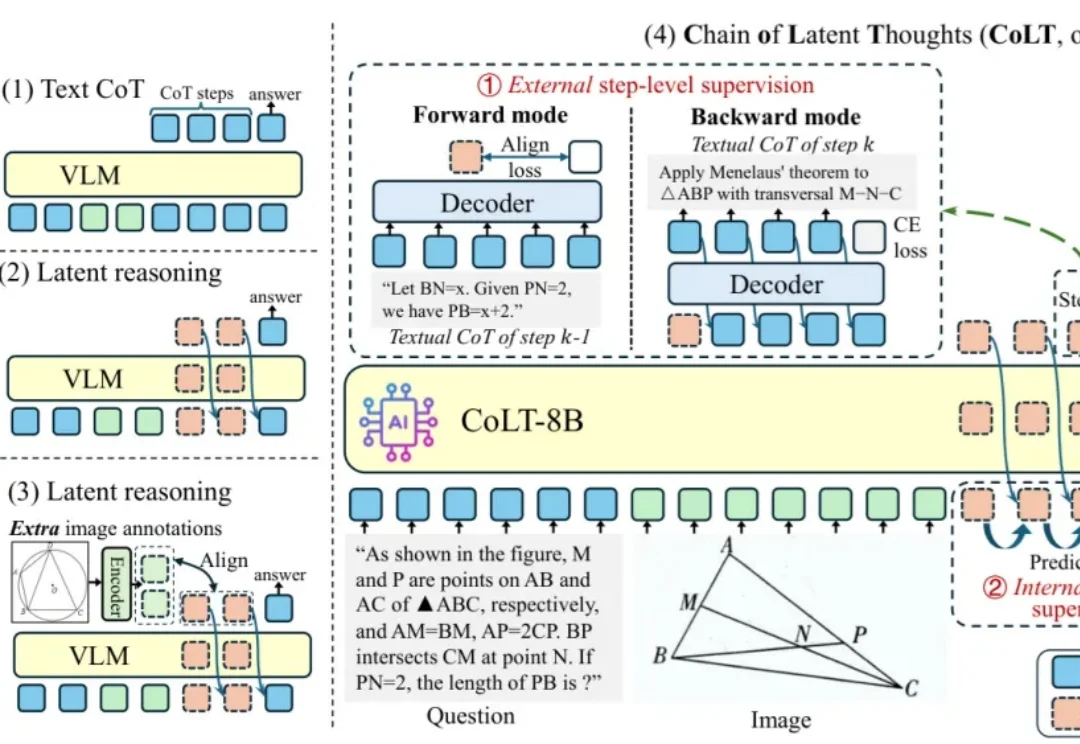
近年来,多模态大语言模型(MLLM)在视觉问答、图表理解、科学推理等任务上取得了令人瞩目的进展。