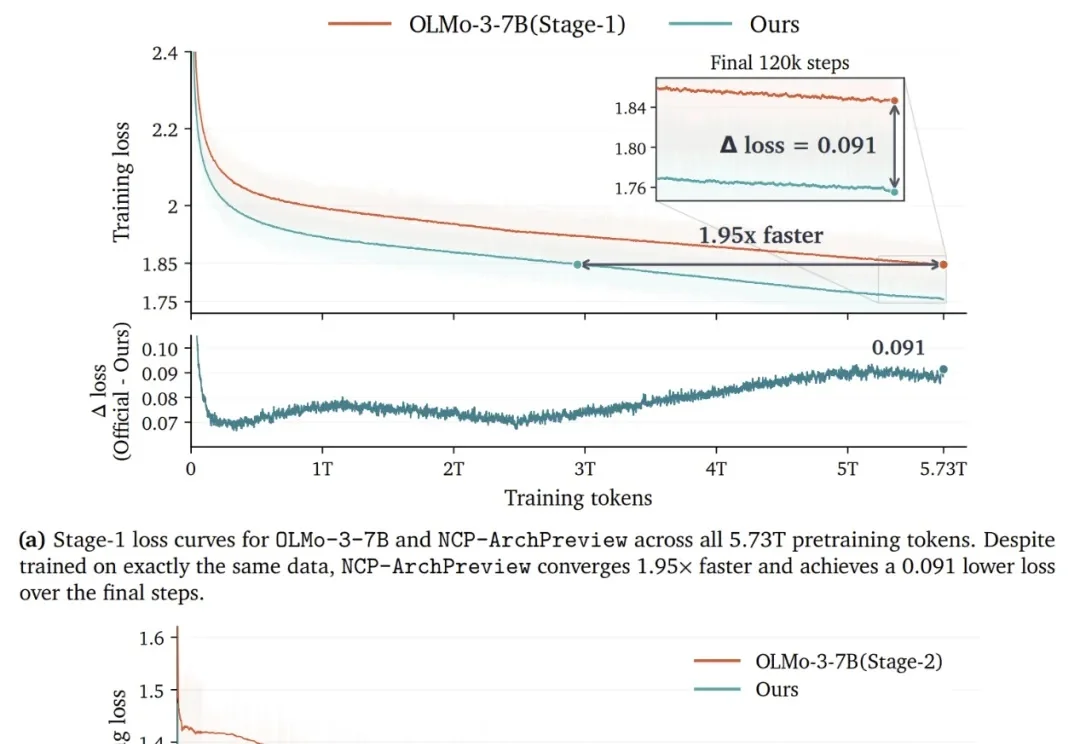
预训练Token消耗直接腰斩!上海AI Lab&上交大提出全新预训练任务,开源首个8.9B隐空间大模型NCP-ArchPreview
预训练Token消耗直接腰斩!上海AI Lab&上交大提出全新预训练任务,开源首个8.9B隐空间大模型NCP-ArchPreview自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
搜索
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
Codex、Claude Code等数字世界智能体,已经向我们展示出了一种全新且高效的工作方式:大模型理解目标,拆解任务,调用适当的工具,并根据执行结果不断调整计划,直到完成任务。
《读佳》获知,腾讯推出面向外部行业人才的专家平台“混元智囊团”,平台Slogan为“聚智为谋,引领未来”。该平台隶属于腾讯混元旗下,通过连接各领域顶尖实战专家与真实AI训练问题,以高质量数据集生产、专业内容编写、知识审核为核心工作,产出的专家资源与专业数据服务于混元大模型持续迭代优化。
最近,一个不会说话的大模型在网上火了。
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
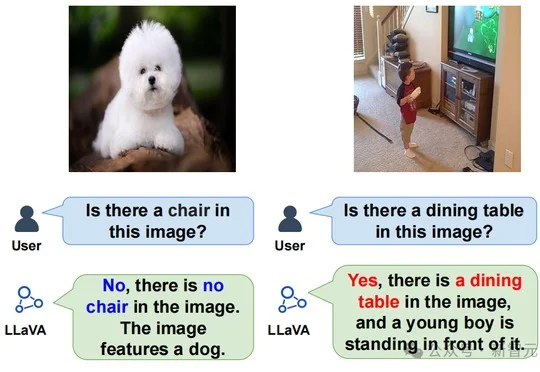
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
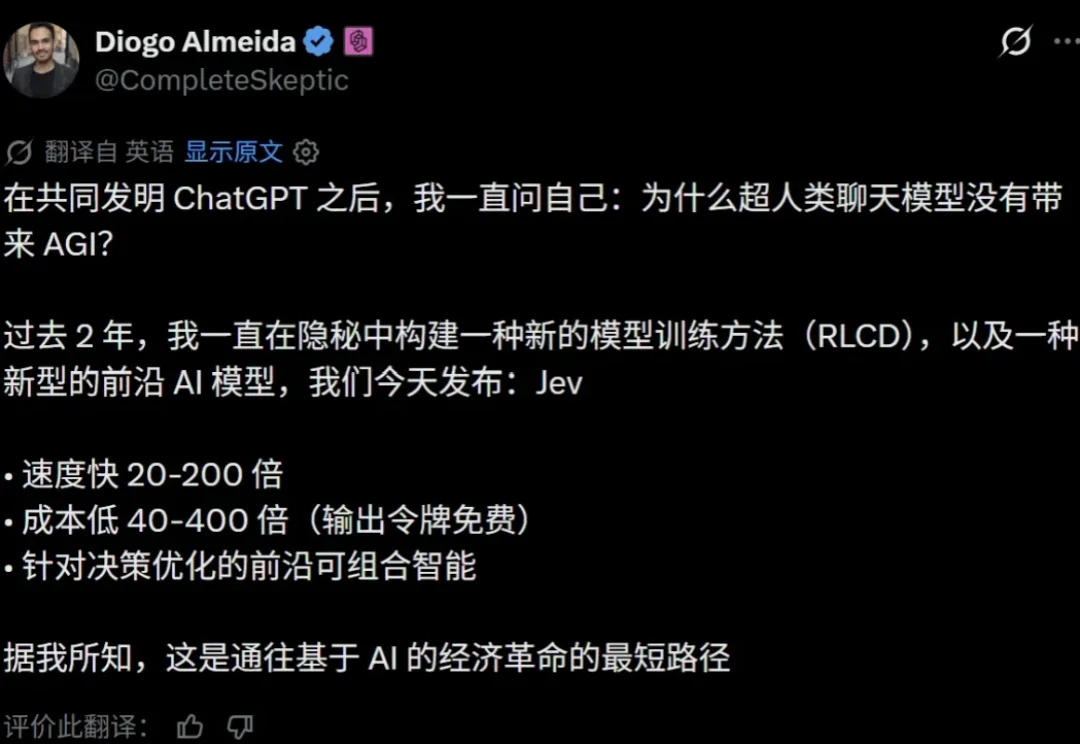
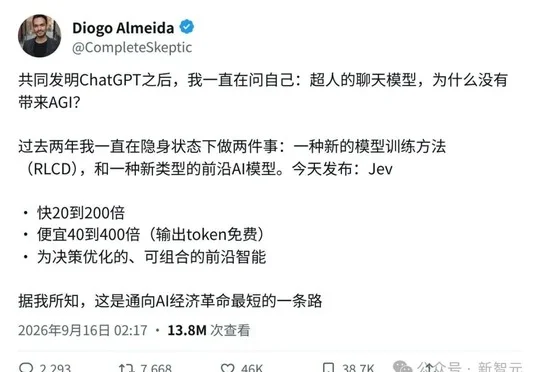
就在今天,整个硅谷都被Jev刷屏了!发布仅三天,它就被Vercel、Cloudflare和LangChain等主流平台迅速集成,有人说,我们即将迎来自动化智能的大爆发!而这场狂欢的主角,竟然是一个不会说话的大模型。
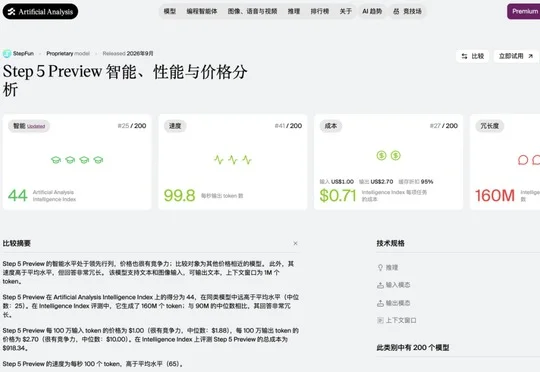
阶跃星辰发布开源旗舰基础模型Step 5 Preview,在Artificial Analysis Intelligence Index中以44分跻身全球开源模型前三,并依托全模态模型矩阵和在手机、汽车等终端的超4200万台规模化落地,重新跻身国产基础模型公司第一梯队。
Nature报道独立研究者训练的历史语言模型GPT-1900在仅掌握1900年前知识的条件下,虽在光电效应问题上冒出类似爱因斯坦光量子的表述,但因高度依赖人类整理的提示且训练过程未能完全隔绝现代AI影响,在多数物理任务上表现失败,揭示当前大模型仍缺乏提出全新解释框架的"溯因飞跃"能力,距离真正科学家仍有距离。
研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。