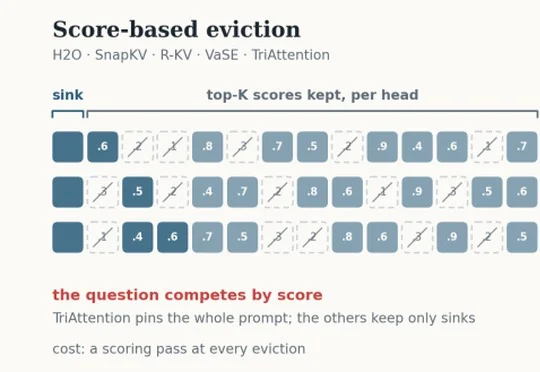
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
来自主题: AI技术研报
8761 点击 2026-09-20 11:05

 搜索
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
谷歌DeepMind疑似下一代旗舰模型Gemini 4 Pro以"gemini-3.8-flash"之名匿名亮相大模型竞技场Arena,在编码、智能体和推理等基准测试中全面超越Astra和Fable,并在网页设计、SVG、3D建模及游戏生成等实测中表现出色。
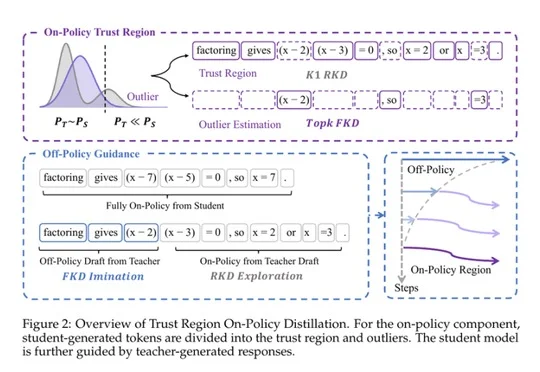
三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
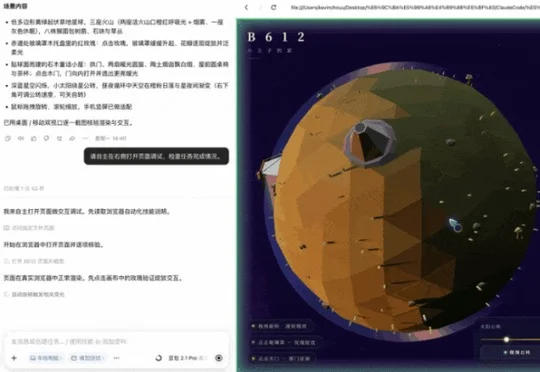
字节跳动发布新版豆包2.1 Pro(0915版本),重点升级多模态编程与视觉理解能力,可依据设计图、图纸和操作录屏生成代码,编辑团队通过山西3D旅行导览、小王子微缩星球等场景实测,验证其在Agent任务交付与Token效率方面的提升。
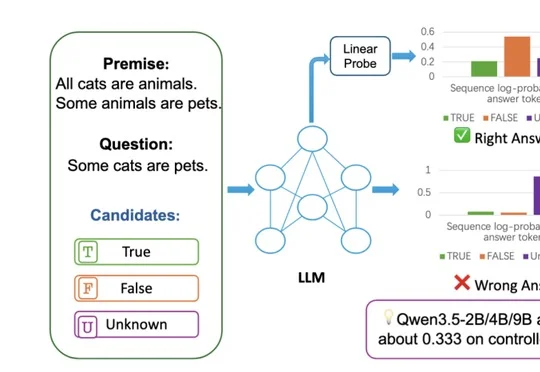
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
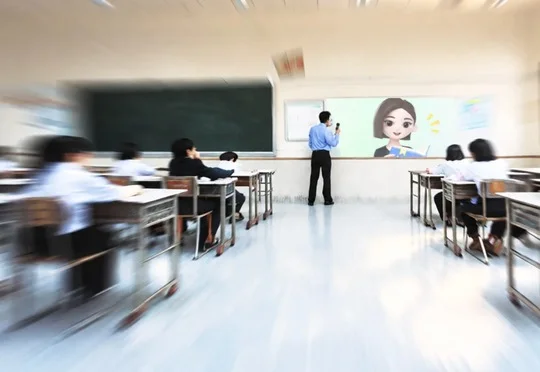
豆包爱学2.0依托豆包多模态大模型与Seedance系列模型,将AI嵌入语数英等学科的问答、板书讲解、定制课程、听写和错题整理等学习全流程,同一对话入口即可围绕知识点不断生成完整学习内容,展现字节在AI教育场景的工程化能力。
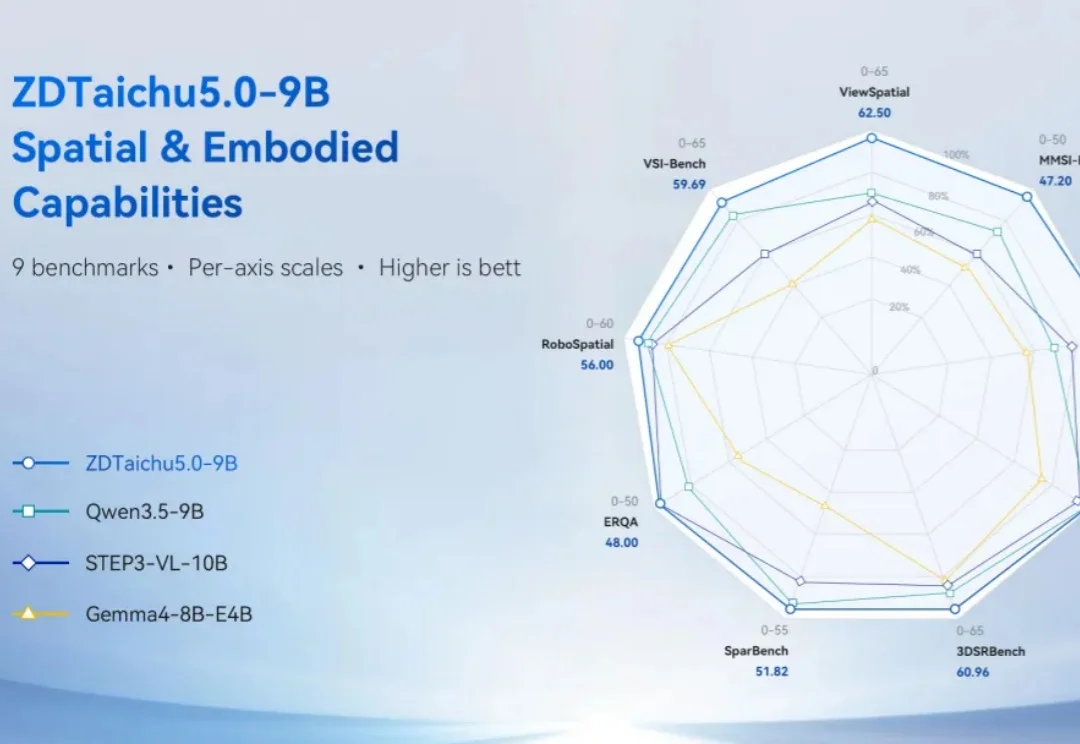
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
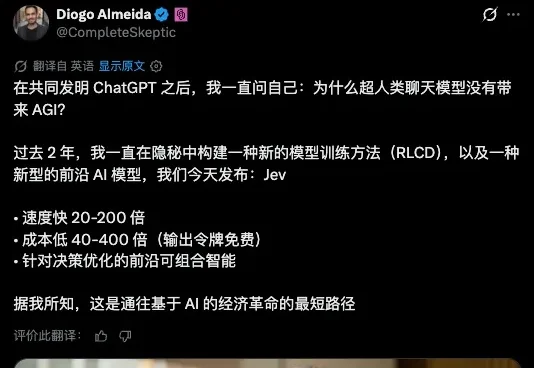
这两天,如果说最火的大模型是什么,那可能只有一个名字。
小布、ColorOS 17 与「AI 硬件」
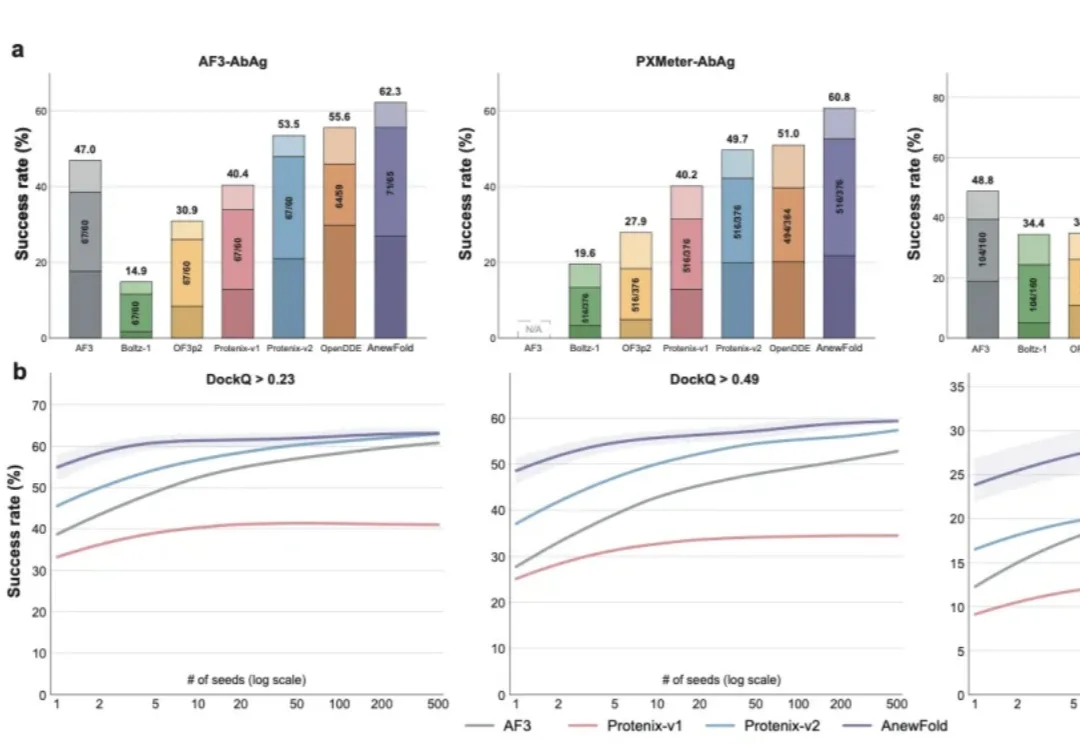
一笔融资、一份技术报告,让一个过去五年鲜少公开发声的团队,逐渐显露出更完整的面貌。