BAI 资本成员企业 Humanlaya 完成数亿元 Pre-A 轮融资,AI 后训练进入“专家数据”时代
BAI 资本成员企业 Humanlaya 完成数亿元 Pre-A 轮融资,AI 后训练进入“专家数据”时代BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
搜索
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
大模型训练拼的是算力,Agent训练拼的是环境。
大模型江湖变天了。
在大模型在拼命刷 Benchmark 卷编程的时候,「不能说话」的 Jev 却意外成了 AI 圈的新顶流,究其原因,大模型应用的价值正在从「生成什么」,进一步延伸到「能否理解复杂信息,并据此做出可靠判断」。
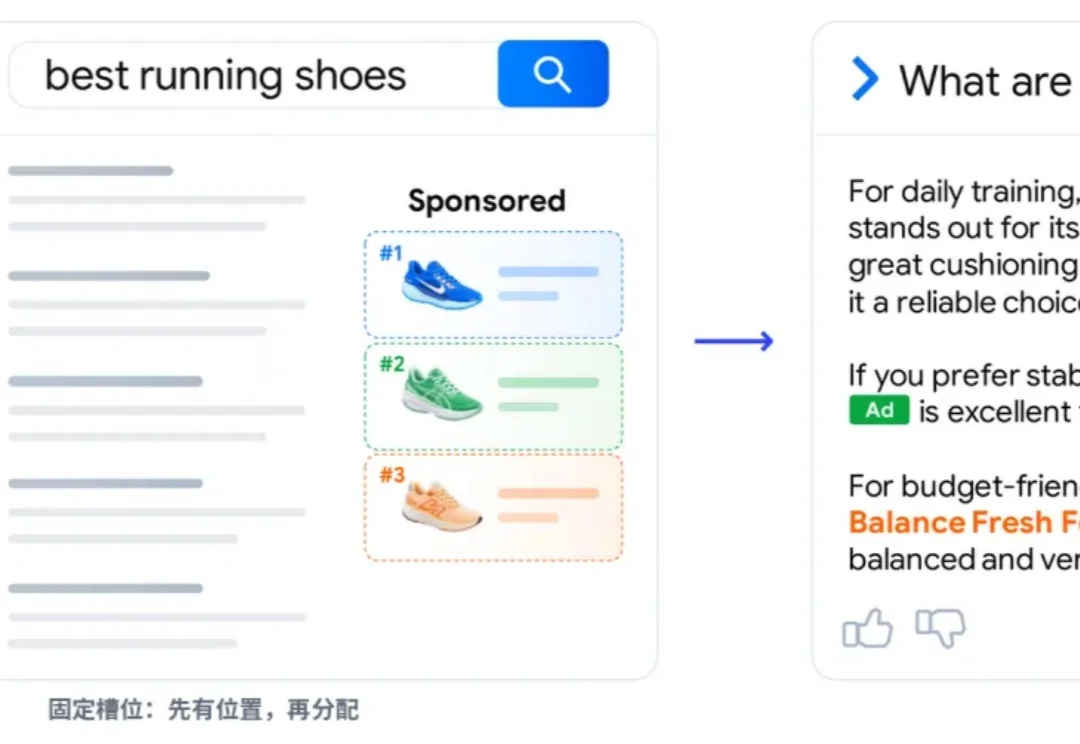
搜索结果里但凡出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。Pew Research Center 对美国用户在 Google 上大规模浏览行为的分析发现:有 AI 摘要时,用户点击传统搜索结果的比例从 15%直接暴跌至 8%。
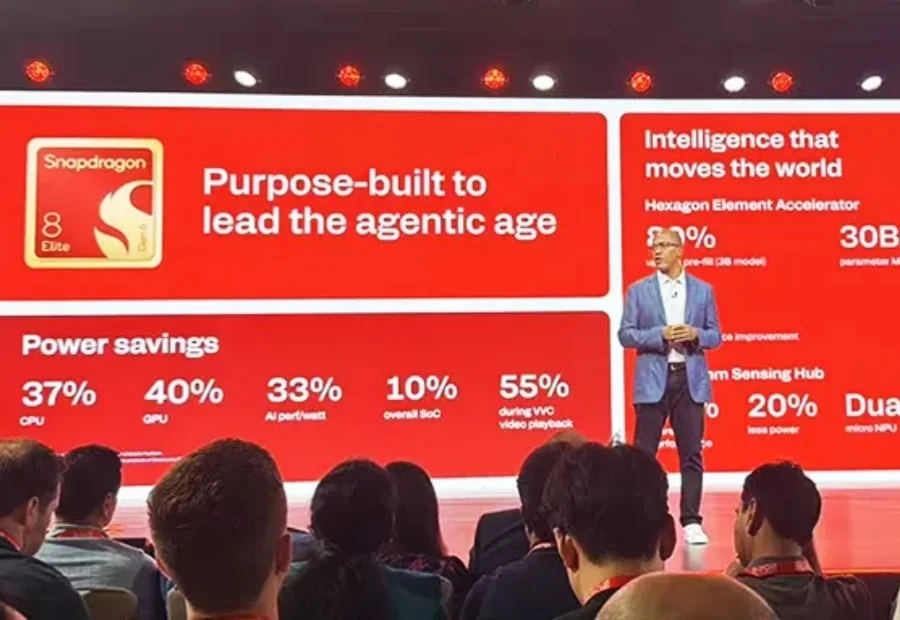
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
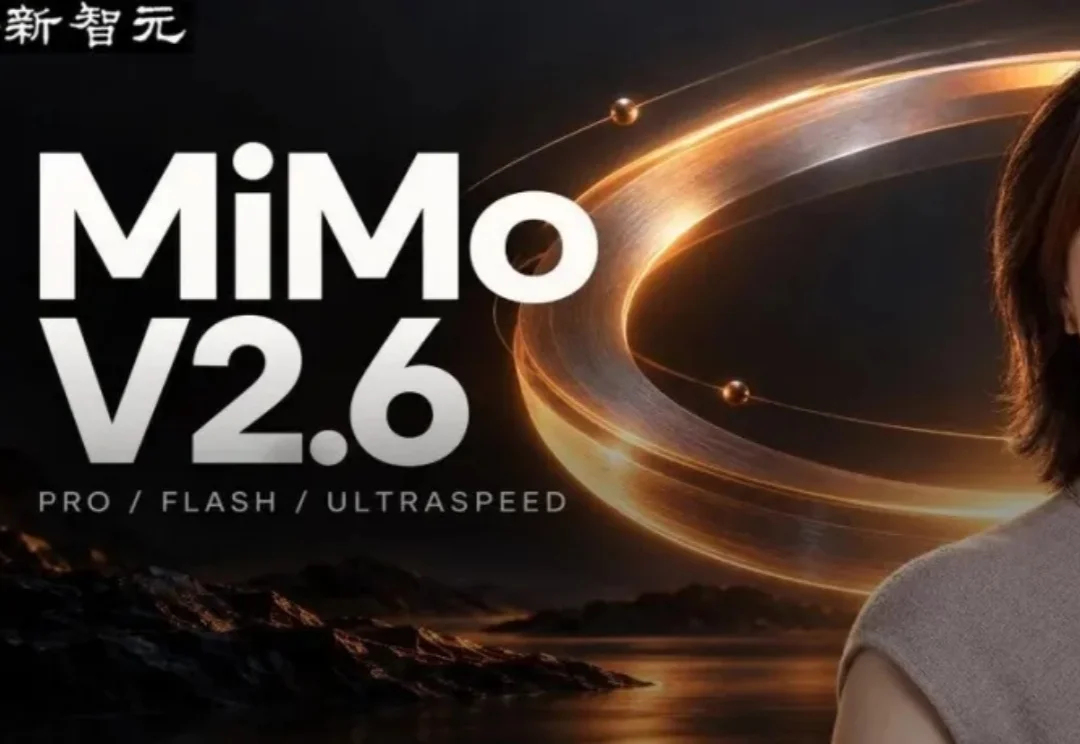
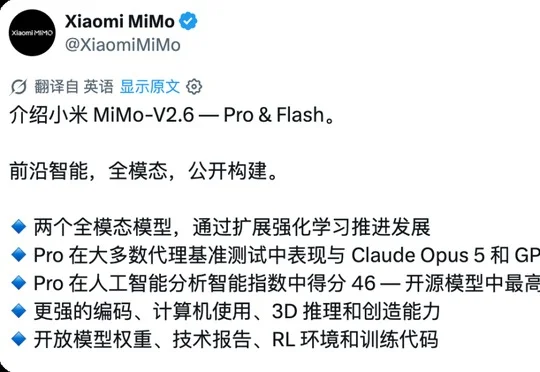
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
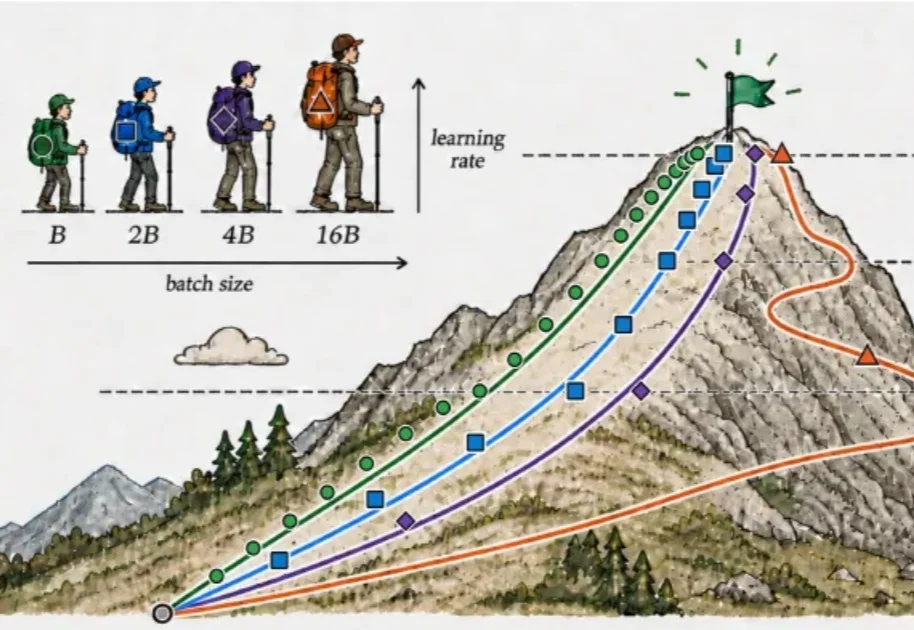
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
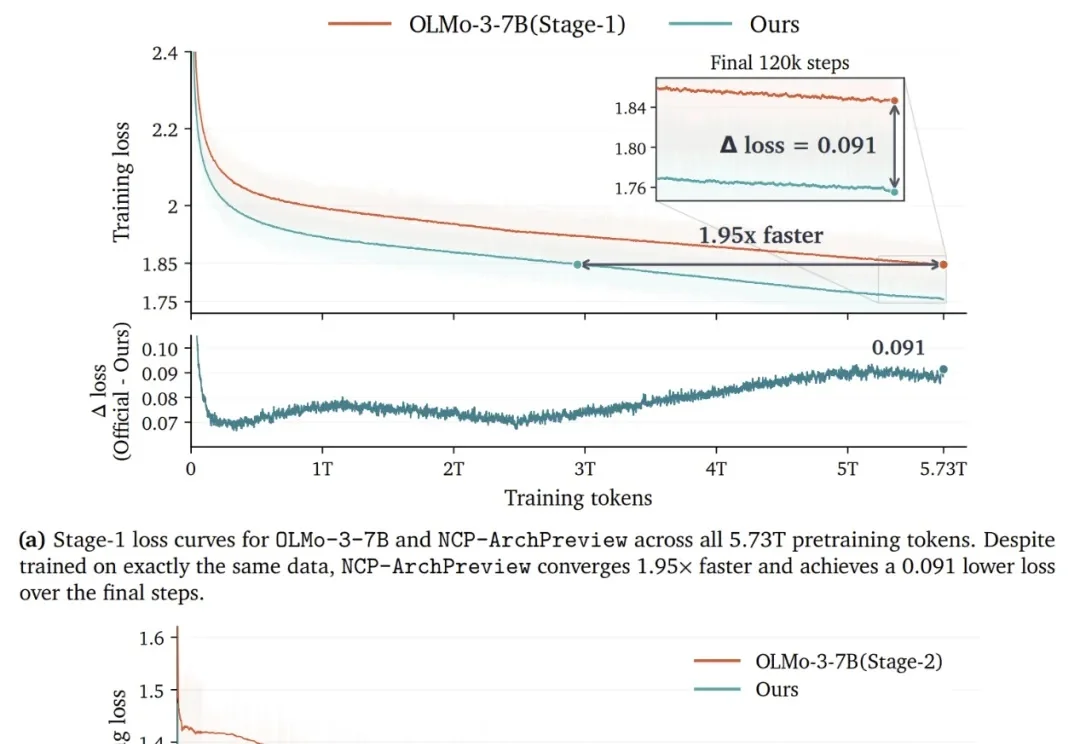
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
Codex、Claude Code等数字世界智能体,已经向我们展示出了一种全新且高效的工作方式:大模型理解目标,拆解任务,调用适当的工具,并根据执行结果不断调整计划,直到完成任务。