五年前的一次选择,成了中国智能时代的王炸
五年前的一次选择,成了中国智能时代的王炸五年前中科曙光立项曙光8000时提前押注"超智融合"路线,建成中国首个全国产十万卡AI超集群,将高精度科学计算与AI大模型训练集成于同一系统,近日随央视纪录片《超级工程》完整呈现其五年技术攻关与落地的全过程。
来自主题: AI资讯
7546 点击 2026-09-28 09:52

 搜索
五年前中科曙光立项曙光8000时提前押注"超智融合"路线,建成中国首个全国产十万卡AI超集群,将高精度科学计算与AI大模型训练集成于同一系统,近日随央视纪录片《超级工程》完整呈现其五年技术攻关与落地的全过程。
OpenAI、Anthropic及国内十家主要大模型厂商平均每6天推出一款新旗舰模型,AI已大规模参与下一代模型研发,导致模型迭代速度首次超过人类适应速度,开发者调好的提示词和参数频繁面临报废。
前华为云盘古大模型CTO李寅与多模态首席科学家张含望联合创立的息壤开物宣布完成数亿元种子轮及天使轮融资(估值5亿美金),旨在训练面向物理世界的大物理模型(LPM),寻找物理世界的Scaling Law。
科大讯飞推出基于全国产算力训练的语音识别大模型Spark-ASR-2.0,依托语音基座大模型Spark-Audio-1.0-Preview,在方言免切换识别、嘈杂环境、上下文纠错和口语规范化等方面均有提升,整体推理成本较Spark-ASR-1.0仅增10%,已上线讯飞输入法并通过讯飞开放平台提供API服务。
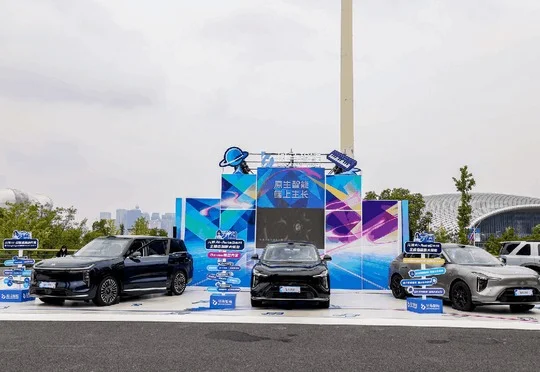
斑马智能在2026云栖大会发布面向智能终端的全模态端侧大模型AutoOmni 2.0-23B-A3B,主张智能汽车是具身智能最大的中试场,端侧AI基础设施将决定AI能否在真实世界被真正深度使用。
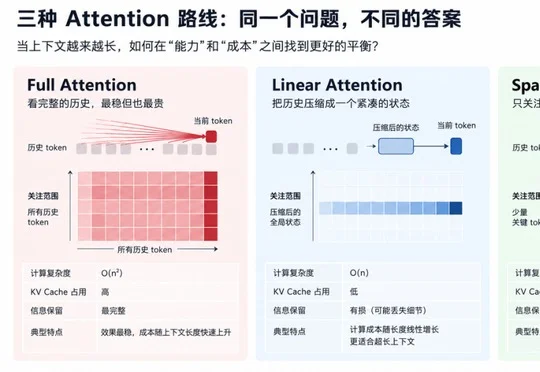
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
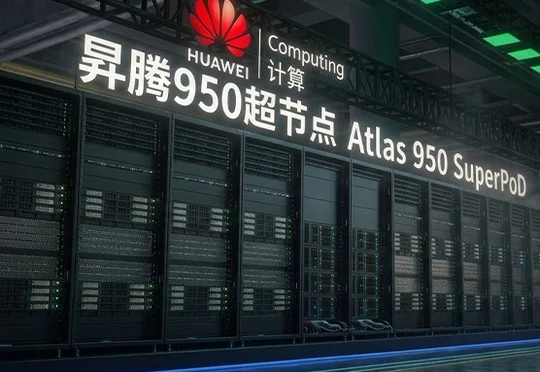
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
Z Potentials获悉,Physical AI公司息壤开物近日连续完成数亿元种子轮及天使轮融资,目前估值达5亿美元。本轮融资由敦鸿资产领投,华控基金、三花控股、银杏谷资本、泽然资本、本坚基金、天使基石、标朴投资等机构跟投。募集资金将主要用于原生物理AI模型的规模预训练、真实物理交互数据建设、核心研发人才引入及场景验证。
9月18日,亚马逊云科技官宣,旗下大模型服务平台Bedrock正式托管Kimi K3。国产模型上线海外云平台并非新鲜事。但是作为开源模型,开始让美国云厂商愿意"交钱" ,Kimi确实是独一份。