五年前的一次选择,成了中国智能时代的王炸
五年前的一次选择,成了中国智能时代的王炸五年前中科曙光立项曙光8000时提前押注"超智融合"路线,建成中国首个全国产十万卡AI超集群,将高精度科学计算与AI大模型训练集成于同一系统,近日随央视纪录片《超级工程》完整呈现其五年技术攻关与落地的全过程。
来自主题: AI资讯
7630 点击 2026-09-28 09:52

 搜索
五年前中科曙光立项曙光8000时提前押注"超智融合"路线,建成中国首个全国产十万卡AI超集群,将高精度科学计算与AI大模型训练集成于同一系统,近日随央视纪录片《超级工程》完整呈现其五年技术攻关与落地的全过程。
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
大模型训练拼的是算力,Agent训练拼的是环境。
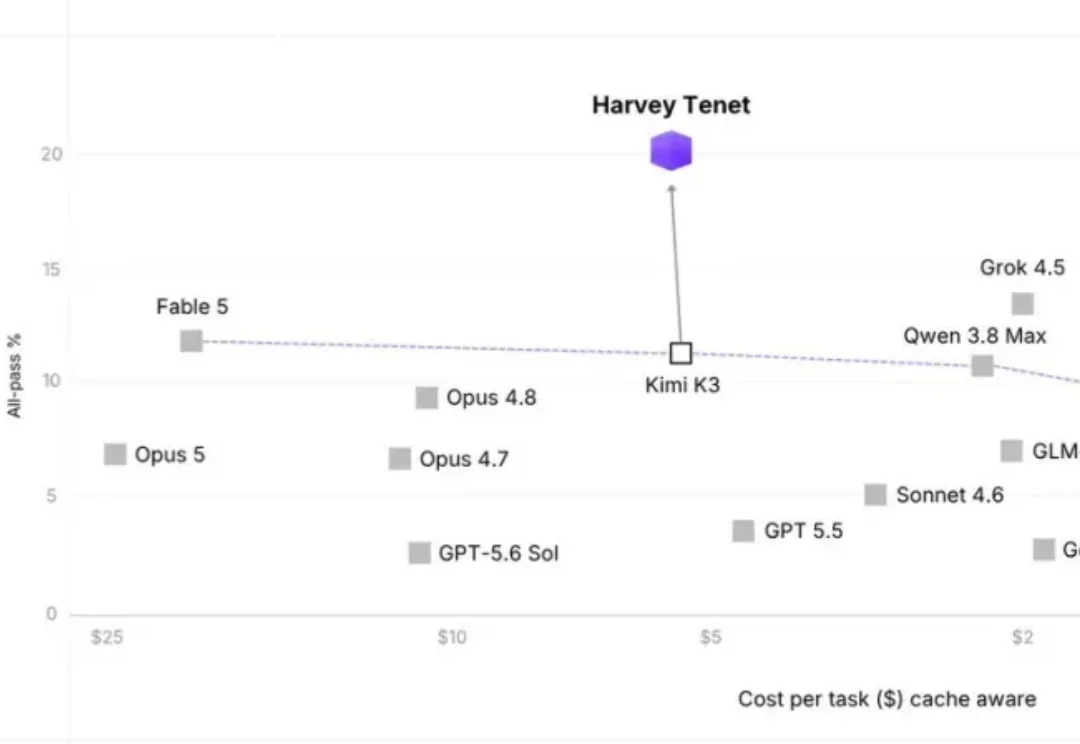
最近,越来越多应用层 AI 企业走上了一条相似的路线:用自己积累的专业知识和业务经验,训练自己的模型。
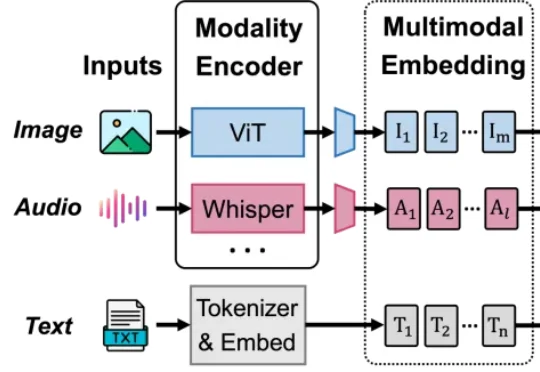
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
如果只看标题,它很容易被归到“又一个万亿参数大模型”的队伍里:1.6 万亿总参数、MoE 架构、100 万 token 上下文、面向代码和 Agent 场景。但这次真正值得看的,不只是模型有多大,而是它背后的三个问题:国产算力能不能支撑前沿级大模型训练?
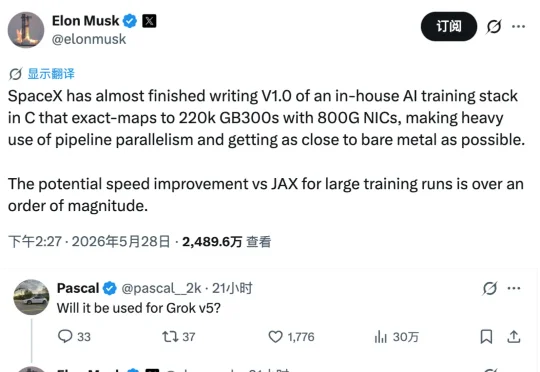
不用JAX,SpaceX正在用C语言编写的全新堆栈训练新模型。而且马斯克本人亲口承认,Grok 5已经用的就是这个新堆栈。按马斯克的说法,这种新堆栈能让大模型训练速度提升一个数量级。
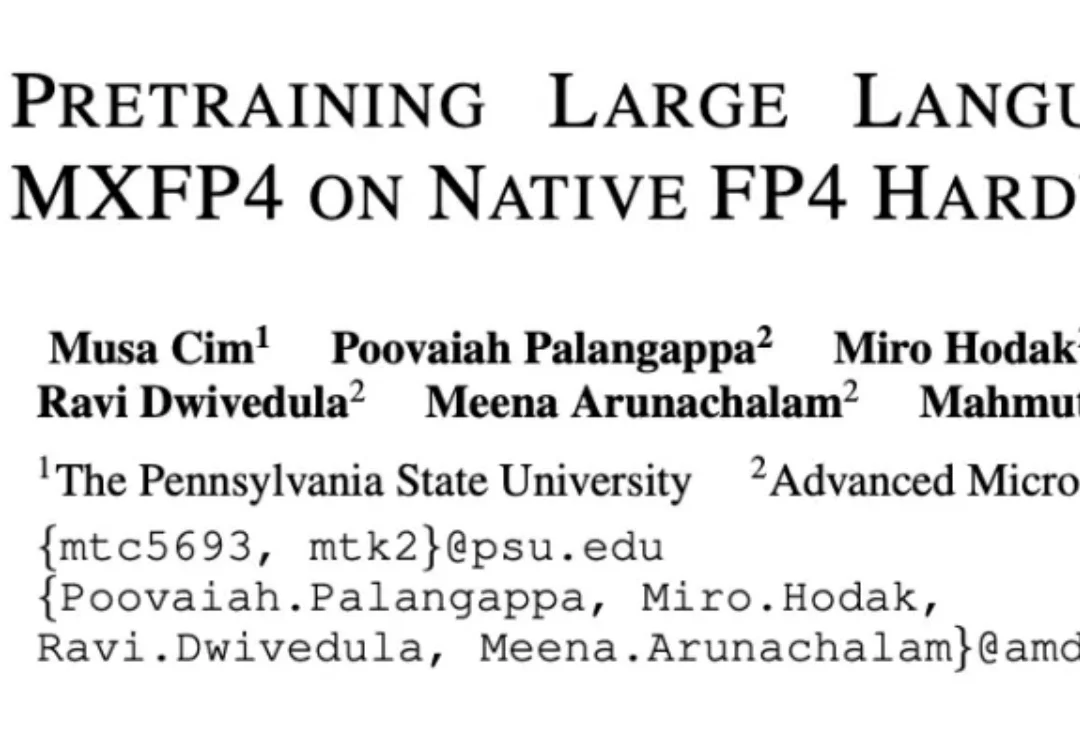
众所周知,大模型训练成本极高。
当大模型训练进入深水区,竞争的关键已经不再只是「模型参数怎么调」,而逐渐转向一个更核心、也更难系统解决的问题:模型在训练过程中究竟看到了什么数据、以什么比例看到、哪些样本应该被更频繁地学习。
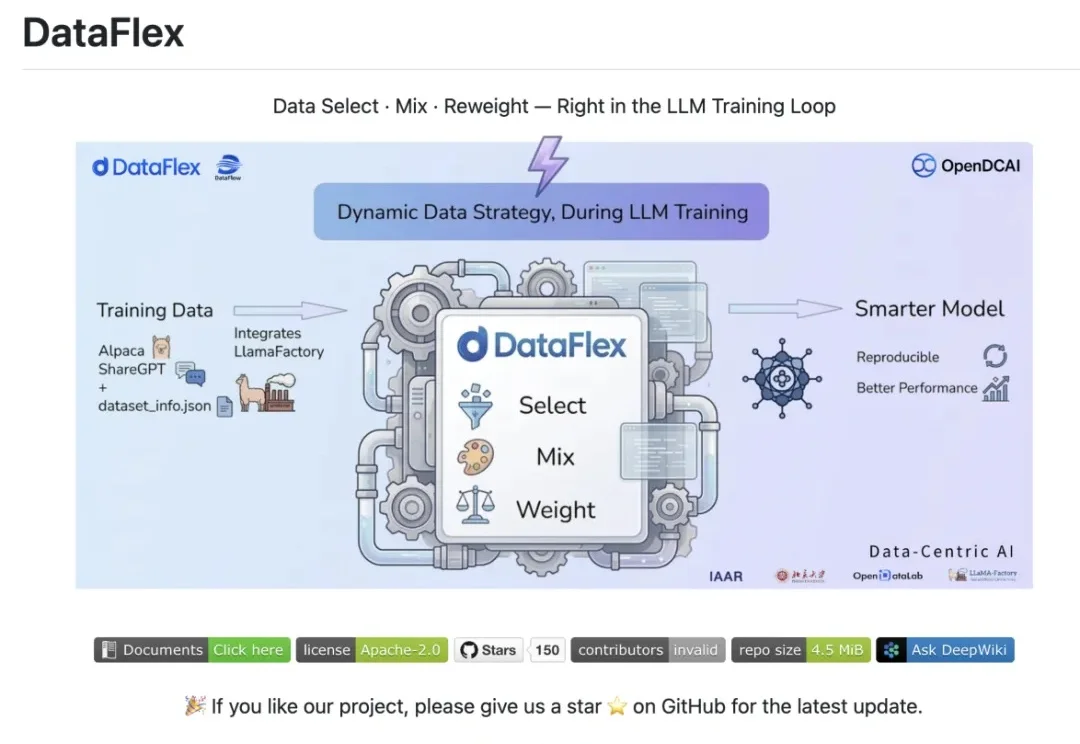
当大模型训练进入深水区,竞争的关键已经不再只是「模型参数怎么调」,而逐渐转向一个更核心、也更难系统解决的问题:模型在训练过程中究竟看到了什么数据、以什么比例看到、哪些样本应该被更频繁地学习。