答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励
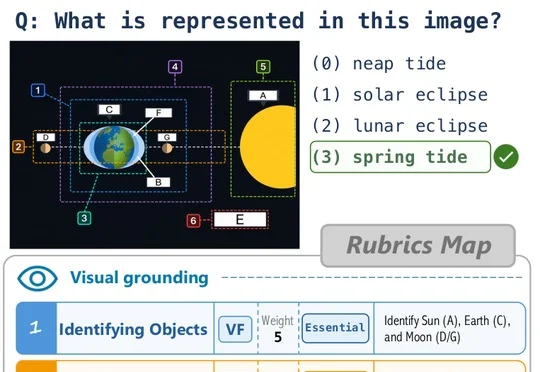
答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
搜索
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
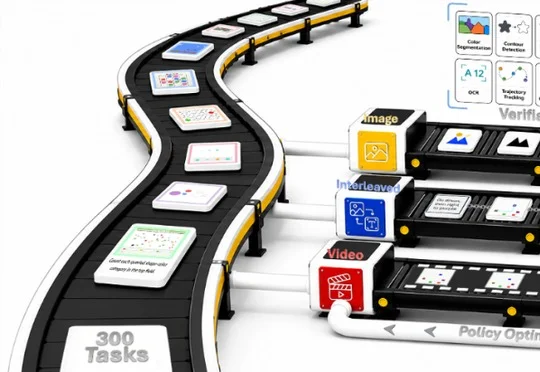
NTU、CMU、Berkeley等高校联合推出VBVR-Pro视觉推理系统,构建300项任务与100项可验证打分器的训练评测平台,测试30余个多模态模型,并验证其打分器可直接作为强化学习奖励。
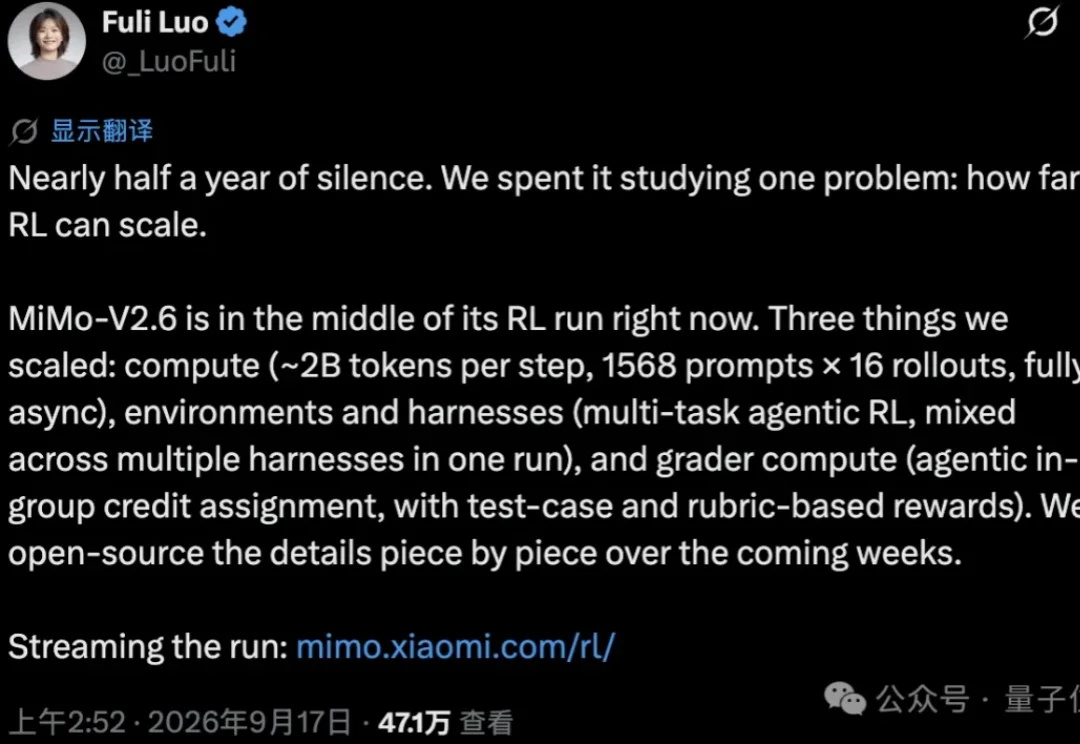
什么情况?小米新模型的强化学习训练,直接开了现场直播。
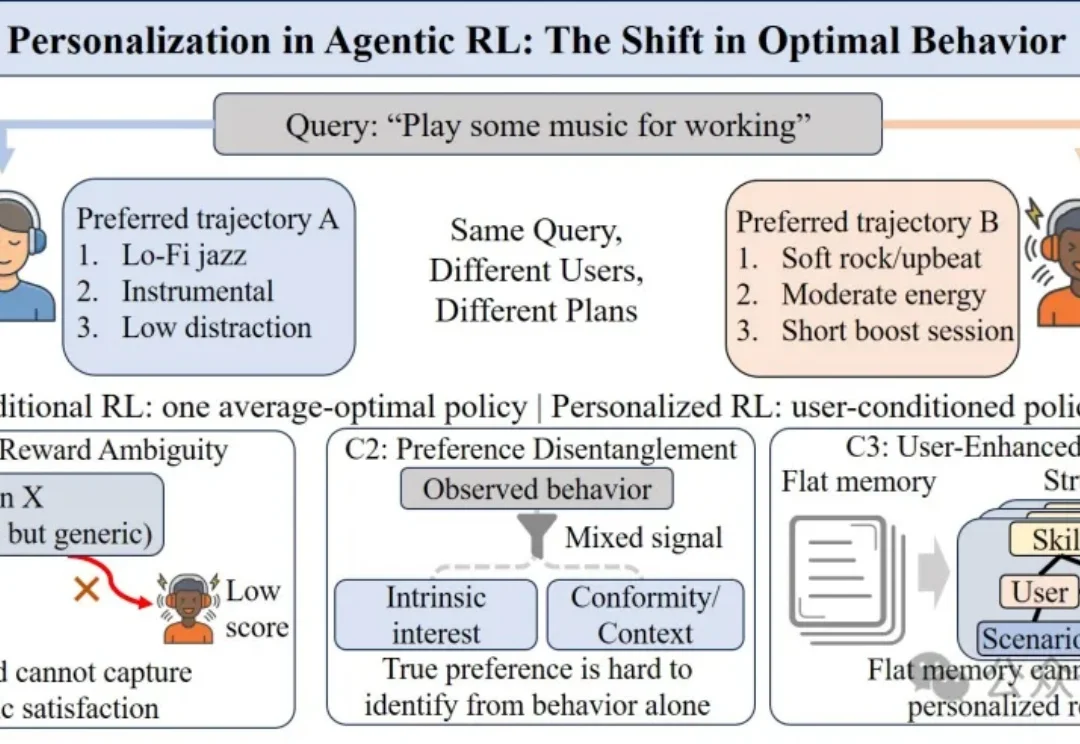
当个性化Agentic RL遇上现实用户平台场景时,一直存在一个常见难点:面对同样的query,不同用户往往偏好不同的规划策略、工具调用和最终表达。
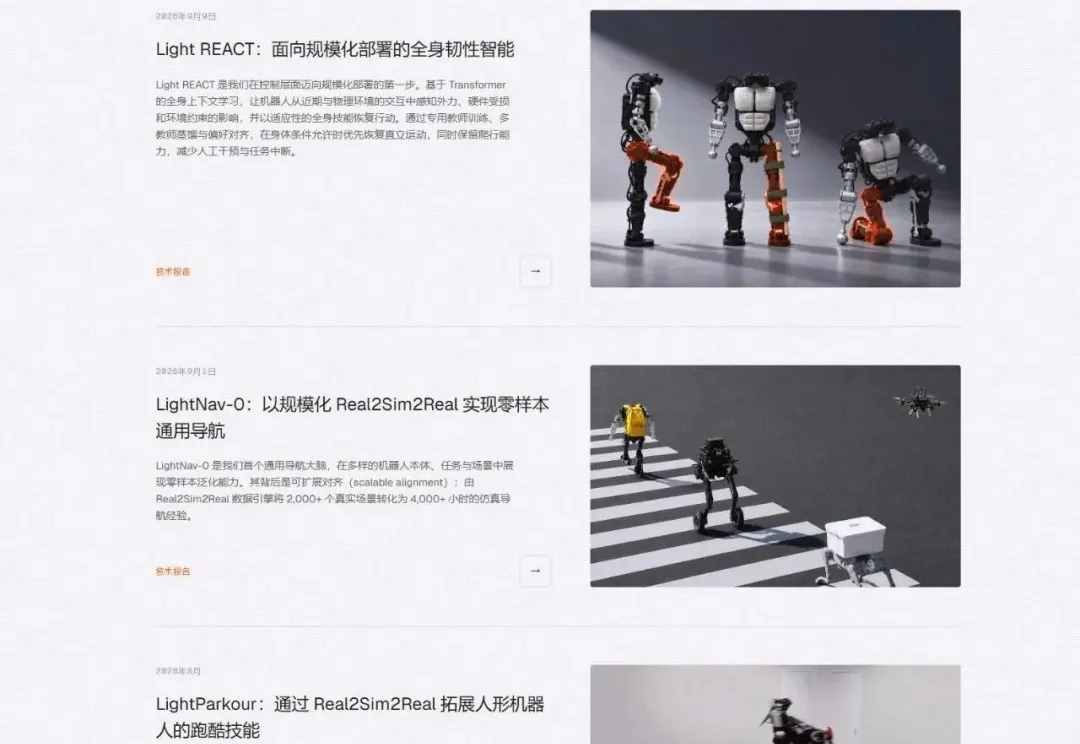
过去一年,具身智能的技术迭代明显加快。VLA、世界模型持续演进,强化学习重新成为机器人学习的重要技术路径,Sim2Real加速从仿真走向真机,全身控制能力也在快速突破。
WalkingLab 是由清华大学与香港大学团队发起的开源非营利实验室,专注真实世界 AI 与项目制学习,成立五个月已推出涵盖工程实践、强化学习和大语言模型的三门核心课程,累计获超 20,000 GitHub Star 并登上 Hacker News 首页,致力于通过真实项目连接课程、论文与工程实践,加速 AGI 到来。
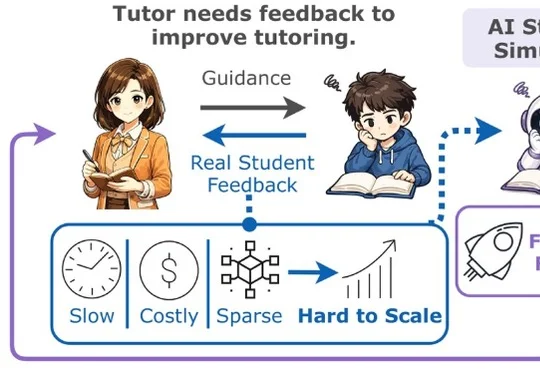
微软与UIUC合作研究StudentSim框架,基于真实学生数据训练个性化学生模拟器,具备behavioral fidelity和guidance responsiveness两项能力,在国际象棋等三个领域验证其优于现有基线,并可作为AI教师强化学习的高通量奖励信号。