AI资讯新闻榜单内容搜索-微调

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 微调
马卡龙的下注:把模型后训练,做成企业服务

马卡龙的下注:把模型后训练,做成企业服务

马卡龙的下注:把模型后训练,做成企业服务

Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。

来自主题: AI资讯
10102 点击    2026-09-24 10:10
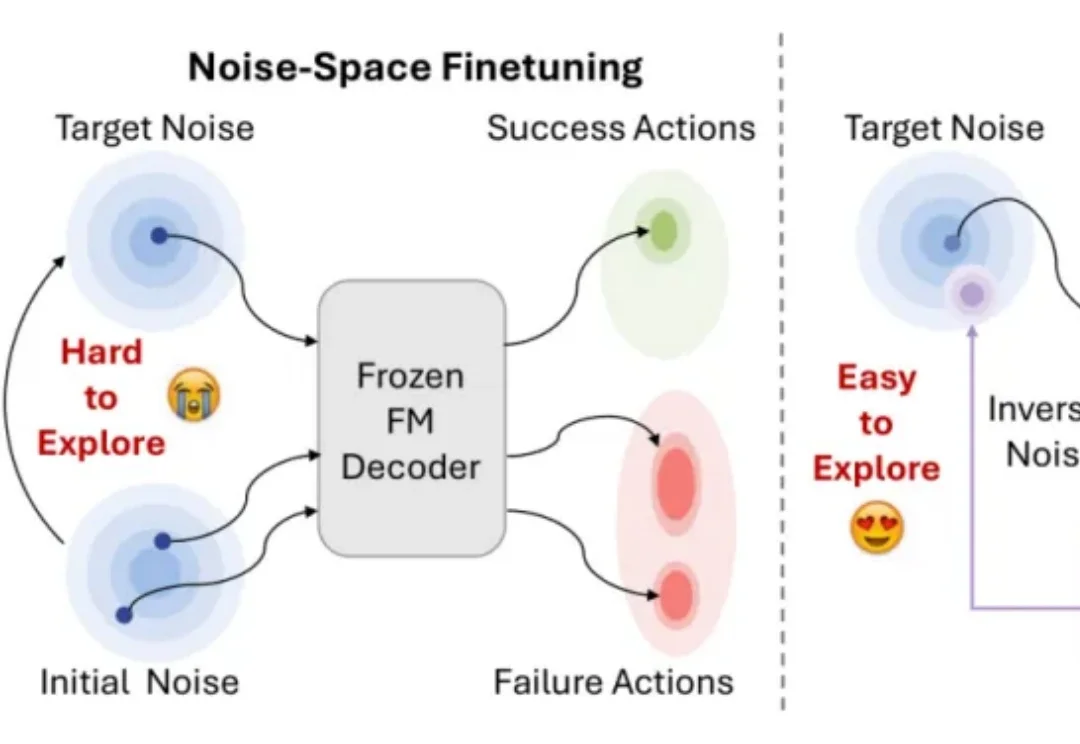
UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习

UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习

UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习

视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。

来自主题: AI技术研报
9745 点击    2026-09-02 14:32
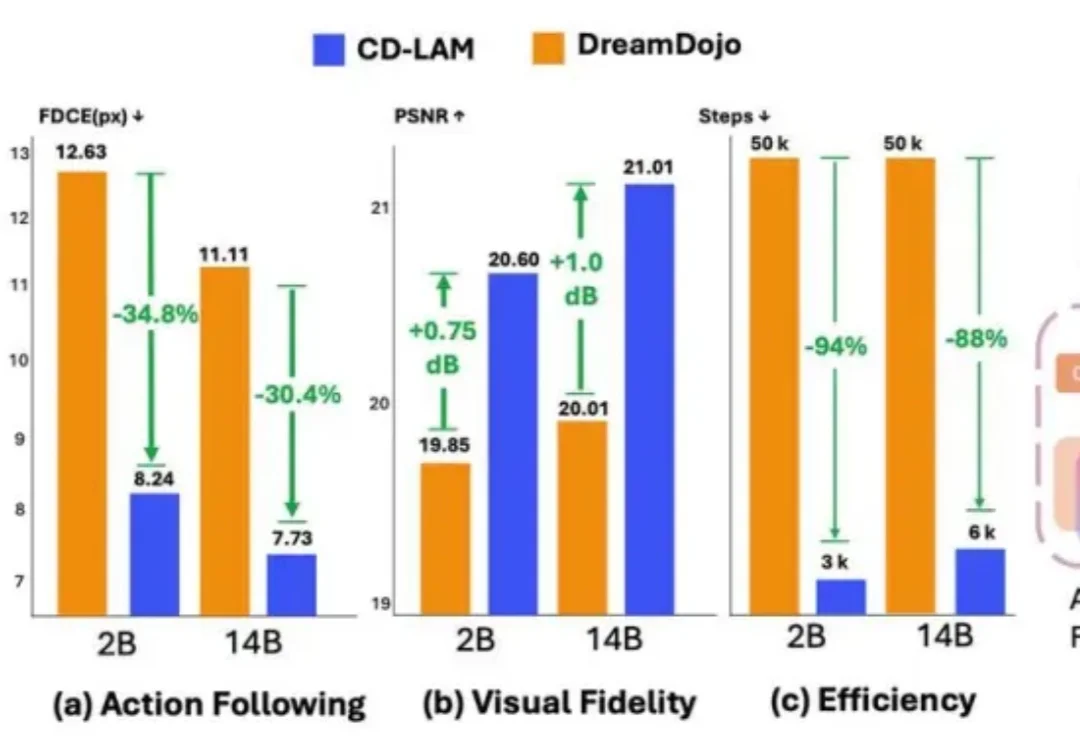
世界模型迎来因果升级:CD-LAM仅用几千步微调即可显著增强动作控制

世界模型迎来因果升级:CD-LAM仅用几千步微调即可显著增强动作控制

世界模型迎来因果升级:CD-LAM仅用几千步微调即可显著增强动作控制

人类可以轻松想象一个还没做出的动作会带来什么:手一松,杯子会掉;往前一推,抽屉会合上。动作尚未发生,大脑已经预演了可能的结果。对机器人来说,具身世界模型(Embodied World Model)会根据当前观察和未来的动作,预测动作执行后的未来画面。

来自主题: AI技术研报
6720 点击    2026-07-28 10:33
复旦女学霸建token工厂,Fireworks AI完成100亿D轮融资

复旦女学霸建token工厂,Fireworks AI完成100亿D轮融资

复旦女学霸建token工厂,Fireworks AI完成100亿D轮融资

这家公司是Fireworks AI,按现在流行的话说,Fireworks AI是一家Token工厂。既不训练前沿大模型,也不做面向消费者的AI应用,只做推理,帮企业把开源模型微调好、托管好,然后按调用量收钱。今年GTC大会上,黄仁勋和Lin Qiao有场对谈,老黄直言,“In a lot of ways, you're the TSMC of AI factories.”

来自主题: AI资讯
10486 点击    2026-07-22 16:36
只用15%数据,多模态指令微调反超全量训练15.8%!

只用15%数据,多模态指令微调反超全量训练15.8%!

只用15%数据,多模态指令微调反超全量训练15.8%!

来自上海交大、马来亚大学、CMU、MBZUAI、KIT和KAUST的团队提出VisNec(Visual Necessity Score,视觉必要性分数),用一个分数衡量每条训练样本里“图像到底起了多大作用”,被ECCV 2026收录。

来自主题: AI技术研报
8815 点击    2026-07-04 10:47
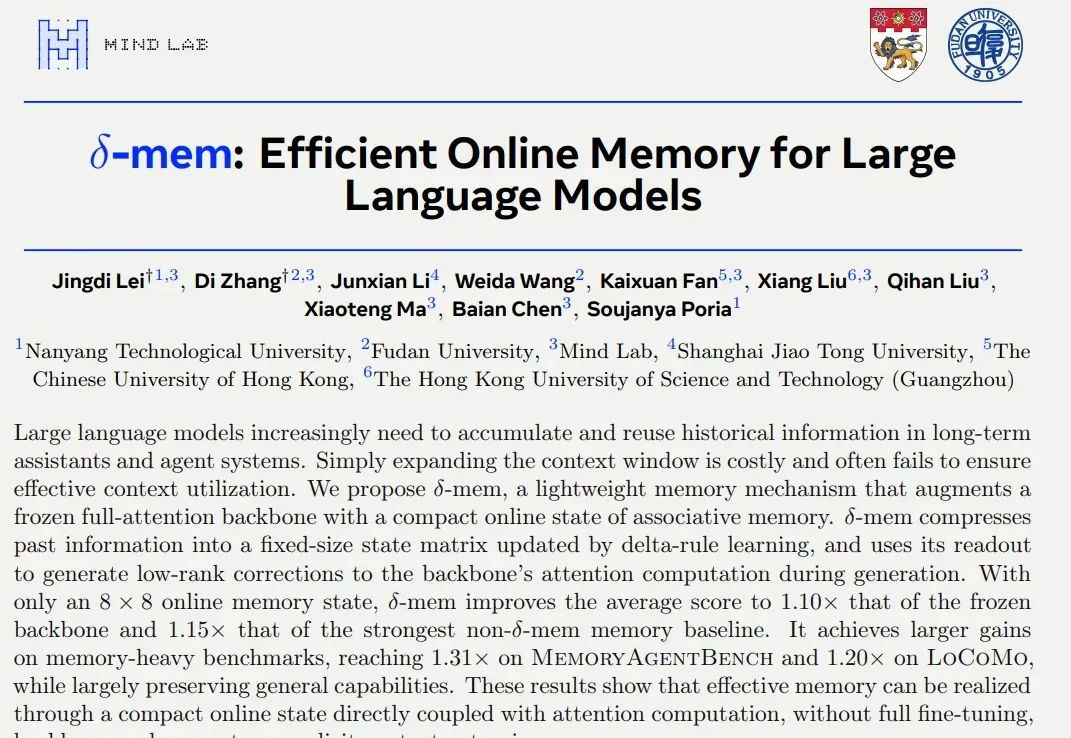
一个8×8矩阵,让大模型「记住」长对话:Mind Lab联合NTU、复旦推出δ-mem,参数仅0.12%

一个8×8矩阵,让大模型「记住」长对话:Mind Lab联合NTU、复旦推出δ-mem,参数仅0.12%

一个8×8矩阵,让大模型「记住」长对话:Mind Lab联合NTU、复旦推出δ-mem,参数仅0.12%

不扩上下文窗口、不换骨干架构、不做全参数微调 —— 只需要一个 8×8 的在线状态矩阵,就能让冻结的 Transformer 拥有真正的长期记忆。

来自主题: AI技术研报
15407 点击    2026-06-08 14:50
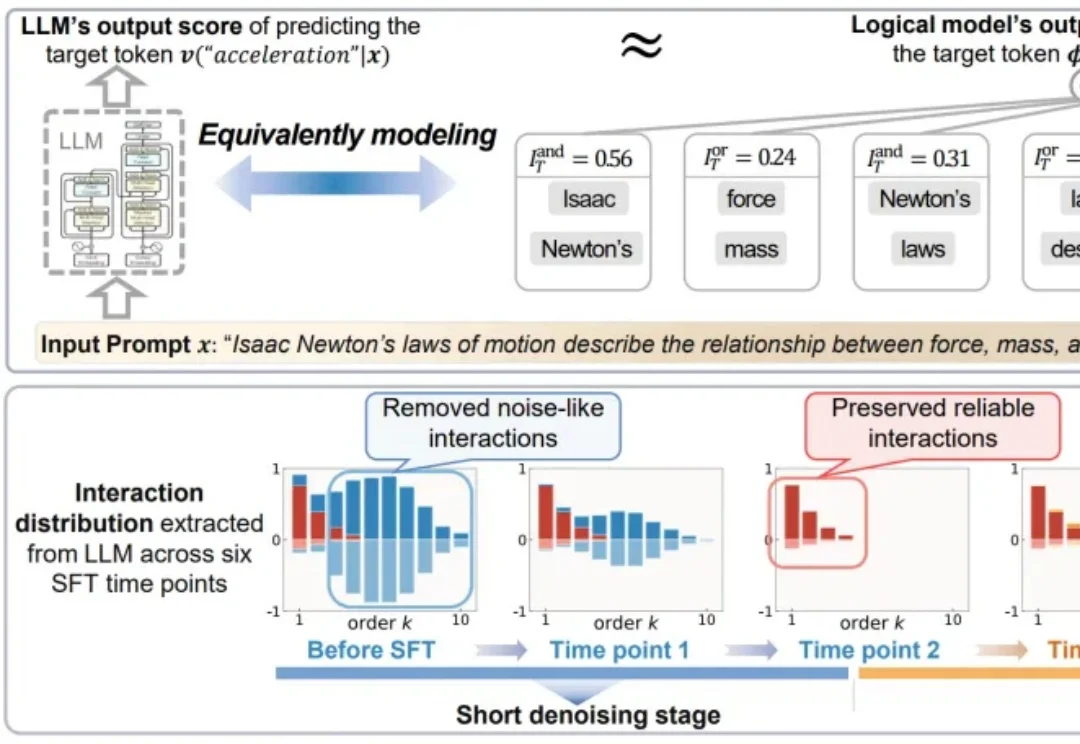
吃透大模型SFT底层机理:终结实践争议,规避无效算力

吃透大模型SFT底层机理:终结实践争议,规避无效算力

吃透大模型SFT底层机理:终结实践争议,规避无效算力

长期以来,监督微调(Supervised Fine-Tuning,SFT)一直是深度神经网络中最常用的模型适配手段。在中小规模的传统神经网络中,SFT 通常能够稳定提升下游任务表现。

来自主题: AI技术研报
7551 点击    2026-06-04 08:38
Mind Lab连续发布LoRA最新进展,大模型「持续学习」新范式浮现

Mind Lab连续发布LoRA最新进展,大模型「持续学习」新范式浮现

Mind Lab连续发布LoRA最新进展,大模型「持续学习」新范式浮现

最近,前沿实验室 Mind Lab 密集发布了一系列关于 LoRA 与 PEFT(高效微调)的研究结果,似乎描绘出了另一条大模型「持续学习」的路径。在 Mind Lab 的视角中,PEFT 不再是对大模型全参数后训练的一种廉价平替,更是实现从 “基础模型” 向 “可持续学习智能体” 过渡的核心架构机制。

来自主题: AI技术研报
13599 点击    2026-06-02 12:25