印度自研模型社死!照搬千问,仅塞提示词硬充印度造
印度自研模型社死!照搬千问,仅塞提示词硬充印度造印度AI机构169Pi宣称自研Alpie Seed 9B,但Hugging Face配置显示其基于阿里Qwen3.5-9B量化微调,仅通过提示词强塞印度身份,且引用跑分未在相同环境复测。
来自主题: AI资讯
10590 点击 2026-11-09 18:47

 搜索
印度AI机构169Pi宣称自研Alpie Seed 9B,但Hugging Face配置显示其基于阿里Qwen3.5-9B量化微调,仅通过提示词强塞印度身份,且引用跑分未在相同环境复测。
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
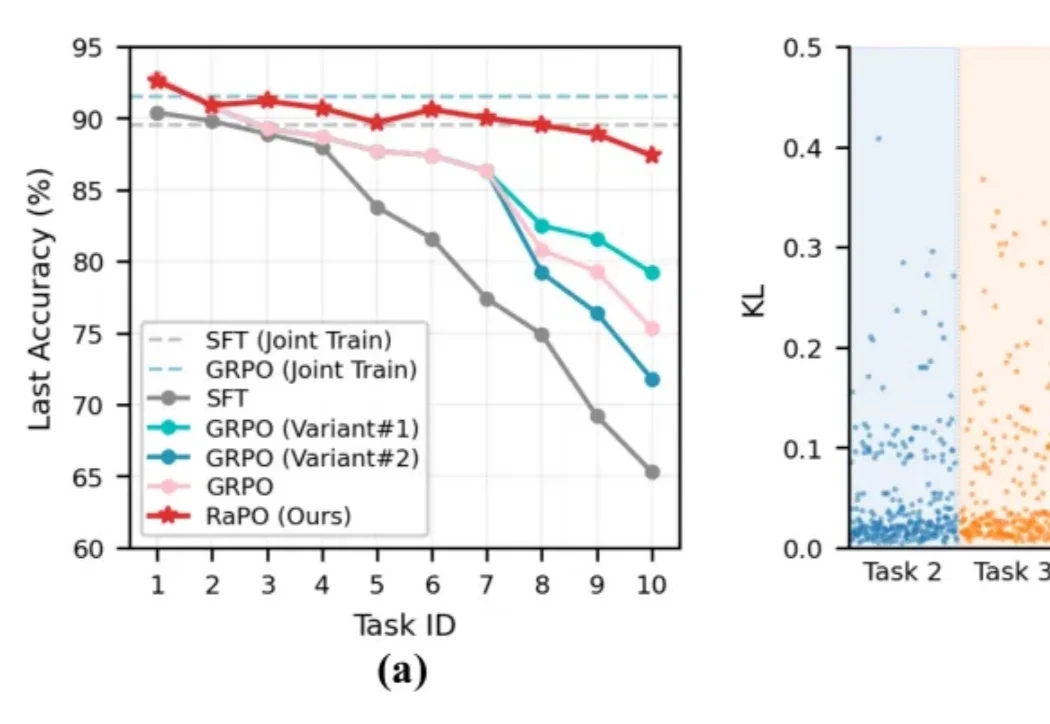
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
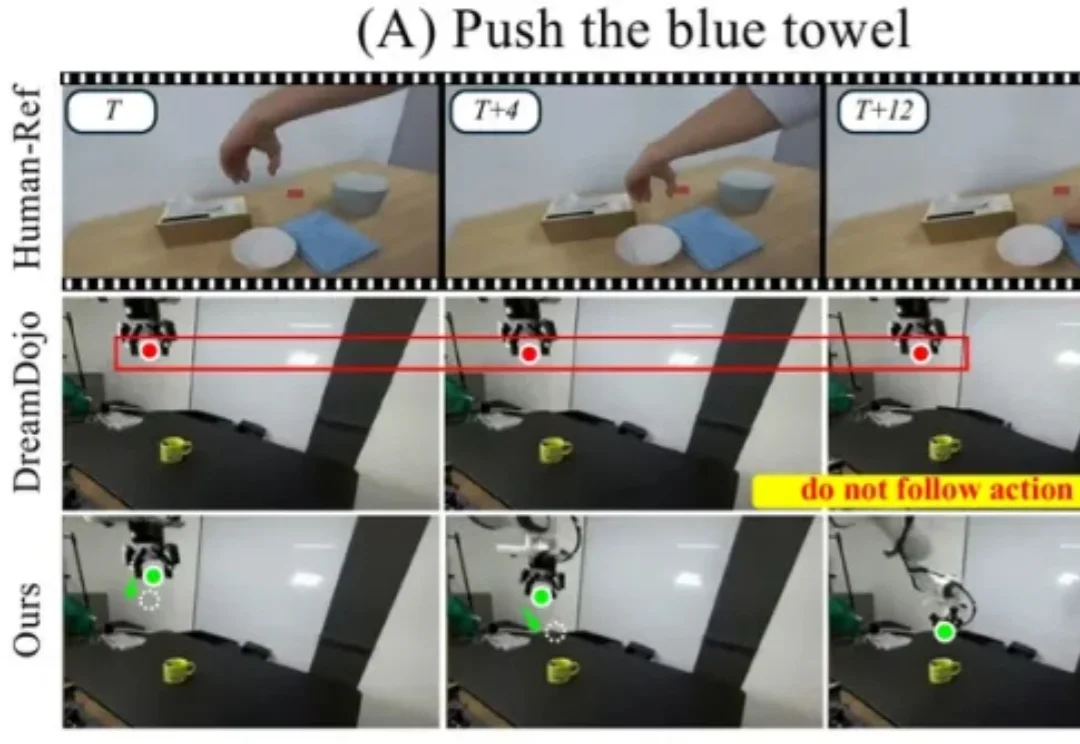
基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。
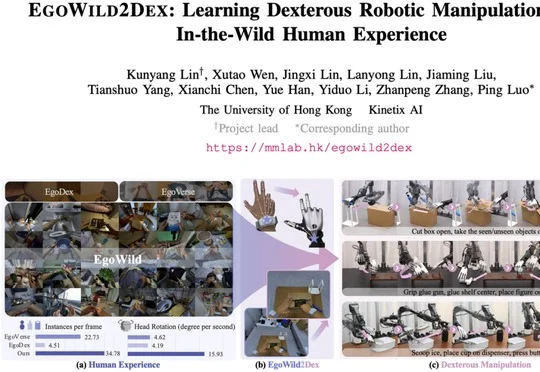
香港大学MMLab团队提出EgoWild2Dex,利用538.9小时真实人类第一视角数据训练机器人,每个下游任务使用不到1小时真机数据微调,拆快递、用热熔胶枪固定摆件和制作冰饮等任务的平均成功率达96.7%。
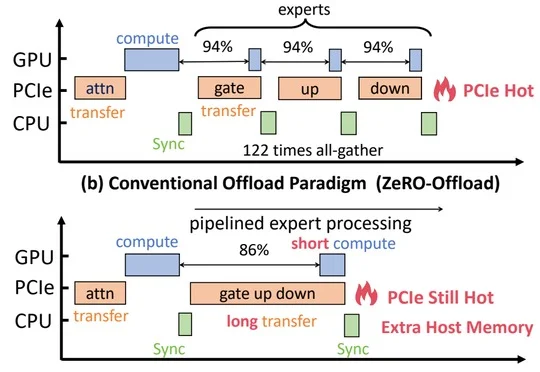
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
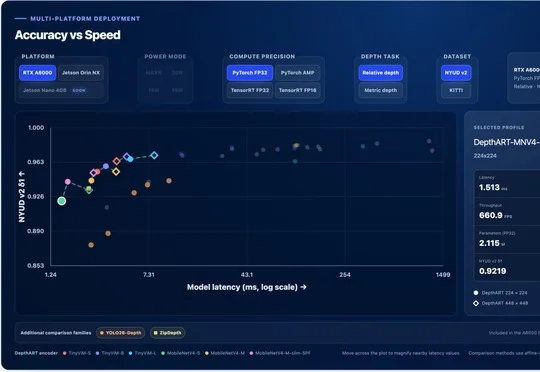
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
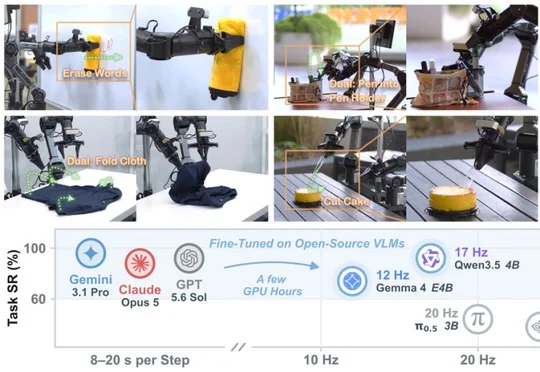
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
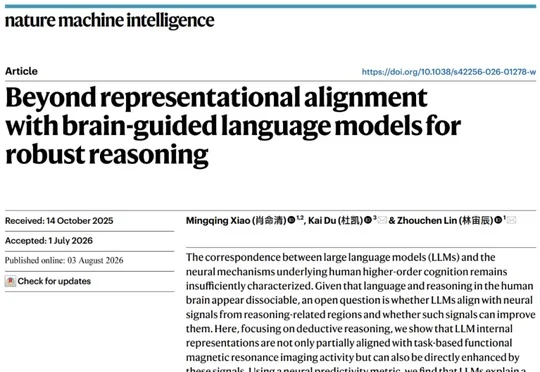
北京大学、清华大学与微软亚洲研究院在Nature Machine Intelligence发表研究,发现语言模型内部表征与人脑演绎推理脑区存在部分对齐,并可利用脑信号引导模型表征干预与参数微调,显著提升推理鲁棒性。