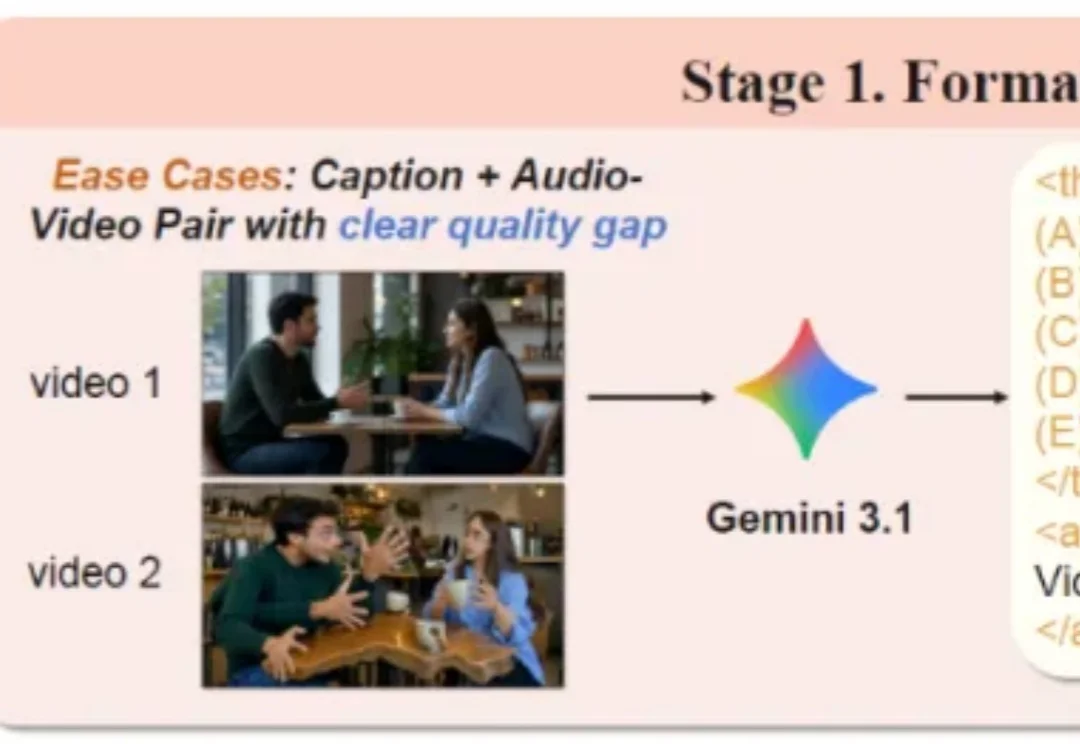
复旦上线音视频模型新裁判:一万组数据对齐人类审美
复旦上线音视频模型新裁判:一万组数据对齐人类审美现有的音视频奖励模型,能通过局部指标捕捉到画质或同步上的优势,却往往忽略声音失真、台词与提示不符,以及动作和语音配合不自然等问题。
来自主题: AI技术研报
9100 点击 2026-09-21 15:30

 搜索
现有的音视频奖励模型,能通过局部指标捕捉到画质或同步上的优势,却往往忽略声音失真、台词与提示不符,以及动作和语音配合不自然等问题。
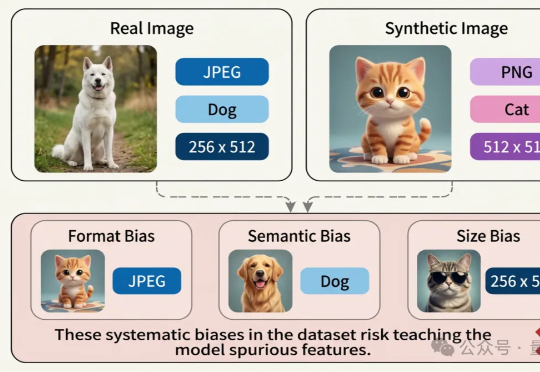
近日,腾讯优图实验室联合华东理工大学、北京大学等研究团队在A生成图像检测(AI-Generated Image Detection)泛化问题上展开研究,提出Dual Data Alignment(双重数据对齐,DDA)方法,从数据层面系统性抑制“偏差特征”,显著提升检测器在跨模型、跨数据域场景下的泛化能力。
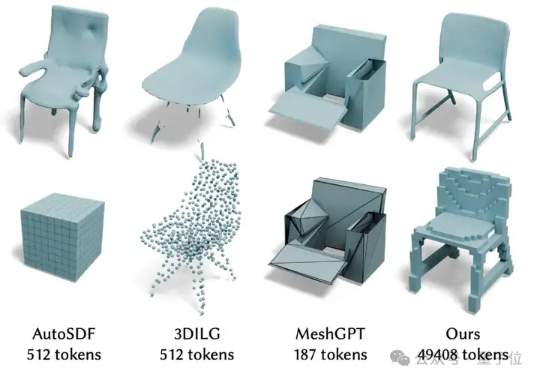
最近,北京大学陈宝权教授带领团队在三维形状生成和三维数据对齐方面取得新的突破。在三维数据生成方面,团队提出了3D自回归模型新范式,有望打破3D扩散模型在三维生成方面的垄断地位。
华盛顿大学和Allen AI最近发表的论文提出了一种新颖有趣的数据合成方法。他们发现,充分利用LLM的自回归特性,可以引导模型自动生成高质量的指令微调数据。