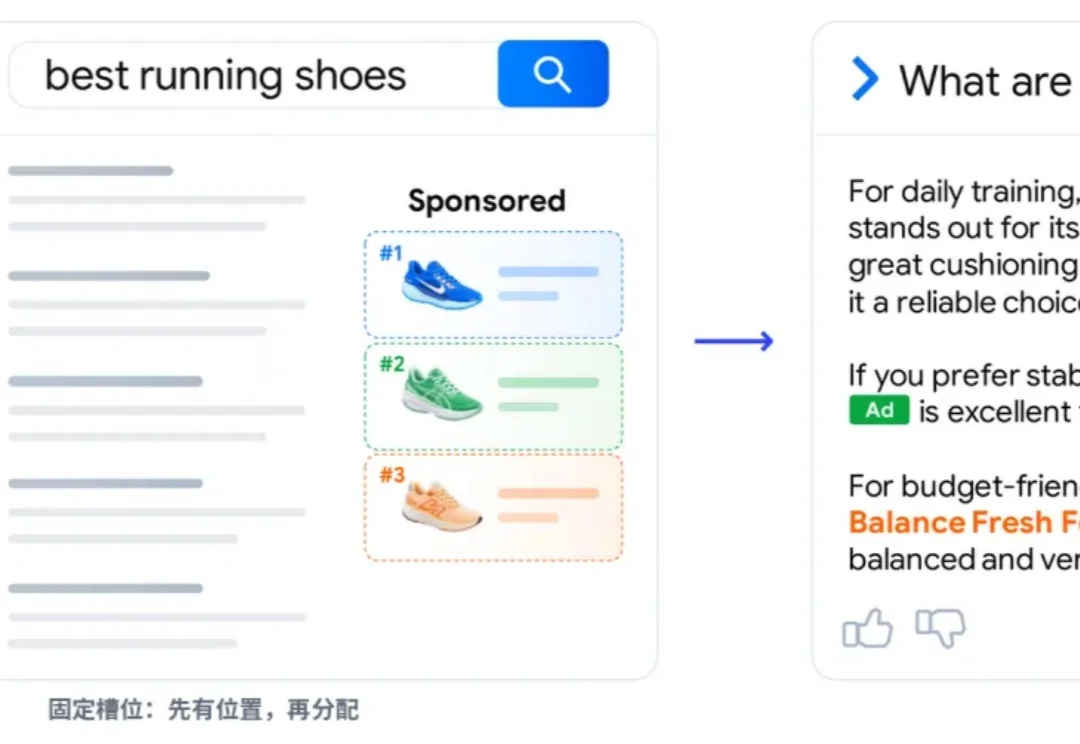
大模型正在吃掉搜索广告位,下一代广告该怎么做?人大高瓴、斯坦福把拍卖写进Token生成过程
大模型正在吃掉搜索广告位,下一代广告该怎么做?人大高瓴、斯坦福把拍卖写进Token生成过程搜索结果里但凡出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。Pew Research Center 对美国用户在 Google 上大规模浏览行为的分析发现:有 AI 摘要时,用户点击传统搜索结果的比例从 15%直接暴跌至 8%。
搜索
搜索结果里但凡出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。Pew Research Center 对美国用户在 Google 上大规模浏览行为的分析发现:有 AI 摘要时,用户点击传统搜索结果的比例从 15%直接暴跌至 8%。
近期,香港科技大学联合M-A-P、NOIZ AI、斯坦福等机构发布并开源了一个统一符号与音频音乐生成的模型YuE2,将开源音乐生成的质量推向与前沿闭源模型正面竞争的位置。
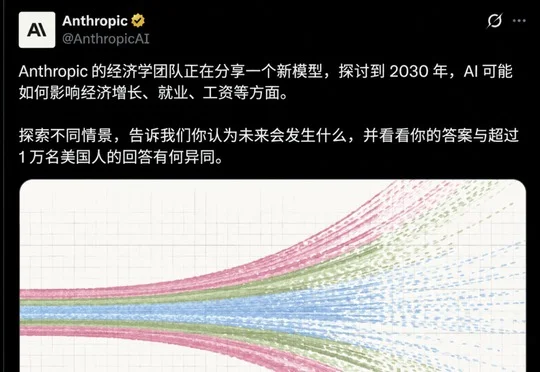
Anthropic联合MIT、斯坦福学者发布2030年三种经济情景推演,极端情景下美国GDP暴增32%但白领失业率飙至17.9%,资本攫取55%增长红利,万余名美国人调查预期偏向最严峻版本。
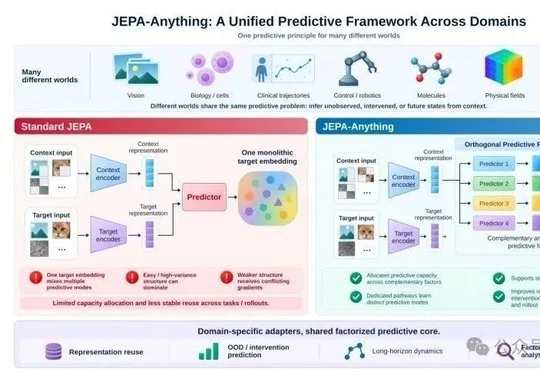
PhAI Labs联合牛津、斯坦福等高校推出跨领域预测框架JEPA-Anything,通过正交预测分解(OPF)机制将预测容量分配到多个互补子空间,并在视觉、生物、临床、控制、分子、物理场和天气七类系统中验证,同时在肝癌研究中从内部因子筛选出可实验验证的候选干预方案,在行星轨道模拟中提取出与开普勒第三定律高度吻合的尺度规律。
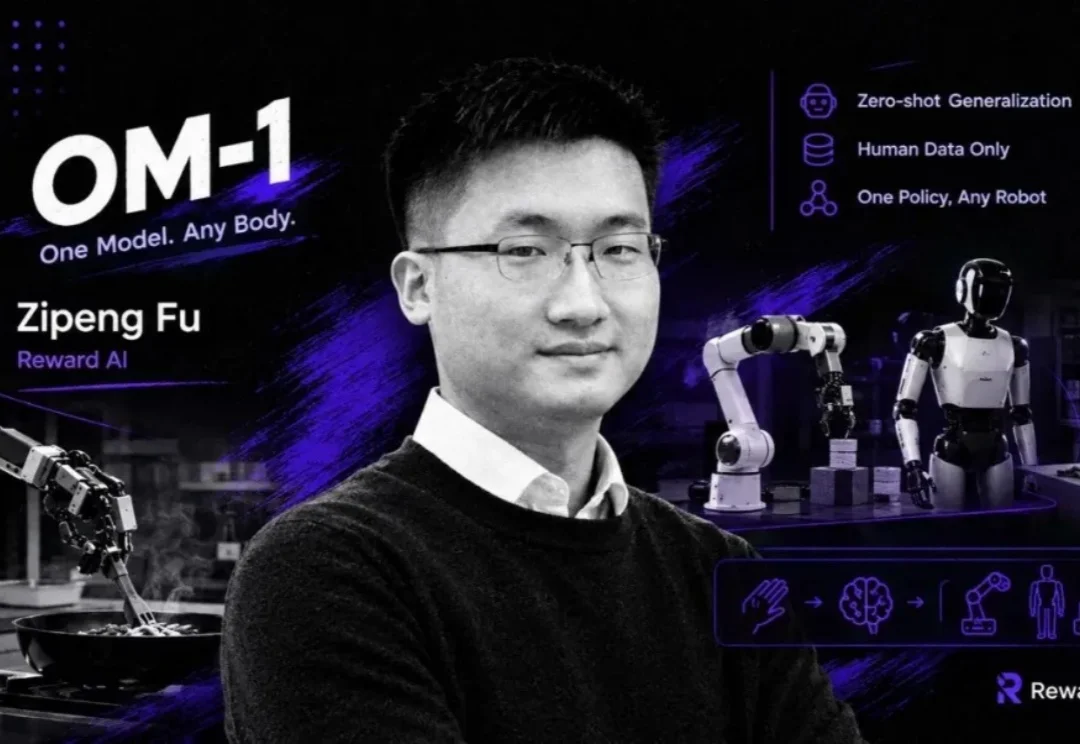
近期,由斯坦福大学计算机科学博士符梓鹏(Zipeng Fu)联合创立的新团队Reward AI,正式发布通用机器人策略OM-1(Omnibody Model 1),并公布了完整的Omnibody技术栈。
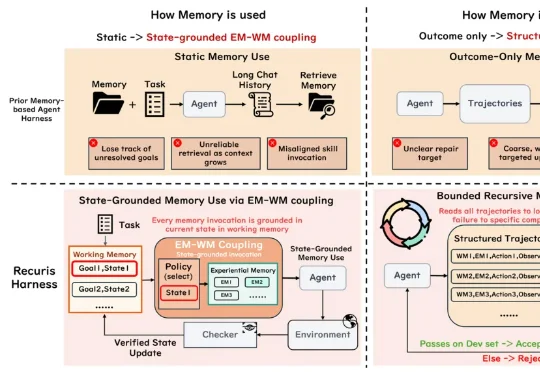
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
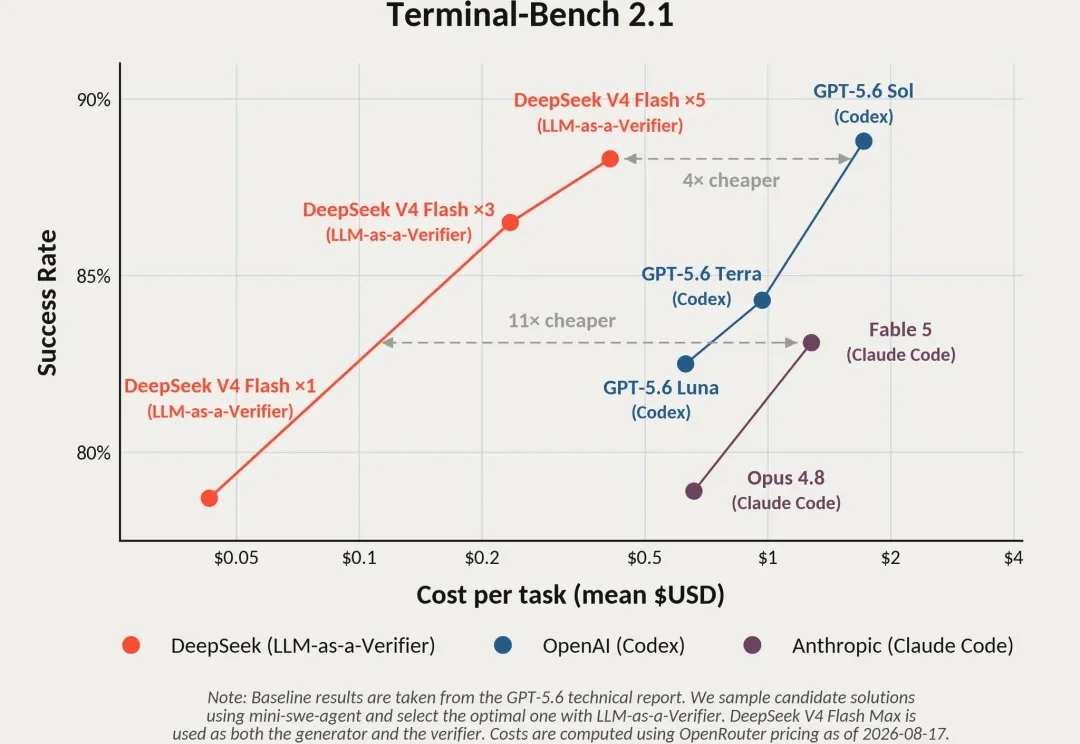
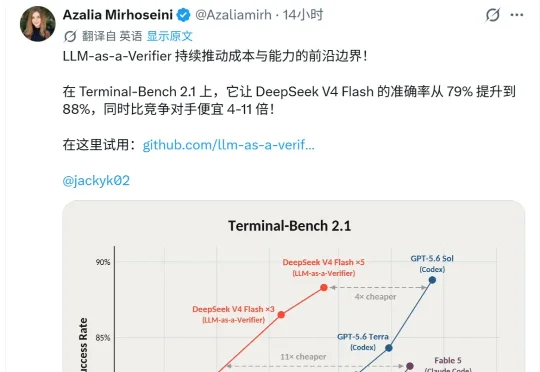
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
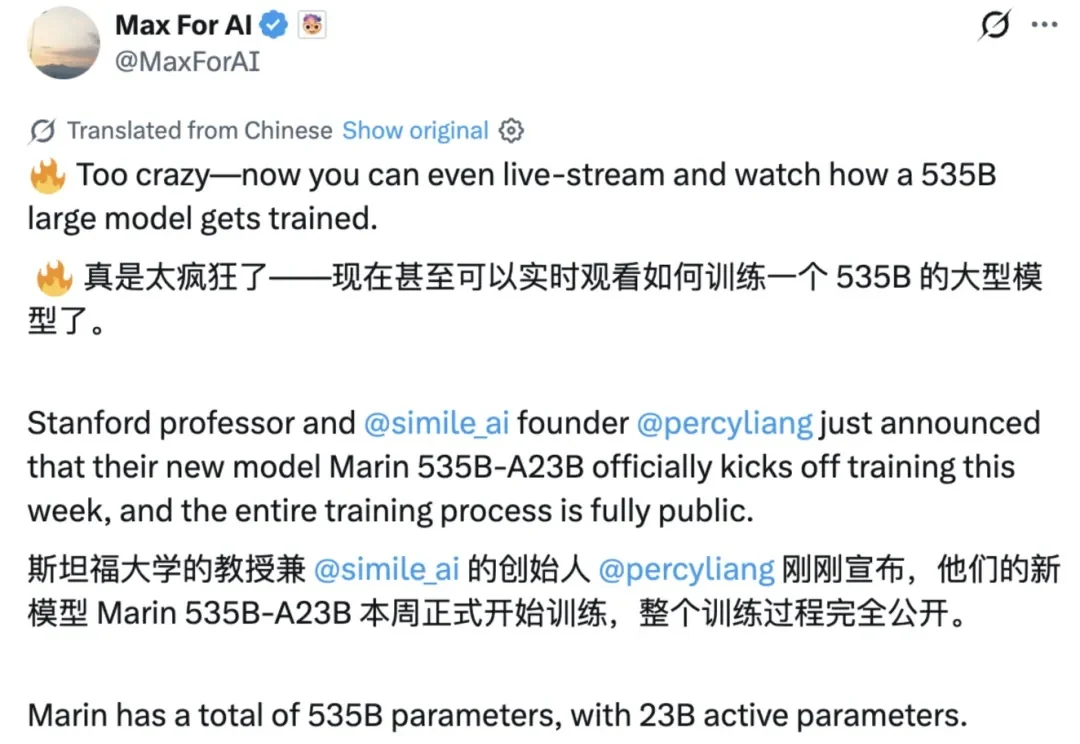
最近两天,X 上网友 Max For AI@MaxForAI 的一篇帖子引发了网友热议:「太疯狂了 —— 现在你甚至可以直播围观一个 535B 大模型是如何被训练出来的。」
同样的模型,同样的任务,让它执行五遍,再让他自己挑一遍最稳的,效果能有多大提升?斯坦福把这套玩法用在了AI身上,DeepSeek V4 Flash在Terminal-Bench 2.1的成绩从79%一路涨到88%,反超了尖子生Fable 5。而且连做五遍加挑选这一通折腾,价格依然比Fable 5便宜了4-11倍。
SparkChat,就盯上了这类朋友之间很日常的社交问题,由Digipals推出,核心创始人Peggy Wang是斯坦福CS本硕,做过Lyft Level 5和Meta Reality Labs,第一次创业的Ego便进入了YC W24,并累计融资750万美元。