阿莫迪偷师姚顺雨,奥特曼偷师梁文锋
阿莫迪偷师姚顺雨,奥特曼偷师梁文锋Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。
来自主题: AI资讯
8684 点击 2026-09-26 14:58

 搜索
Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。
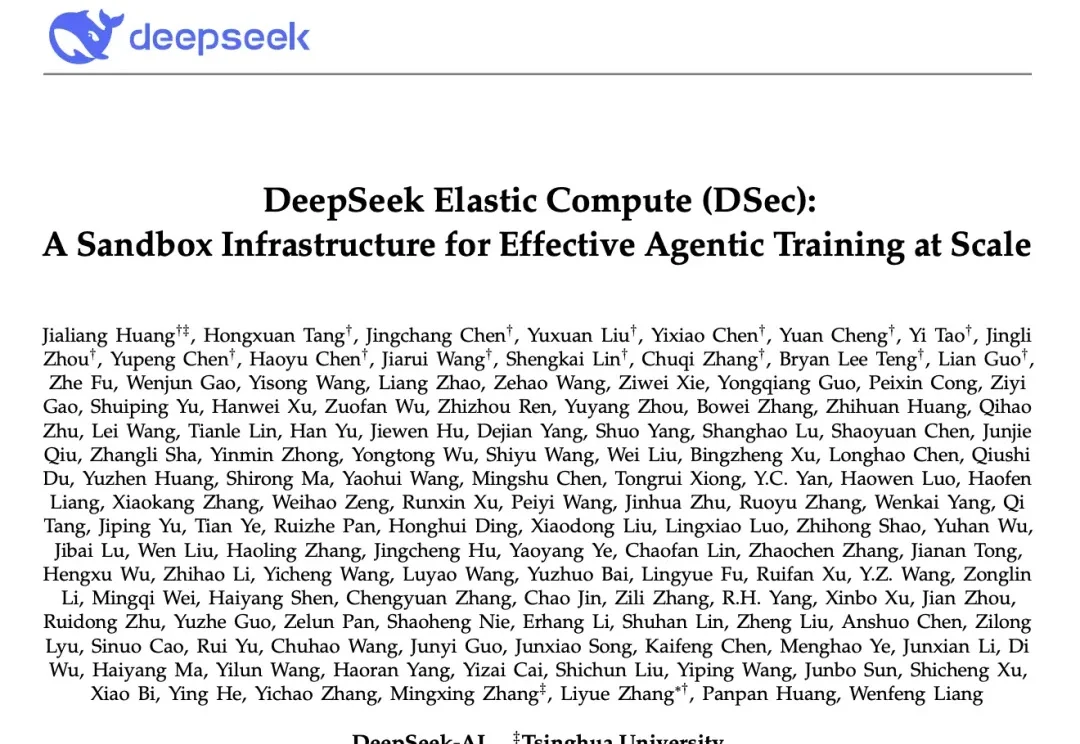
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
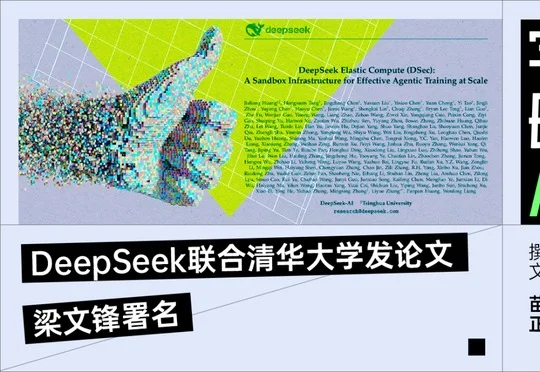
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。
大模型训练拼的是算力,Agent训练拼的是环境。
DeepSeek正训练约2万亿参数的新模型,并计划将后续模型参数规模进一步推至8万亿,加入新一轮超大参数模型竞赛。

DeepSeek-v4-pro-0813 正式上线,两极分化的口碑却让人摸不着头脑。一边,是疯狂刷屏的评测夯爆了:多项 Agent 测试逼近 Fable 5,被认为是又一次前沿模型的“核弹级”更新;另一边,却是不少深夜忠实开发者直摇头:吐槽涨价、模型能力不及预期,实测体感甚至不如之前的小模型……
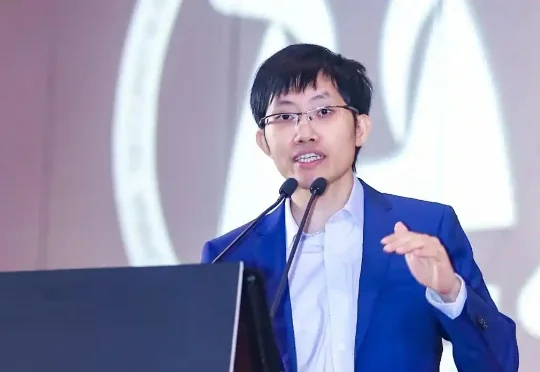
近日,有关DeepSeek创始人梁文锋此前一次长达4小时的投资人会议内容在业内流传。不过,据报道,这场本应在小范围封闭场合进行的内部交流,因会议纪要在未经授权的情况下外泄,引起了梁文锋的不满。
梁文锋那次三个多小时的交流会,我读了两遍。
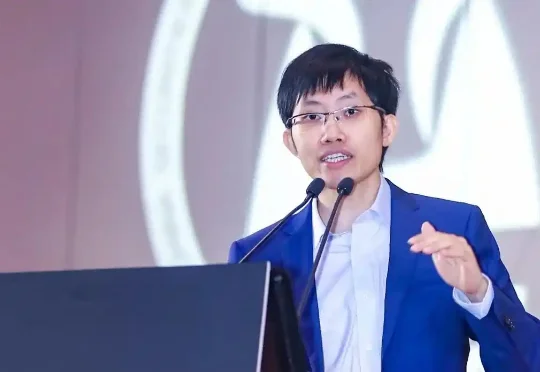
在此之前,梁文锋曾提出“不融资、不上市、不商业化”的原则。此次大规模融资标志着DeepSeek正式走向资本市场,也引发了业界对其商业化路径与技术愿景的广泛关注。在近期的一场投资者交流会上,梁文锋详细阐述了DeepSeek的组织文化、开源逻辑、技术路线图以及对行业竞争格局的看法。
《科创板日报》记者从多家投资机构获悉,DeepSeek首轮融资目前或已敲定,其募资总额超500亿元人民币(约合74亿美元),投后估值突破500亿美元(约合3380亿元人民币)。这是中国AI行业迄今规模最大的单轮融资。