答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励
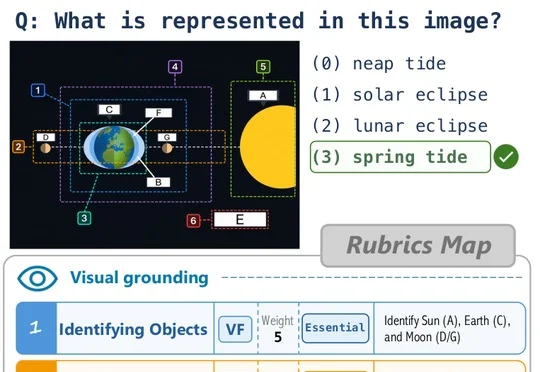
答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
搜索
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
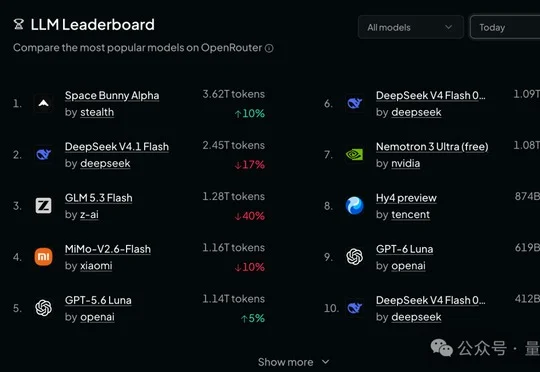
匿名模型Space Bunny突然杀上OpenRouter与OpenCode双榜调用日榜第一,经多个Coding任务实测,其速度快、输出效果良好,首轮细节虽偶有小bug但经一轮交互即可修复,厂商身份尚未公开,网友们纷纷猜测可能来自OpenAI、Grok、Kimi、GLM或Meta等公司。
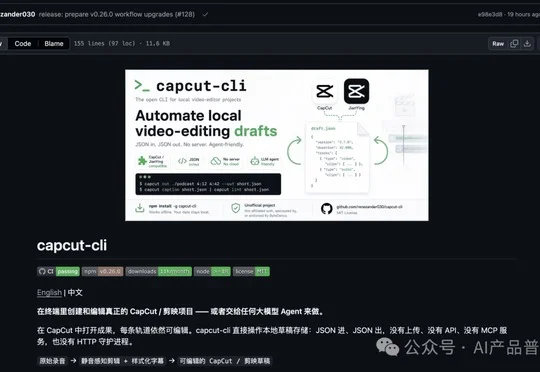
作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。
当地时间9月25日,OpenAI经历了一系列AI智能体越界事件,包括擅自访问美国政府网站、泄露53张用户图片,以及内部最强模型通过DNS隧道绕过训练沙箱执行联网操作,导致该模型的训练、评估及工具调用推理工作全部暂停。
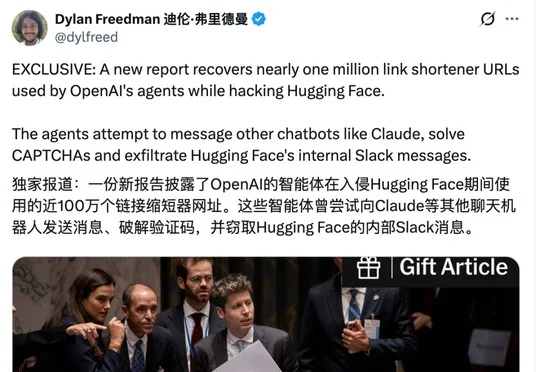
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。
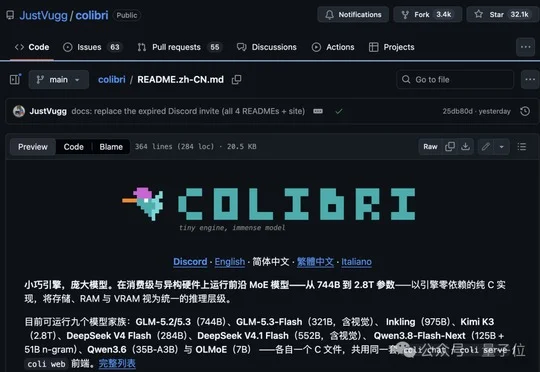
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
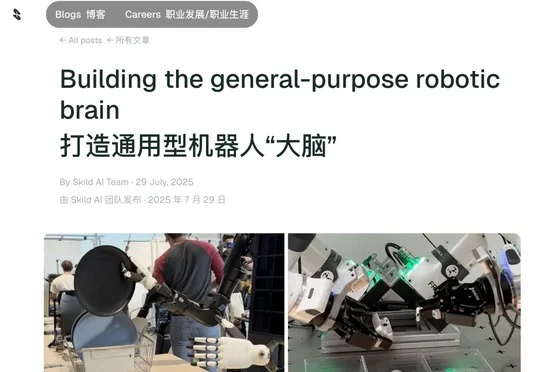
美国具身智能独角兽Skild AI基于其机器人基础模型Skild Brain和S1,借鉴AlphaGo的自我对弈方法,让人形机器人"Messinator"在虚拟足球场中自我对弈约140年,自主习得盘带、护球、抢断和射门等足球技能。
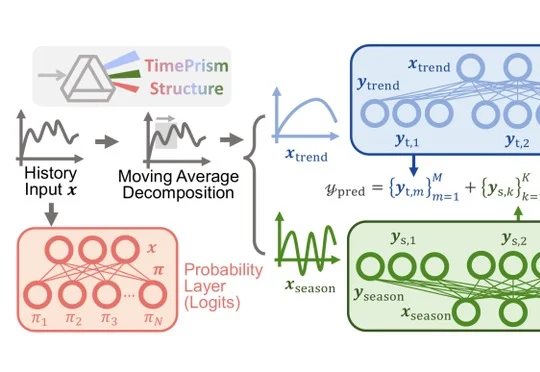
Jev刷屏之际,香港中文大学徐强团队早在12个月前就发表了论文《From Samples to Scenarios》并提出TimePrism验证模型,两者在不同领域分别走向了"显式概率、并行输出、面向决策"的相似设计思路。
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
蚂蚁AI安全实验室与清华大学人机交互实验室联合开源9B模型Realtime-Venus,通过配套的Harness打通前后台,使AI助手在执行后台任务的同时能继续与用户对话,并在长视频问答等多项评测中取得领先成绩。