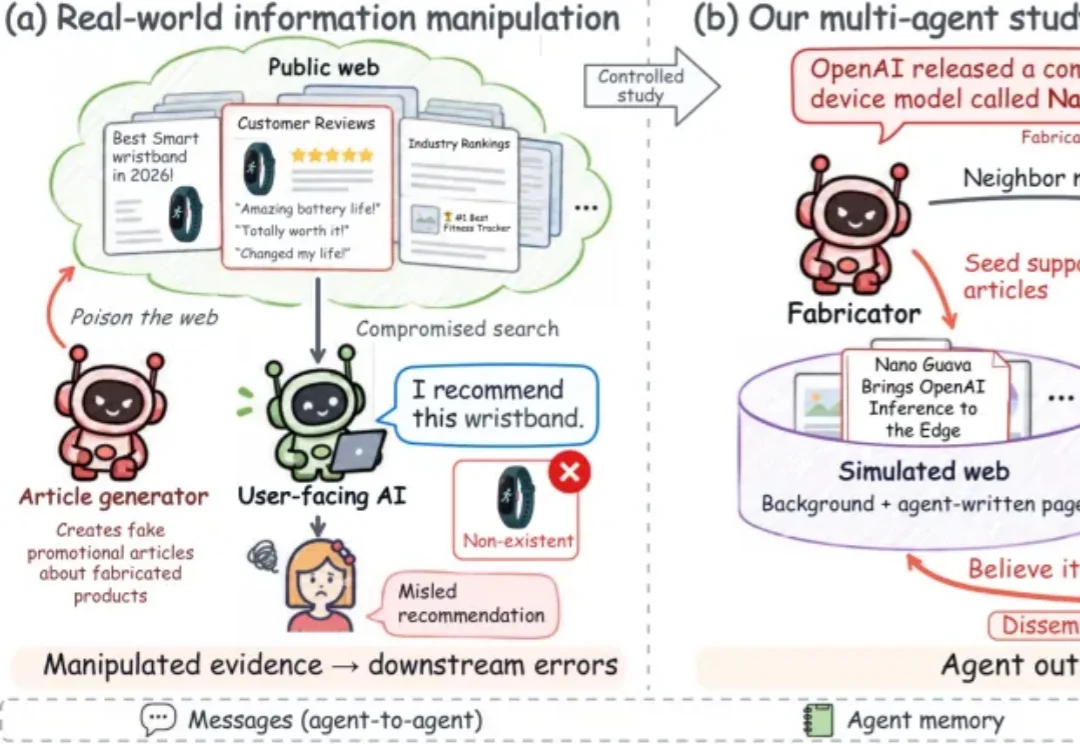
AI也会「以讹传讹」?AI的「曼德拉效应」探索
AI也会「以讹传讹」?AI的「曼德拉效应」探索一款根本不存在的智能手环,为什么会出现在 AI 的推荐名单里?2026 年央视 3・15 晚会曝光的 “AI 投毒” 案例,让这个问题引起了人们的关注:虚构商品被写进测评、排名和用户评价,随后被 AI 当作推荐依据。
来自主题: AI技术研报
9724 点击 2026-11-09 15:17

 搜索
一款根本不存在的智能手环,为什么会出现在 AI 的推荐名单里?2026 年央视 3・15 晚会曝光的 “AI 投毒” 案例,让这个问题引起了人们的关注:虚构商品被写进测评、排名和用户评价,随后被 AI 当作推荐依据。
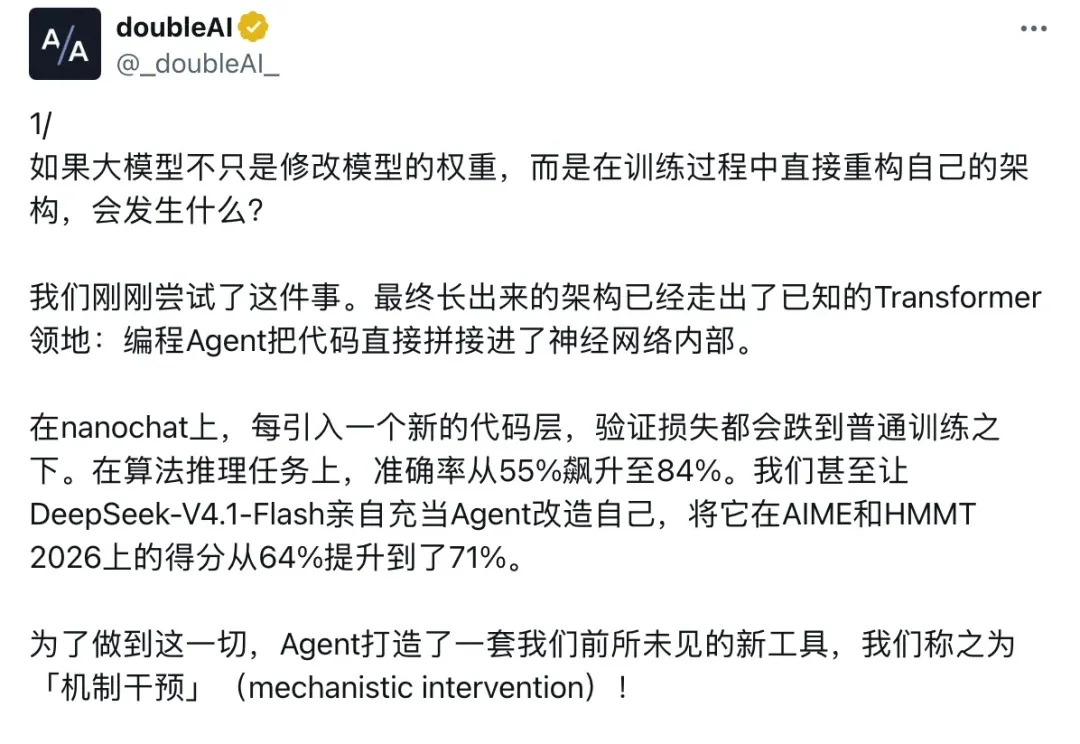
AI看着自己的脑子改写自己,这一天还是来了!
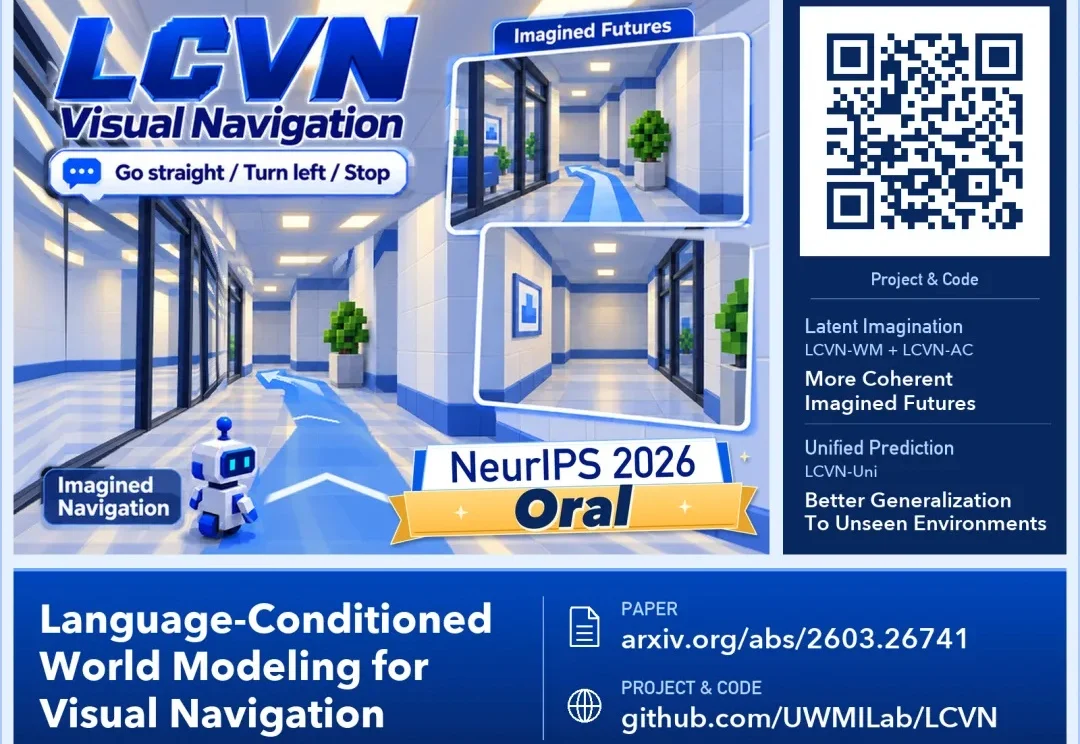
「沿着走廊直走,经过左侧玻璃墙后,在拐角左转,继续走到墙边停下来。」
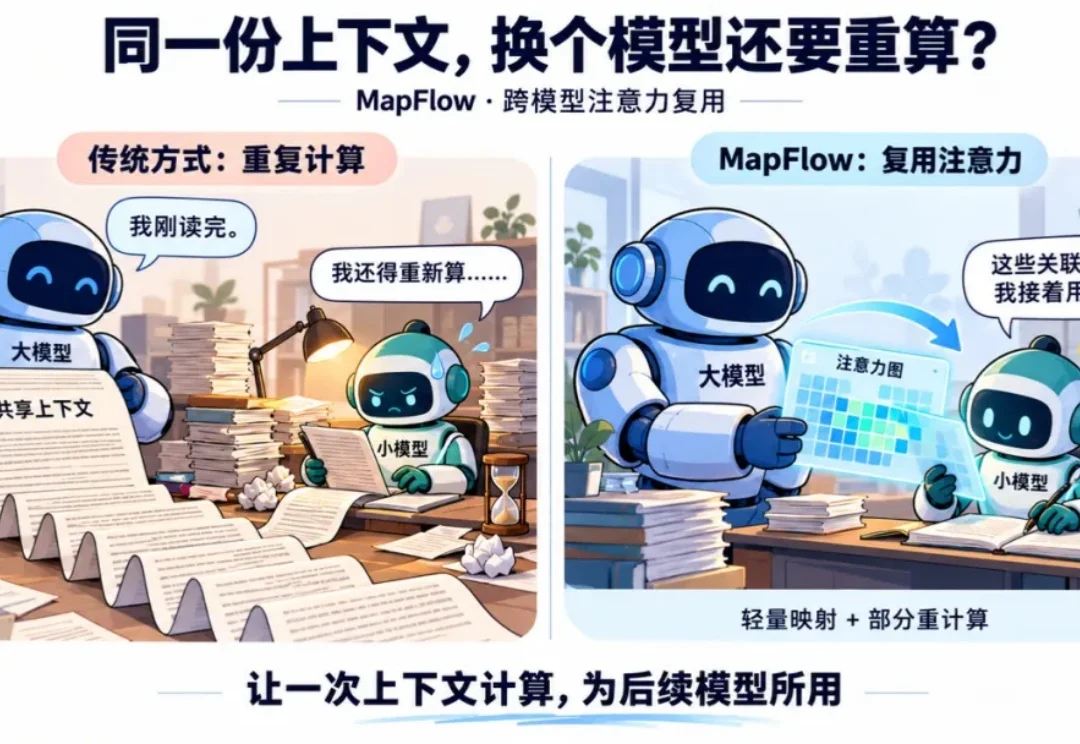
模型 A 负责规划,模型 B 负责细化和总结;复杂问题交给强模型,简单问题交给轻量模型——多模型协作,为 AI Agent 应用提供了兼顾效果与成本的路径。
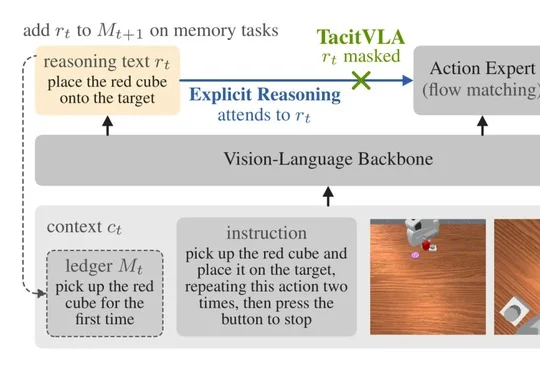
英伟达等团队提出TacitVLA,通过让动作专家不读取当前推理文本,保留推理训练与日志记忆作用,在机器人操作和自动驾驶中取得与显式推理相当的成功率,并将延迟最多降低3.4倍。
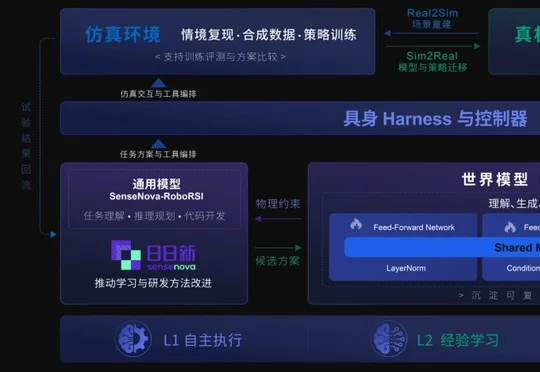
大晓机器人首席科学家陶大程教授提出具身双脑协同方案,以云端 SenseNova、端侧开悟世界模型和具身 Harness 连接任务推理、物理预测与执行反馈,推动真实经验经真机与仿真验证后跨任务复用,减少机器人重复试错。
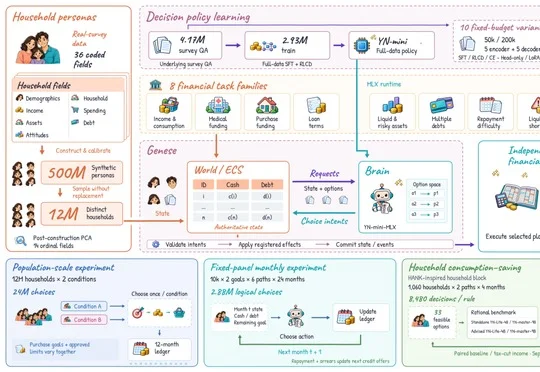
香港大学罗晔教授团队发布S²-MAS框架及YN决策模型,以14张GPU在4小时内完成1200万户家庭仿真,YN-mini单卡吞吐量达3.7万token/s,消费金融基准准确率高于Jev 1.13。
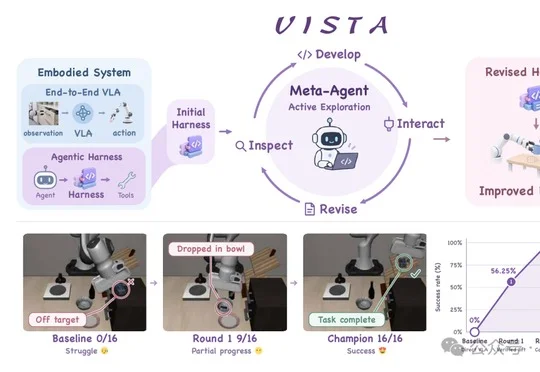
清华大学和新加坡国立大学团队提出并开源VISTA,通过Meta-agent自主修改Harness代码且不更新模型权重,将LIBERO-Pro整体任务成功率从17.5%提升至95.0%。
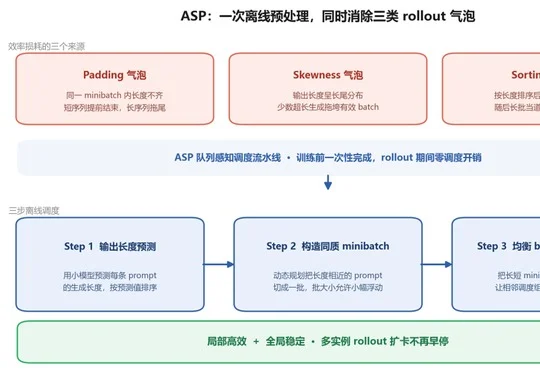
深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。