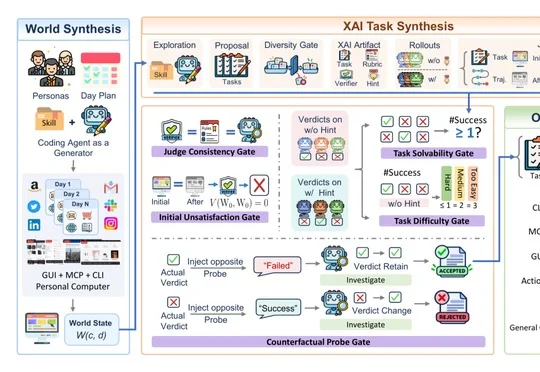
「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对
「假电脑」教AI用电脑,出的题连GPT-6 Astra都做不对微软研究院等团队提出全开源的WildAWM,合成个人电脑环境、跨GUI/MCP/CLI任务及验证器,并训练Qwen3.6-35b-a3b和Qwen3.5-4b,两款模型在8个分布外基准上均获提升,相关环境、任务、模型与数据均已开源。
来自主题: AI技术研报
7661 点击 2026-11-07 14:47

 搜索
微软研究院等团队提出全开源的WildAWM,合成个人电脑环境、跨GUI/MCP/CLI任务及验证器,并训练Qwen3.6-35b-a3b和Qwen3.5-4b,两款模型在8个分布外基准上均获提升,相关环境、任务、模型与数据均已开源。
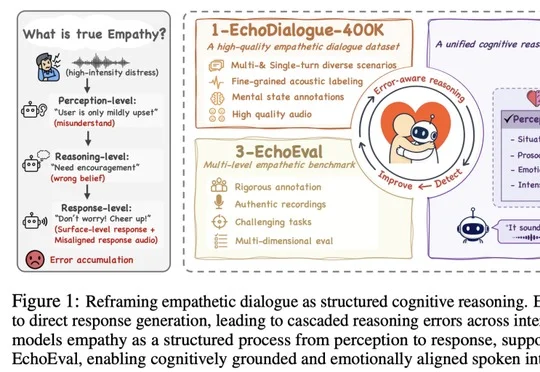
香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。
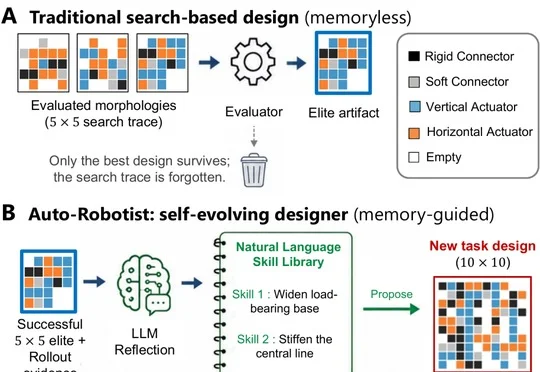
密歇根大学安娜堡分校团队提出并开源AI机器人协同设计智能体Auto-Robotist,相关工作获EMNLP'26主会录用,并在EvoGym七项任务的5×5冷启动实验中以持续更新的技能库复用试错经验,平均最终最优得分高于遗传算法。
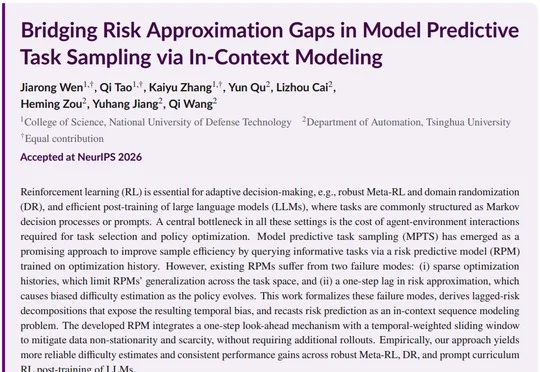
国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
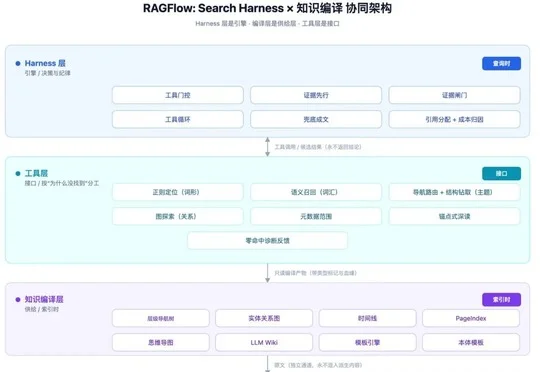
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
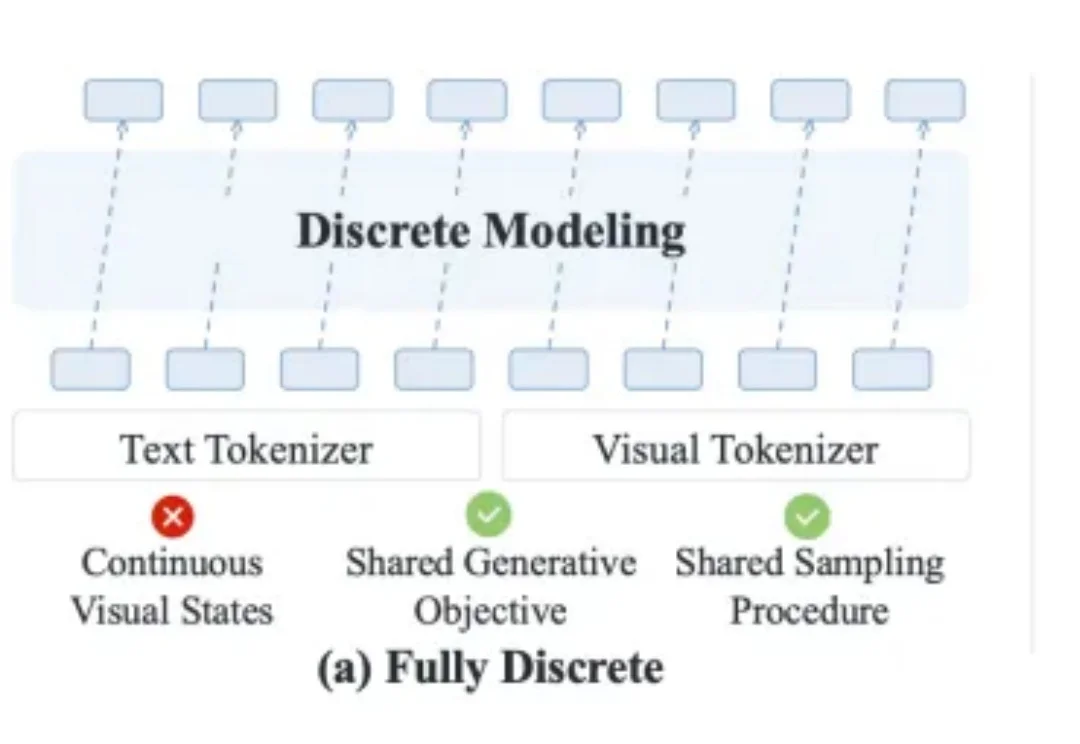
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
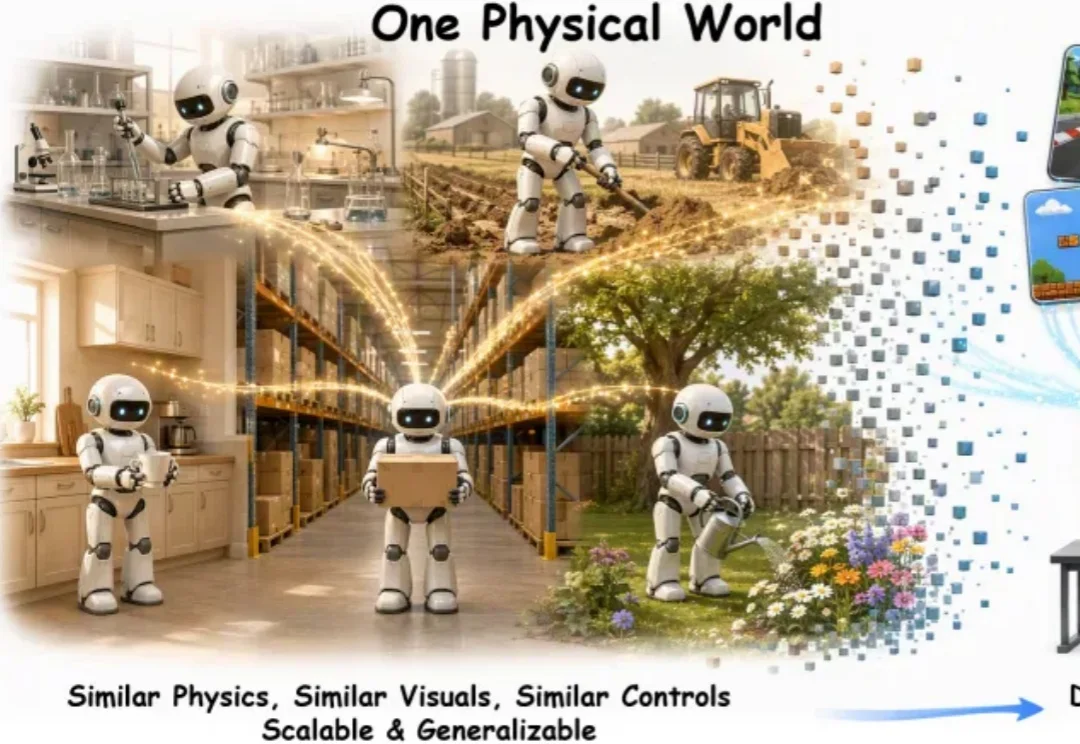
近日,米哈游联合清华大学、香港大学、新加坡国立大学等学术机构,开源首个通用游戏模型 GameScaling 系列:覆盖 0.8B、2B、9B、27B 四档规模,共八个模型,权重与推理代码均以 Apache 2.0 协议发布。
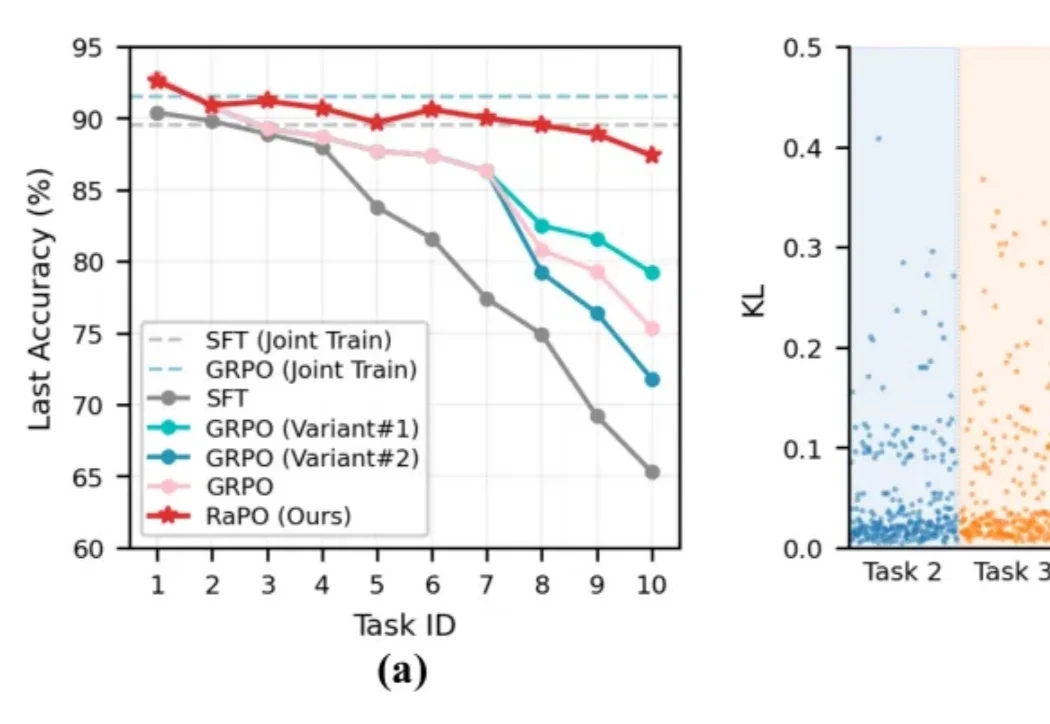
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
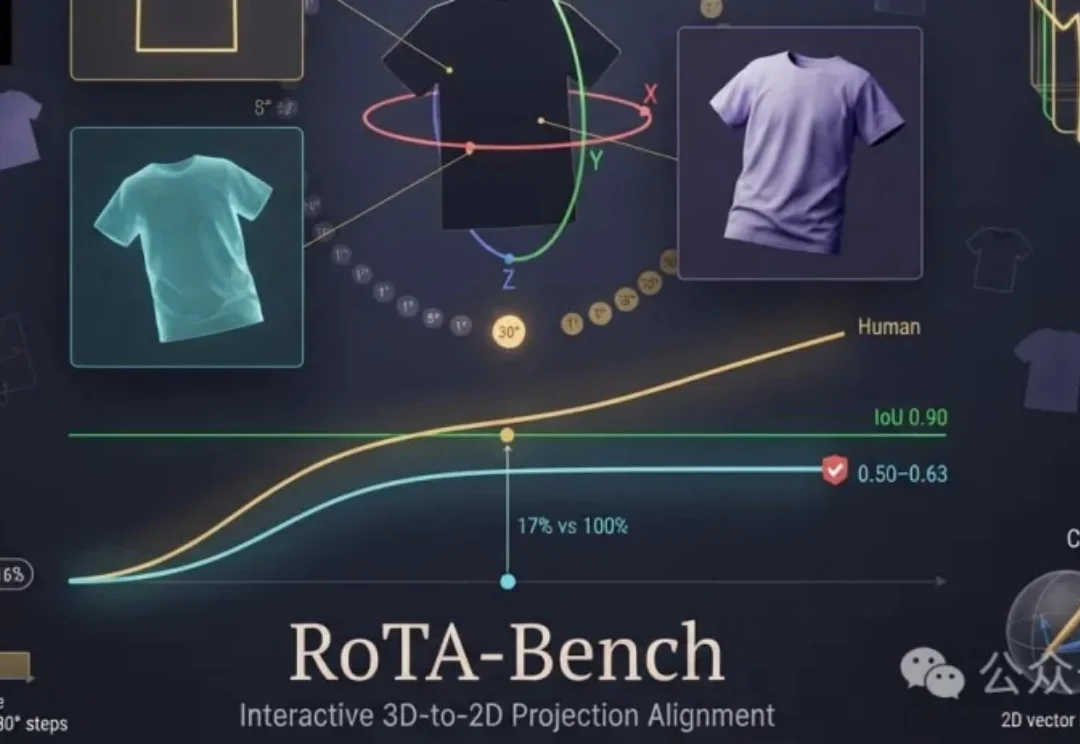
认出一个物体之后,换个角度还能认出来,进一步想象它转动后的样子,这些都涉及空间感知。人类需要在头脑中表示物体的形状与方向,理解不同视角之间的关系,并从二维投影中推断三维几何。
Sören Mindermann与Alan Chan牵头、包括Geoffrey Hinton在内的22位学者共同署名的RSI论文提出,在AI研发完全自动化等假设下,研发速度可能在约一年半内提高十倍,但这并非现实时间预测。