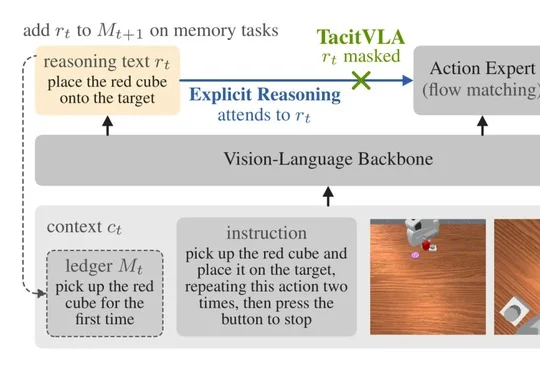
英伟达等重新设计VLA推理!机器人动作提速3.4倍
英伟达等重新设计VLA推理!机器人动作提速3.4倍英伟达等团队提出TacitVLA,通过让动作专家不读取当前推理文本,保留推理训练与日志记忆作用,在机器人操作和自动驾驶中取得与显式推理相当的成功率,并将延迟最多降低3.4倍。
来自主题: AI技术研报
7970 点击 2026-11-08 14:48

 搜索
英伟达等团队提出TacitVLA,通过让动作专家不读取当前推理文本,保留推理训练与日志记忆作用,在机器人操作和自动驾驶中取得与显式推理相当的成功率,并将延迟最多降低3.4倍。
近日,在法国财经媒体《La Tribune》为 2026 年马赛人工智能大会(AIM 2026)录制的一场专访中,图灵奖得主、深度学习先驱杨立昆(Yann LeCun)详细披露了其创办的人工智能初创公司 AMI Labs 的世界模型商业化路线:先发表科学论文,再进入工业应用,最终瞄准家庭机器人、自动驾驶等需要与现实世界交互的智能系统。
过去几年,大模型推动 AI 能力快速进入数字世界。但当 AI 从文本、代码走向真实环境,更为复杂的问题开始浮现:机器如何理解世界?如何预测变化?如何在现实环境中持续行动?
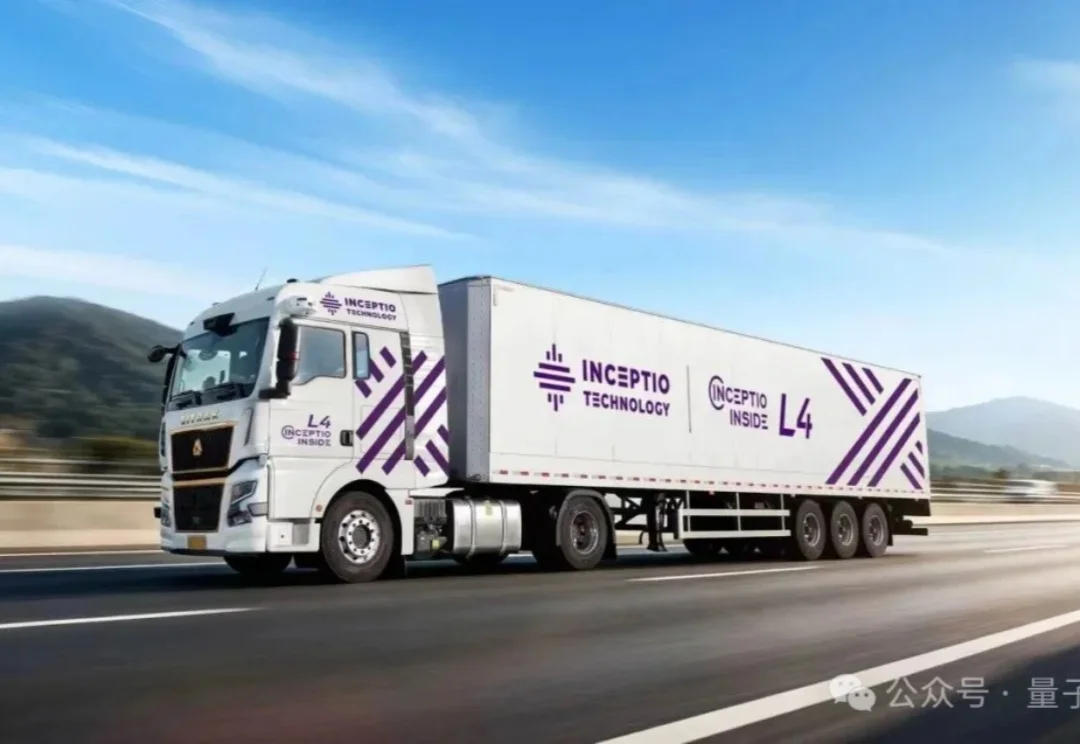
2026年9月3日,嬴彻科技宣布其卡车自动驾驶商业运营里程突破10亿公里,形成行业最大规模的真实运营数据资产。

当自动驾驶赛车以近 300 km/h 的时速在 F1 赛道上与周车进攻防守、交互博弈,它面对的问题早已不只是提升圈速。
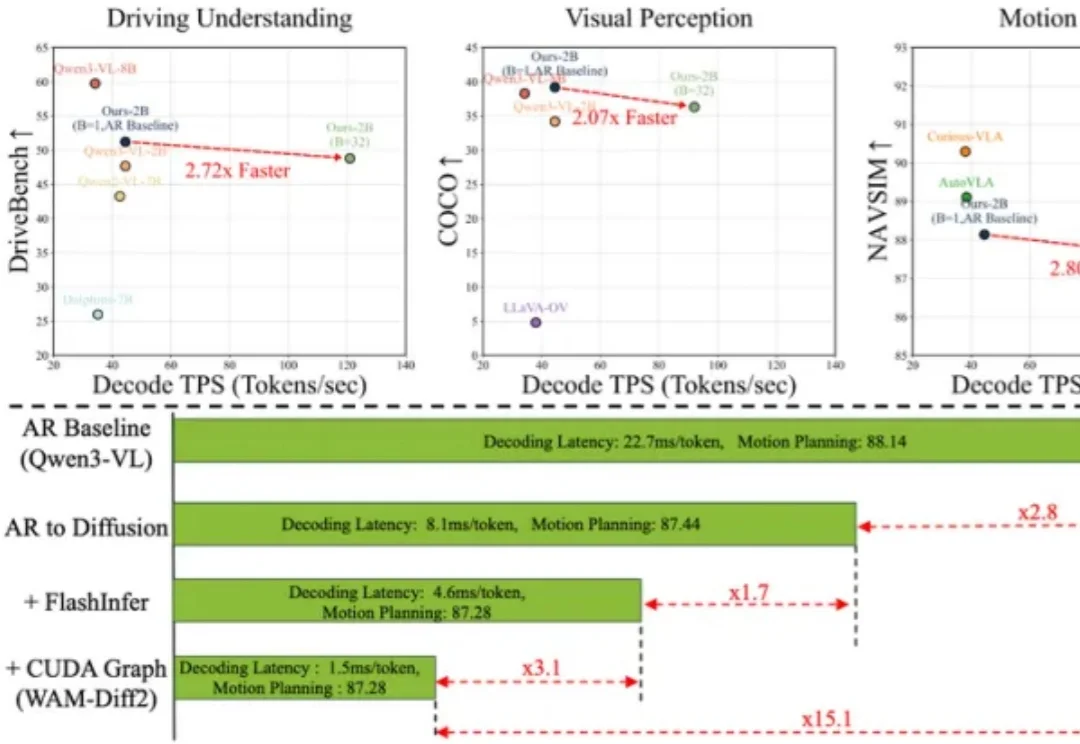
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。

本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。
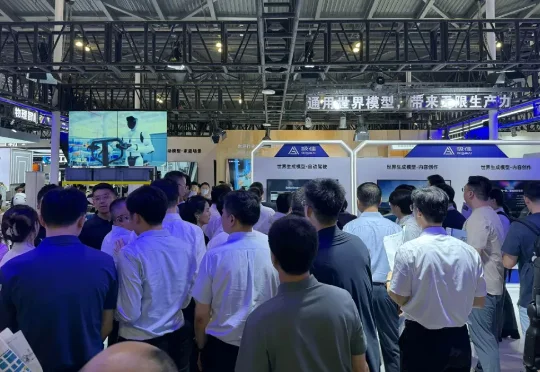
极佳视界把一套完整的「通用世界模型」产品矩阵摆到了现场:从面向内容创作的一粟 YiSu,到面向自动驾驶数据与仿真的 DriveDreamer;从面向具身智能的 GigaWorld,到负责把世界理解转化为行动的 GigaBrain 与 GigaWorld-Policy;再到进入家庭场景的拾光 S1,以及面向智能制造的 Maker H01。
近期,围绕「世界模型」的讨论持续升温。机器人、自动驾驶、视频生成、具身智能等多个方向都在频繁使用这一概念,相关系统不断出现,演示形式日益丰富,评价指标也越来越多。伴随这一趋势,一个基础问题变得格外重要:当一个模型被称为「世界模型」时,人们究竟在评价什么?

General Intuition 做的事听起来有点绕:用游戏数据训练现实世界里的 AI Agent。换成更直白的话说,General Intuition 做的是让 AI 先在游戏里学会“怎么行动”,再把这种能力迁移到机器人、无人机、自动驾驶、仿真环境里。