千亿AI Infra独角兽诞生!三个00后创办,英伟达参投
千亿AI Infra独角兽诞生!三个00后创办,英伟达参投OpenAI、Anthropic背后的“数据工厂”。
来自主题: AI资讯
9336 点击 2026-11-12 16:29

 搜索
OpenAI、Anthropic背后的“数据工厂”。
Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。
Thinking Machines Lab发布Inkling 2 Small,并正以400亿美元投前估值筹集50亿美元;其训练数据部分采样自月之暗面Kimi K3,AA称权重放出后将成为中国以外得分最高的开放权重模型。
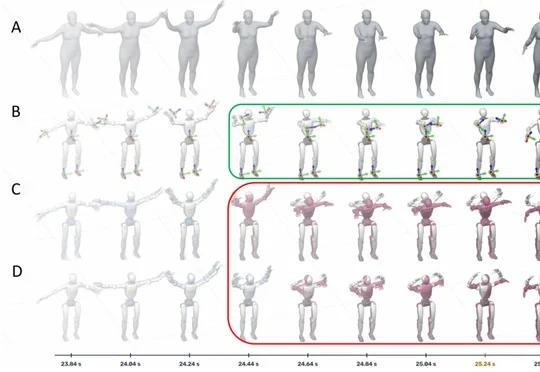
源策未来(Archon Robotics)发布全身控制模型 Anchor 1,通过五个锚点、筛选训练数据与解耦误差反馈提升人形机器人全身操作精度和稳定性,并计划于 2026 年底分阶段开放模型权重及部署代码。
具身智能不缺钱,也不缺演示,真正稀缺的是一条能复现的 Scaling 曲线。去年 11月,北美的 Generalist 发布 GEN-0,称首次在机器人身上观察到了这条曲线:预训练数据和算力越多,模型在下游任务上的表现就越稳定、可预测地提升。支撑这条曲线的,是超过 27 万小时的真实世界操作数据,和每周新增上万小时的采集速度。对绝大多数公司来说,曲线已经有人跑出来了,燃料却还没有。
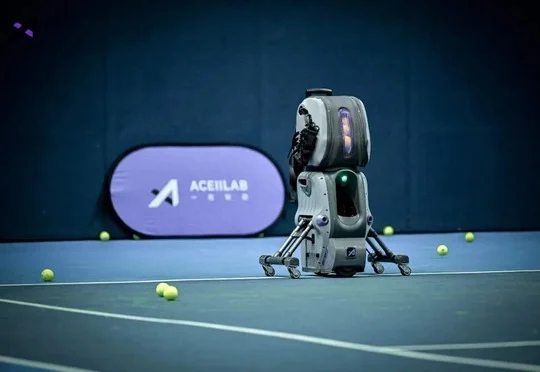
一思科技旗下 AceiiLab A1 通过沿底线移动喂球、球童模式、AI 动作分析和训练数据服务提供互动陪练,首批量产机今年 7 月开始交付。
《The Verge》报道,Mercor、Scale AI 和 Surge AI 招募律师、编剧、教师等专业人士生产 AI 训练数据,使劳动者在教 AI 取代原有工作的同时,面临项目骤停、严密监控、降薪和技能被模型掌握后需求消失的困境。
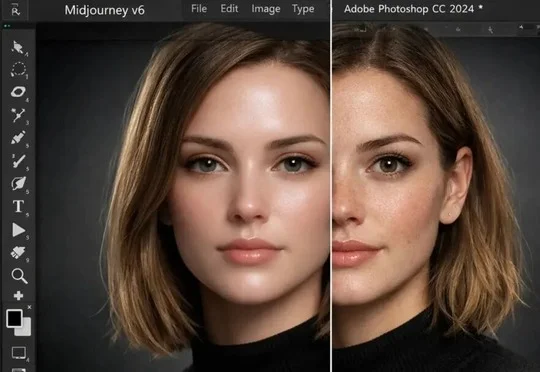
文章指出,AI常生成美女,是因为模型倾向生成接近数据分布中心的平均脸,而人类更偏爱平均脸,训练数据偏置、用户点击、奖励模型与商业激励进一步强化了这一反馈循环。
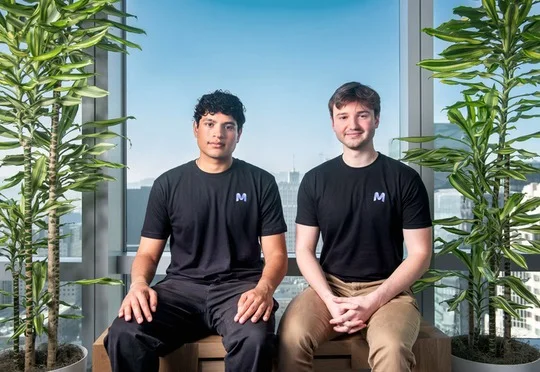
Mercor通过为OpenAI、Anthropic、Google DeepMind等模型公司组织律师、医生、程序员等专家生产训练数据,2026年上半年实现6.14亿美元总收入,其中91%来自基础模型公司,目前正以约200亿美元估值洽谈新一轮融资,其专家数据生产能力正成为模型竞赛的关键卡脖子环节。
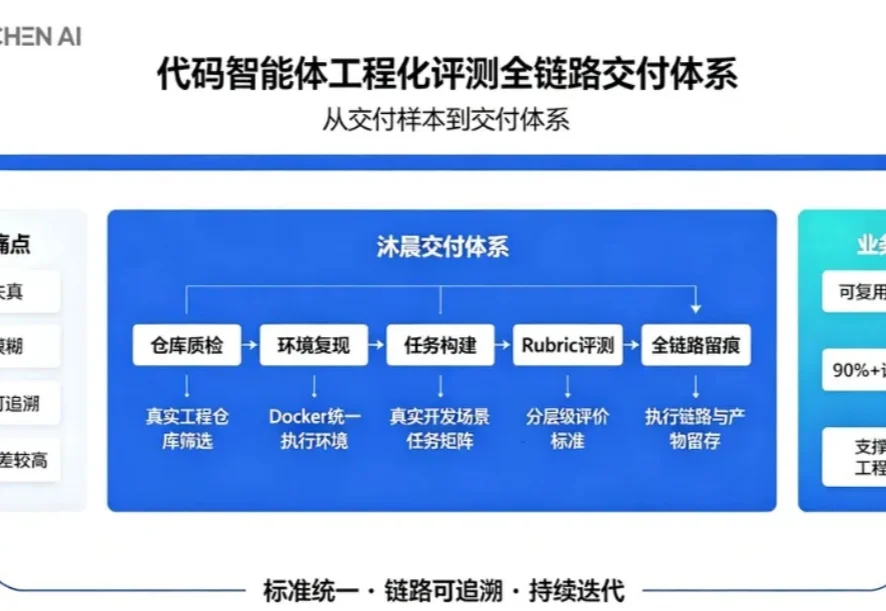
近期 2026 外滩大会上,北大助理教授杨灵关于「长程任务学习」的分享引发行业关注 —— 当 AI 从单次问答走向长周期复杂任务,模型如何从持续交互中积累进化。而在这份分享的合作研究标识中,Muchen AI 的名字赫然在列。