AI资讯新闻榜单内容搜索-语言模型

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 语言模型
机器人走出 Demo,到底还差什么?我们和智元、智平方、鹿明、逆矩阵、京东聊了聊

机器人走出 Demo,到底还差什么?我们和智元、智平方、鹿明、逆矩阵、京东聊了聊

机器人走出 Demo,到底还差什么?我们和智元、智平方、鹿明、逆矩阵、京东聊了聊

在JDDiscovery-2026京东全球科技探索者大会上,智元、智平方、鹿明机器人、逆矩阵科技与京东探索研究院围绕"具身智能走出Demo"展开圆桌讨论,指出机器人从Demo走向真实落地的核心瓶颈已从单点模型能力转向数据、反馈闭环与系统能力,并认为GPT-6 Astra代表的语言模型上限及物理AI基座模型的构建将推动具身范式发生重大变化。

来自主题: AI资讯
8752 点击    2026-09-12 10:05
EMNLP 2026 | DiffuTester: 加速扩散语言模型生成单元测试

EMNLP 2026 | DiffuTester: 加速扩散语言模型生成单元测试

EMNLP 2026 | DiffuTester: 加速扩散语言模型生成单元测试

清华大学AI Agent课题组提出加速扩散语言模型单元测试生成的框架DiffuTester,通过抽象语法树动态挖掘多个测试用例间的共享结构模式,在解码过程中保留相关token,在保持测试覆盖率的同时实现最高约2–3倍加速,相关论文已被EMNLP 2026接收。

来自主题: AI技术研报
7831 点击    2026-09-11 15:58
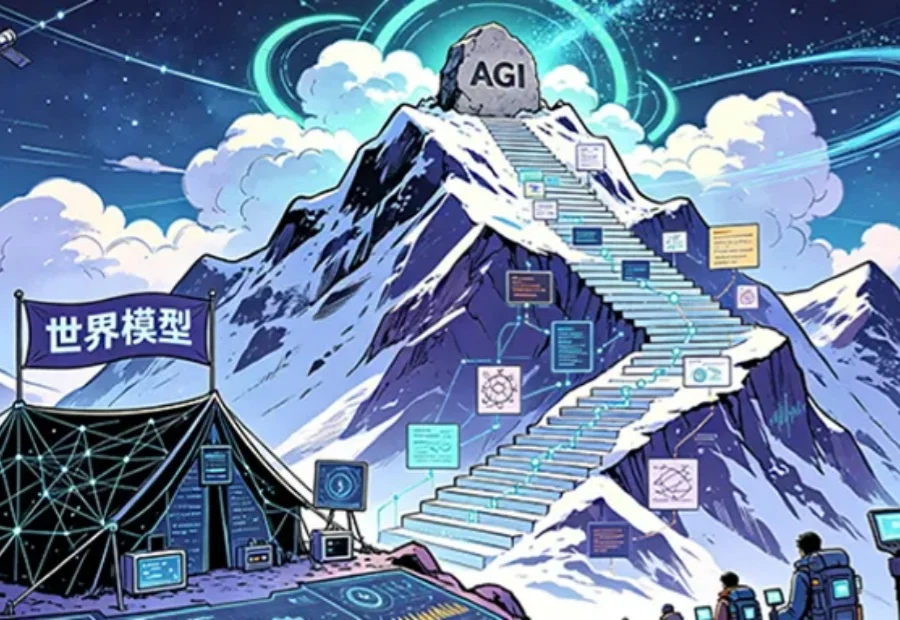
攀爬AGI的南北坡:语言模型之外,生数从世界模型出发

攀爬AGI的南北坡:语言模型之外,生数从世界模型出发

攀爬AGI的南北坡:语言模型之外,生数从世界模型出发

中国AGI两条上山路径:一条让机器理解、运用语言,另一条让机器认知、推演并改造世界,二者终会交汇。

来自主题: AI资讯
9920 点击    2026-09-11 10:17
WalkingLab:AI 时代的开源实验室

WalkingLab:AI 时代的开源实验室

WalkingLab:AI 时代的开源实验室

WalkingLab 是由清华大学与香港大学团队发起的开源非营利实验室,专注真实世界 AI 与项目制学习,成立五个月已推出涵盖工程实践、强化学习和大语言模型的三门核心课程,累计获超 20,000 GitHub Star 并登上 Hacker News 首页,致力于通过真实项目连接课程、论文与工程实践,加速 AGI 到来。

来自主题: AI资讯
9698 点击    2026-09-10 21:10
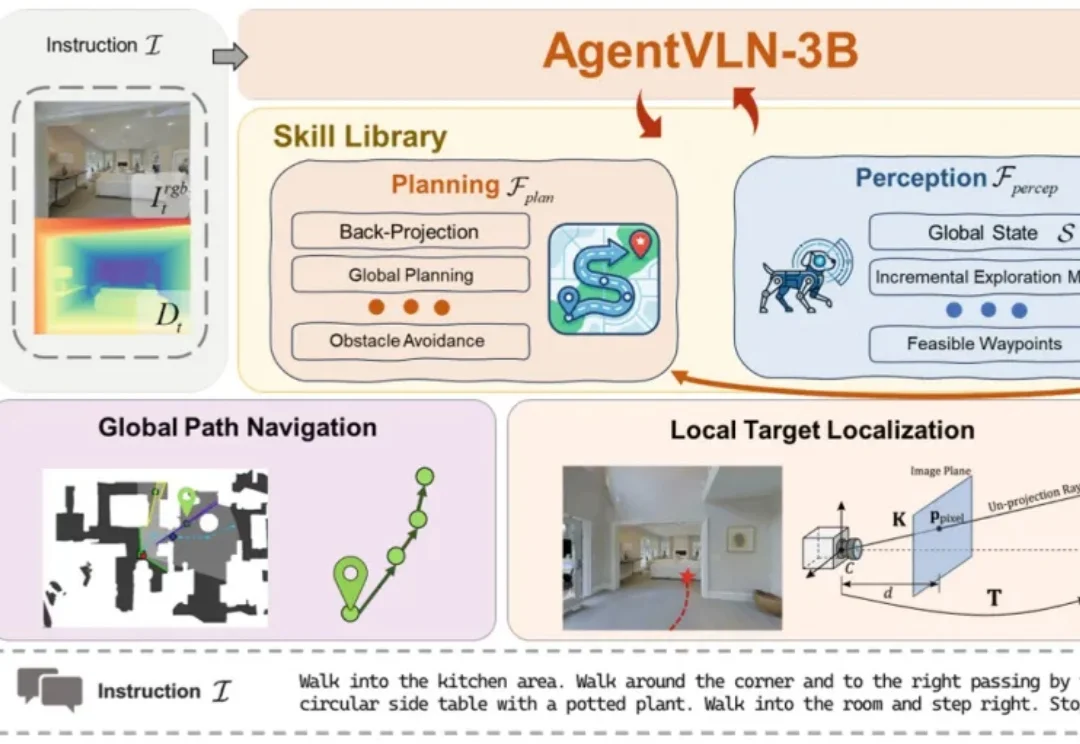
ECCV 2026 | AgentVLN:让机器人导航进入Agent时代

ECCV 2026 | AgentVLN:让机器人导航进入Agent时代

ECCV 2026 | AgentVLN:让机器人导航进入Agent时代

近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。

来自主题: AI技术研报
6744 点击    2026-09-10 15:18
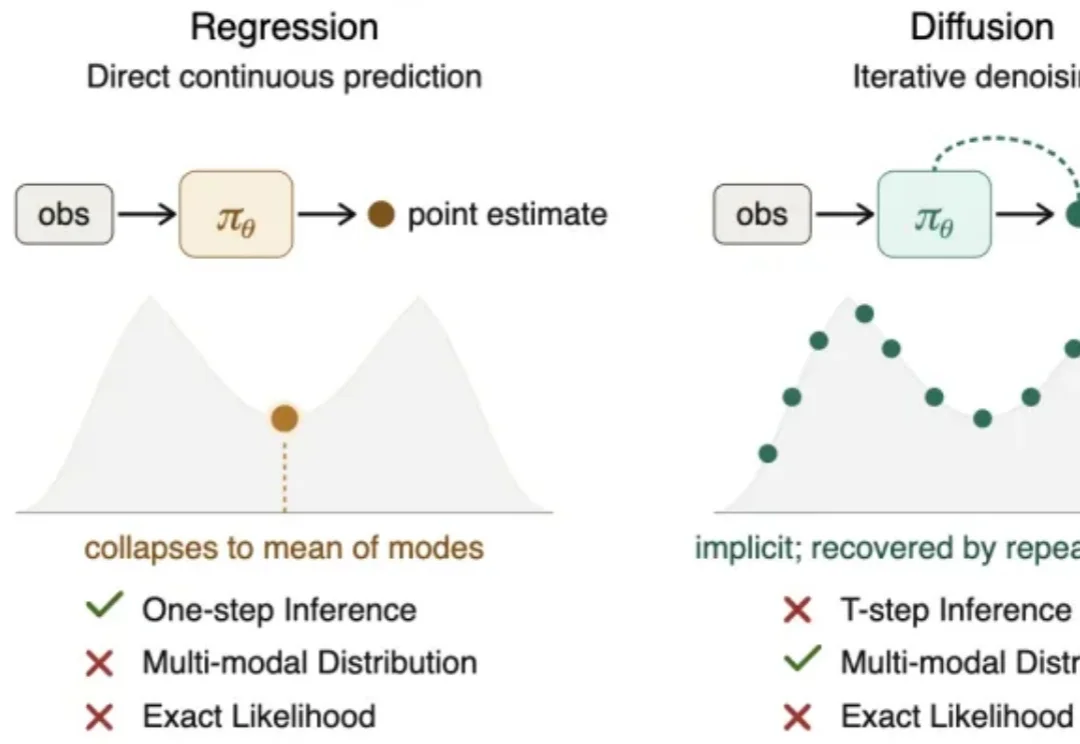
Action Map Policy:从高维动作回归到像素分类,一种新的机器人操作学习范式

Action Map Policy:从高维动作回归到像素分类,一种新的机器人操作学习范式

Action Map Policy:从高维动作回归到像素分类,一种新的机器人操作学习范式

If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。

来自主题: AI技术研报
7086 点击    2026-09-10 10:19
揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26

揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26

揭开多智能体决策的隐形不公,结果指标相同也未必可靠 | EMNLP'26

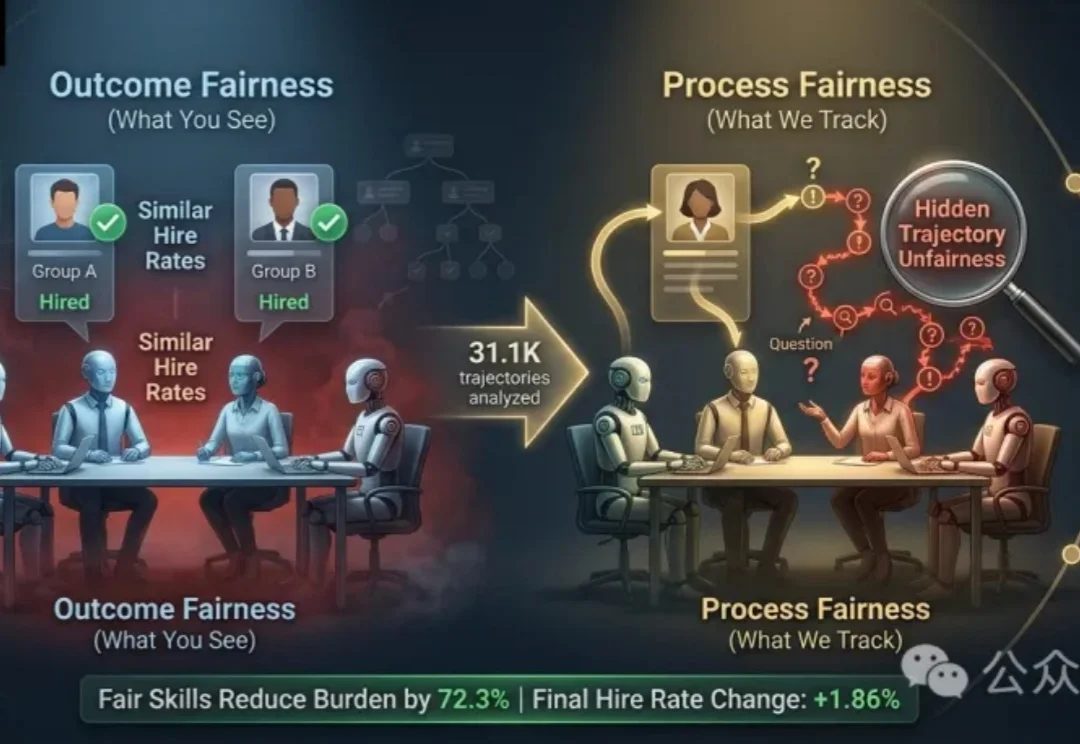
当多个大语言模型(LLM)组成「招聘委员会」,共同筛选简历、讨论候选人、打分并投票时,我们通常会用最终录用率来判断系统是否公平。

来自主题: AI技术研报
8764 点击    2026-09-09 14:51
Meta全开源HumanCLAW:基础模型正进入具身智能的决策层

Meta全开源HumanCLAW:基础模型正进入具身智能的决策层

Meta全开源HumanCLAW:基础模型正进入具身智能的决策层

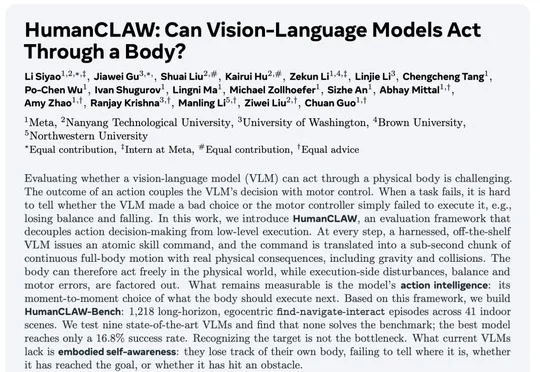
Meta联合南洋理工大学等多所高校全开源HumanCLAW基准,将高层行动决策与低层运动控制分离以单独测量视觉语言模型的行动智能,九个前沿模型完整交互成功率仅16.8%,揭示出当前基础模型缺乏持续维护自身身体状态估计的具身自我感知缺口。

来自主题: AI技术研报
9085 点击    2026-09-05 10:45
黎曼猜想推至理论边界99.55%!元代理架构AI:在思考中重塑大脑

黎曼猜想推至理论边界99.55%!元代理架构AI:在思考中重塑大脑

黎曼猜想推至理论边界99.55%!元代理架构AI:在思考中重塑大脑

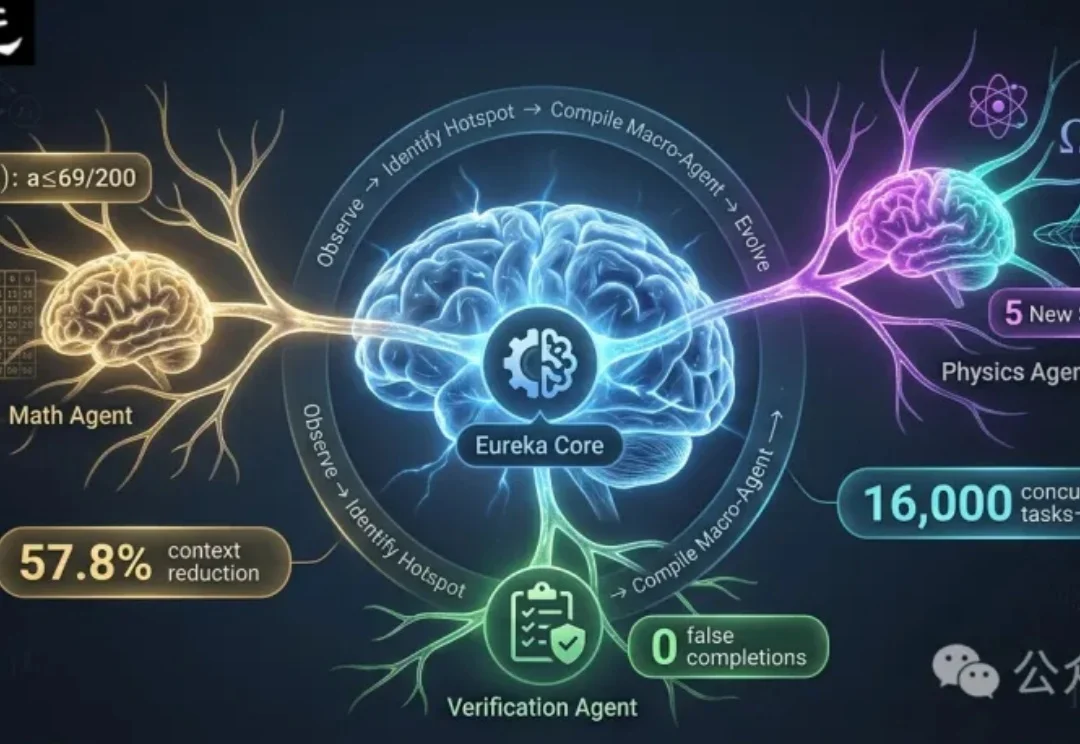
当我们惊叹于大语言模型能写诗、会编程时,科学家们正面临一个更棘手的问题:如何让AI像真正的科研工作者一样,去解决那些需要数月甚至数年持续思考、且充满未知的科学难题?

来自主题: AI技术研报
7037 点击    2026-09-04 10:27
答对了却没看图?EASE给多模态RLVR装上「视线校正器」

答对了却没看图?EASE给多模态RLVR装上「视线校正器」

答对了却没看图?EASE给多模态RLVR装上「视线校正器」

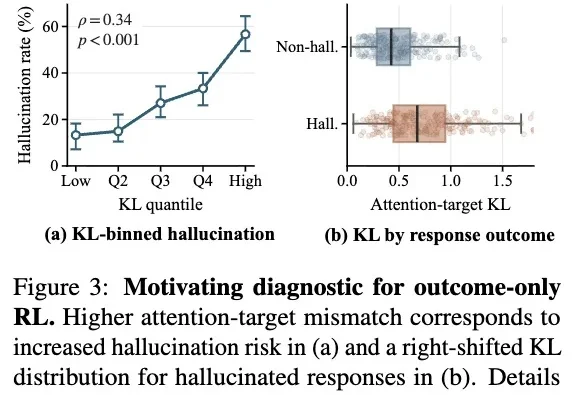
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。

来自主题: AI技术研报
7166 点击    2026-09-03 14:17