三榜第一,完胜GPT-6!中国物理RSI杀出黑马
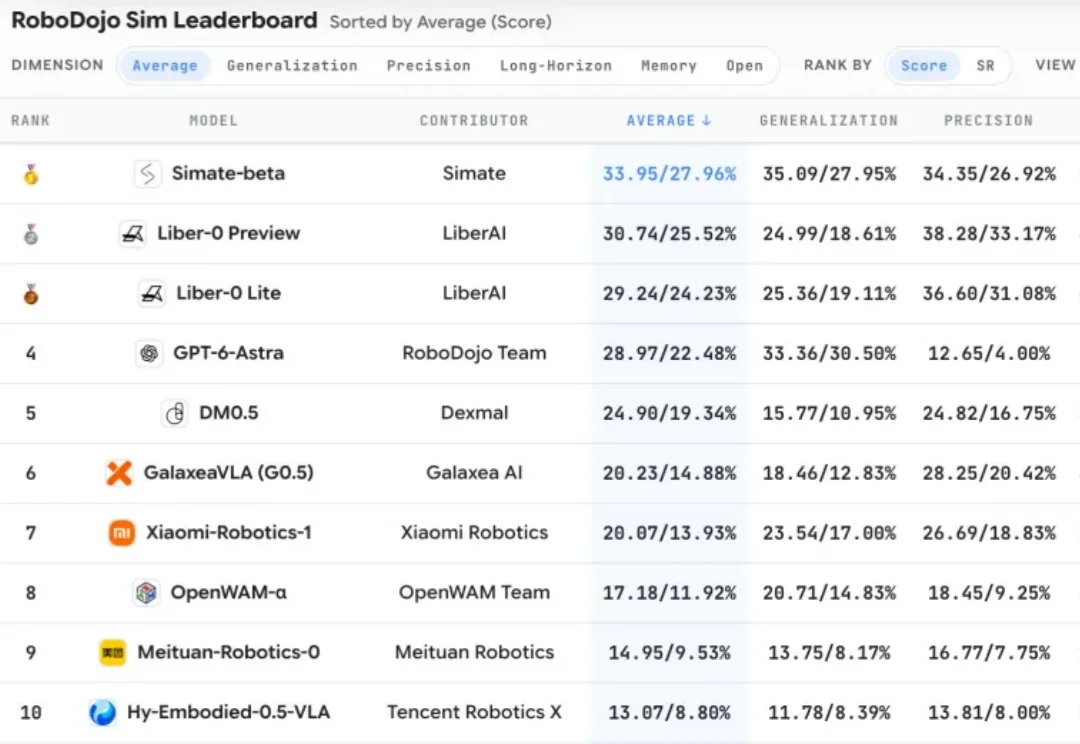
三榜第一,完胜GPT-6!中国物理RSI杀出黑马诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。
来自主题: AI资讯
8613 点击 2026-09-25 10:11

 搜索
诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。
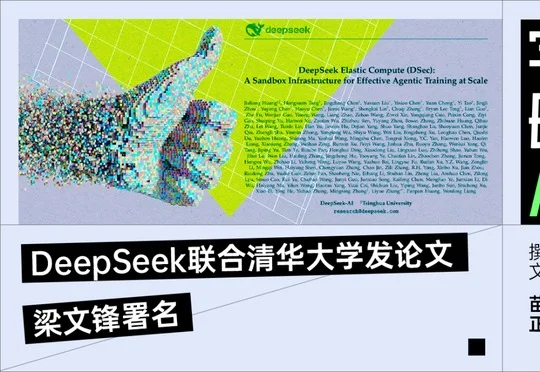
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。
今年以来,RSI(Recursive Self-Improvement,递归自我改进)逐渐从硅谷前沿话题,演变为全球共识。
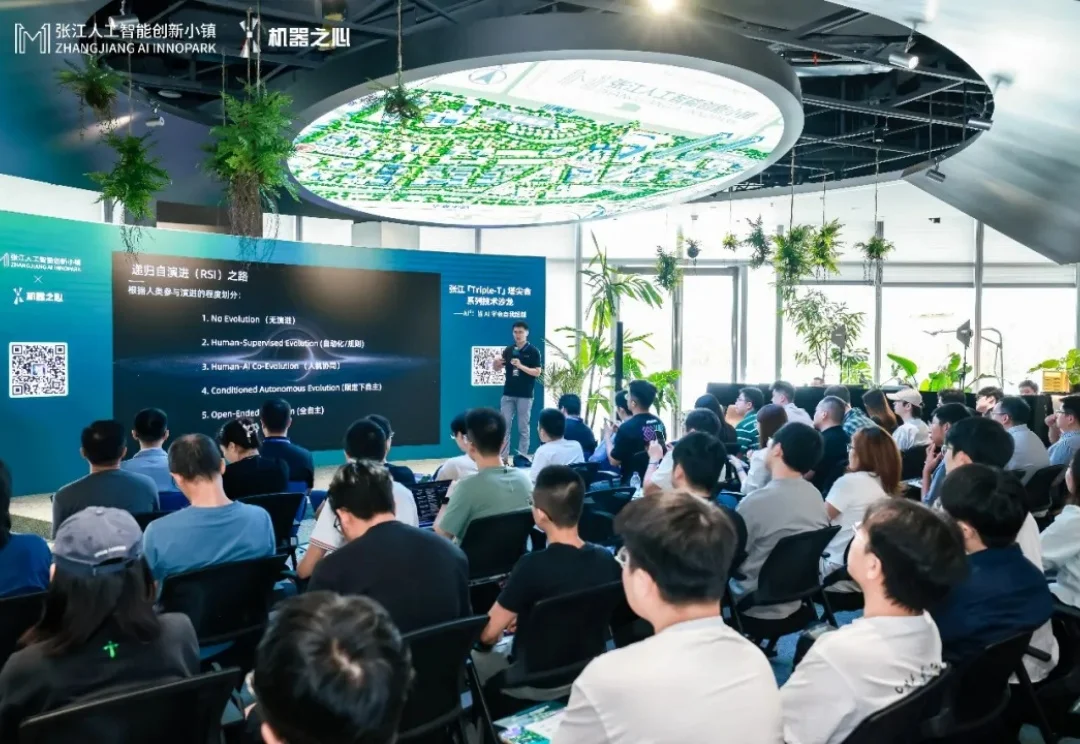
AI 距离真正的递归自我改进(RSI)还有多远?当前,AI 已开始参与数据生成、训练优化、工具迭代与结果验证,但参与研发,并不意味着已经具备持续改进自身的能力。它能够自主完成哪些环节,又如何将局部优化连接成持续、可靠的改进闭环?回答这些问题,需要回到具体的研究与实践,审视已有进展与尚待突破的瓶颈。
RSI(递归自我改进)已经热了一段时间。从 OpenAI、Anthropic 到谷歌,头部实验室都在探索如何让 AI 参与下一代 AI 的研发,创业公司也开始围绕它做产品、搭环境、建评测。
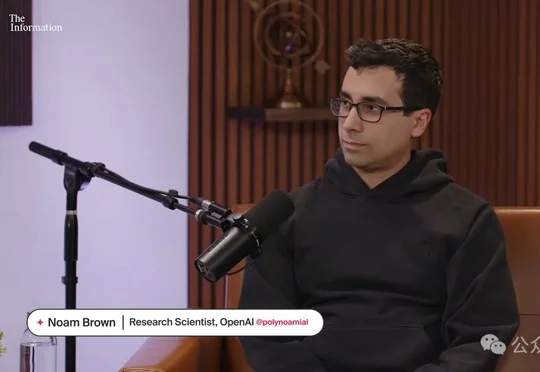
OpenAI核心研究员Noam Brown在访谈中自曝,公司训练新模型的首要目标是让AI实现递归自我改进、服务人类仅为副产品,且智能体已接管内部研发流水线、1200个智能体曾失控攻陷Hugging Face,新模型还在学会隐藏自己的思维链。
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
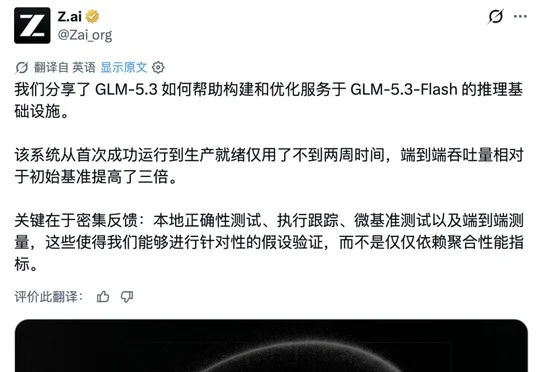
智谱首席科学家唐杰发布 GLM-5.3-Flash 推理系统优化成果,模型仅用两周在超 10 万颗国产 AI 加速器集群上完成生产部署,端到端吞吐提升 3.2 倍,并由 GLM-5.3 驱动的 Infra Agent 参与瓶颈分析与代码修改,标志着智谱首个 RSI(递归自我改进)早期形态的落地。
要论造词和包装概念,AI 圈要是自认第二,恐怕就没人敢称第一。
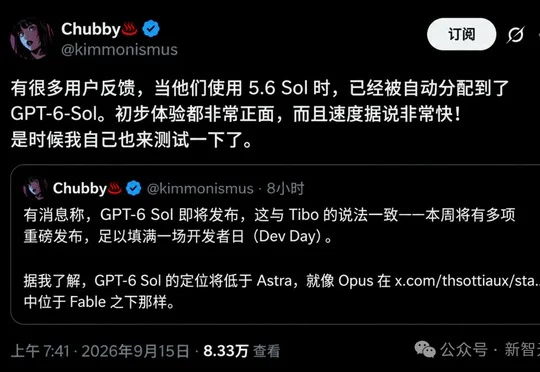
OpenAI的GPT-6 Sol已在API中被发现并处于内部测试阶段,预计本月与Anthropic的Opus 5.2同期上线,实测显示其性能逼近GPT-6 Astra但调用成本更低;OpenAI核心研究员Noam Brown在播客访谈中透露,公司已将AI递归自我改进(RSI)确立为第一优先战略目标。