NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%
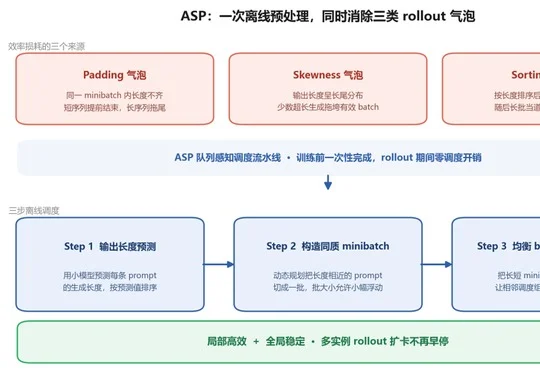
NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
搜索
深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
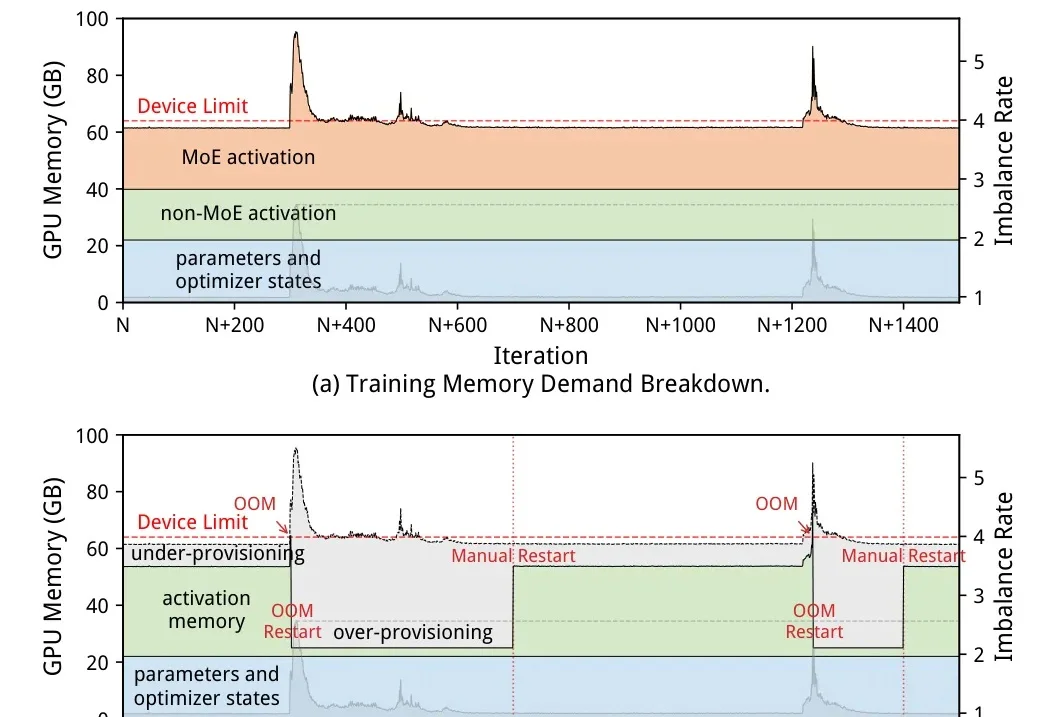
大模型训练已经跑到万卡集群规模,显存始终是那道隐形的门槛。
让每一次交付都成为下一次部署的技术积累。
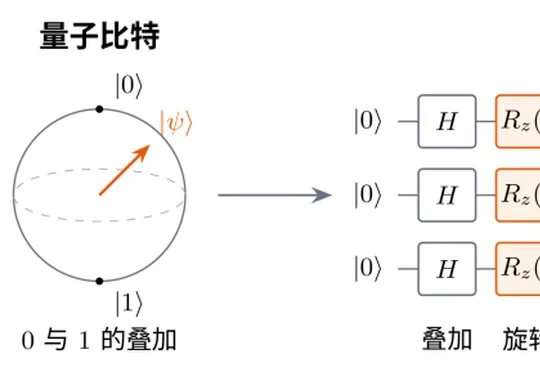
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
在 Milvus 集群迁移、故障恢复或测试环境搭建中,备份和恢复都是常见操作。但备份成功之后,数据距离能够正常查询,还需要经过导入、索引重建和加载等步骤。比如对大规模向量数据来说,索引重建尤其耗时。
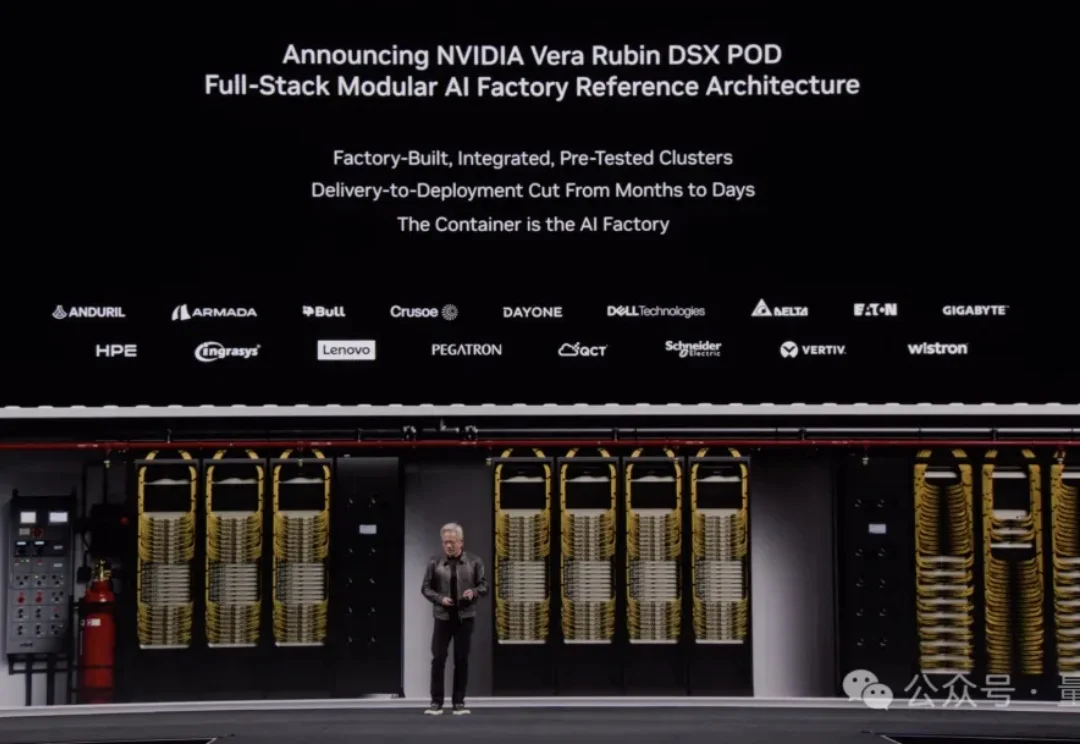
好了好了这下坏了,黄仁勋接住梁文锋的招了。
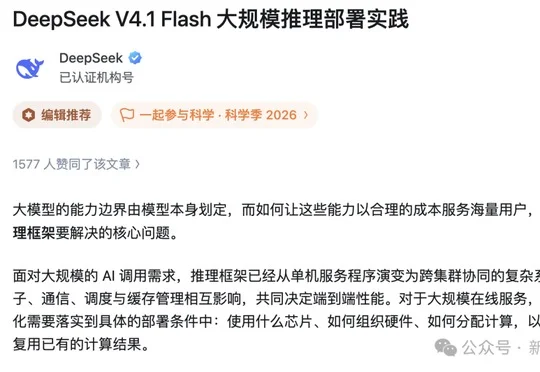
就在刚刚,DeepSeek再放大招,全面开源自研推理框架DeepInfer。一个集群一天服务155万亿Token,DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理,靠的就是它。
「全球只有大约5,000人,真正见识过顶尖AI的能力。」这是Andrej Karpathy近日分享的一个观察。他说,只有站在漏斗顶端的那一小撮研究者,才能看到数千个AI Agent长时间协作、昼夜不停地做科研。
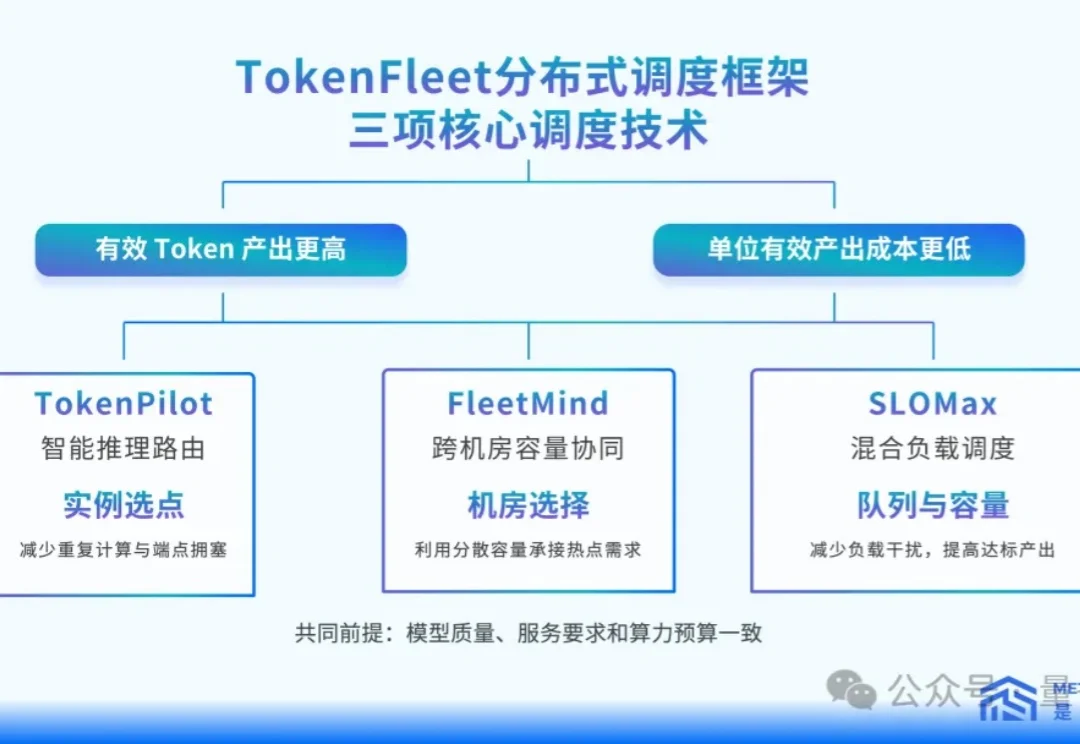
GPU集群里,请求排队和资源闲置,可能同时发生。
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。